推理与服务
共 540 个仓库 · 近 4 个月有推送
把 IP:Port 快速识别成 Ollama、vLLM、LiteLLM 等 60 多种大模型推理服务,用于资产测绘和攻击面排查。
用本地或已有的 LLM 整本翻译电子书,支持 EPUB 双语对照输出,省去逐章手工翻译的麻烦。
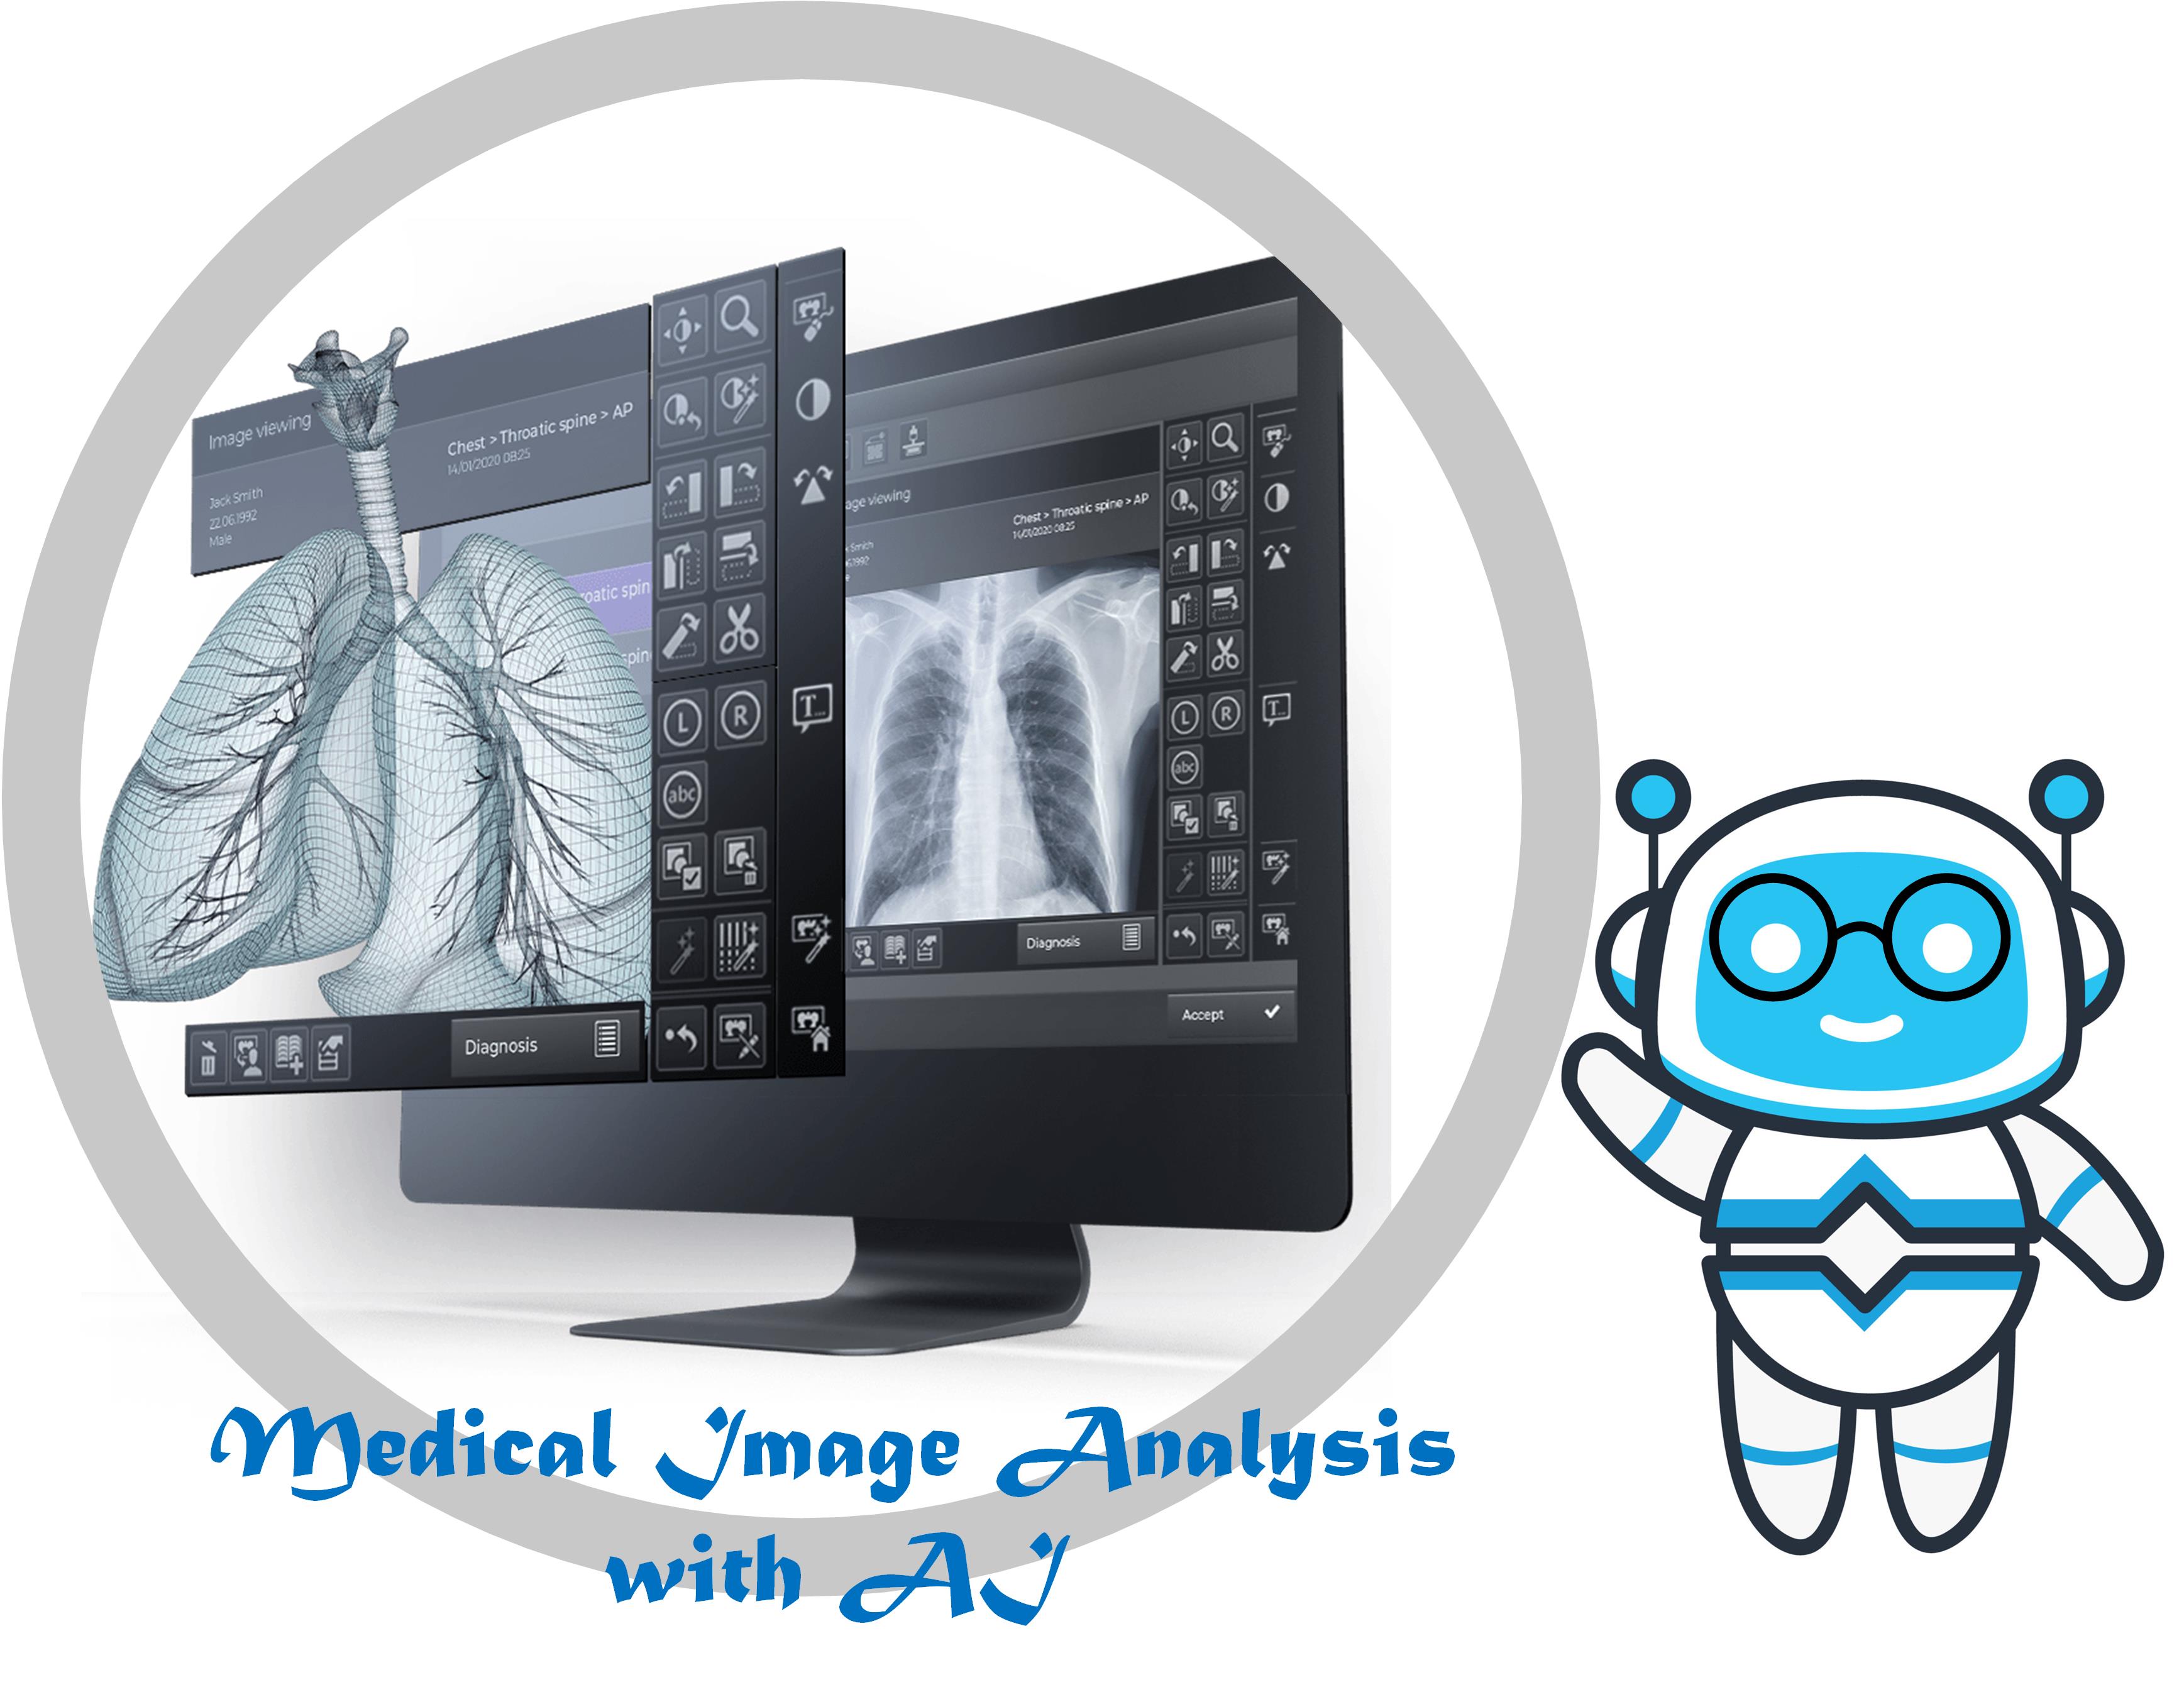
基于基础模型的医学图像分析代码库,涵盖MAE预训练、Mamba状态空间模型、视觉语言模型与医学报告生成,为医学影像研究提供可复用的模型实现。
一个聚合多家大模型与云厂商的 AI 能力网关,除聊天补全外还统一提供文本向量化、语音识别合成、文生图等接口,并内置计费、限流和资源管理。
可自部署的 AI 长期记忆与聊天网关,为多轮对话保存跨会话记忆,并统一接入和路由各家大模型。
在单台桌面机器上跑 100GB 级大模型的开源推理引擎,支持 AMD Strix Halo、NVIDIA RTX 和 Apple Mac,兼容 OpenAI API,基于 ExLlamaV3 构建。
一个统一 API 网关,用一把密钥调用 Claude、GPT、Gemini、Grok、DeepSeek 等多家模型,并提供无审查、去对齐变体,兼容 OpenAI 与 Anthropic 接口,按 token 计费。
纯浏览器端运行的极简 AI 对话界面,可对接 llama.cpp、Ollama、vLLM 和 OpenAI 兼容接口,省去本地部署 WebUI 的麻烦。

面向 LLM 推理的高性能 KV cache 存储层,通过 GPU 卸载、SSD 缓存和 RDMA 跨节点共享,缓解长上下文推理的显存瓶颈,兼容 vLLM 与 SGLang。
面向 AI Agent 的执行控制平面,统一管控模型请求、MCP 工具调用、A2A 委派和下游动作,同时保持原生 LLM 协议不变,支持多模型接入与故障切换。
基于 ReAct 推理-行动循环的 RAG 问答系统,支持多跳推理,用 Weaviate 检索、重排序和 FastAPI 服务搭建智能问答后端。
面向 ROS2 机器人的 GPU 加速目标检测包,基于 TensorRT 和 Triton 推理深度学习模型,可在 Jetson 上实时运行。