模型工具链
共 232 个仓库
在 RK3588 等瑞芯微芯片上快速装好并调用 NPU 的脚本工具,省去手动配置驱动和运行环境的麻烦,方便直接跑神经网络和 LLM 推理。
基于 ViTPose 的 2D 人体与动物多姿态估计工具,支持 ONNX、TensorRT 加速,可实时输出多种骨架格式。
用 Python 把多路视频流、多个模型和多块 GPU 串起来做实时视频分析,底层靠 CUDA、TensorRT 和 DeepStream 加速,适合搭建高吞吐的视觉推理流水线。
用 Rust + CUDA 写的 SSD 流式推理引擎,让消费级 16GB 显卡也能跑 743B 级 MoE 大模型,自动测 PCIe 带宽并分配注意力与热专家。
基于 C++/CUDA 的高性能 SDK,把音频实时驱动成 3D 面部表情和口型,内置后处理,适合做虚拟人、数字主播这类实时动画。
面向 Apple Silicon 的自适应混合精度量化与推理运行时,把 GGUF 模型转成 MLX 可用格式,让 Mac 上跑大模型更省显存。
用 LoRA/QLoRA 微调大模型,并借助思维链数据生成与蒸馏提升推理准确率,适合低成本定制模型。
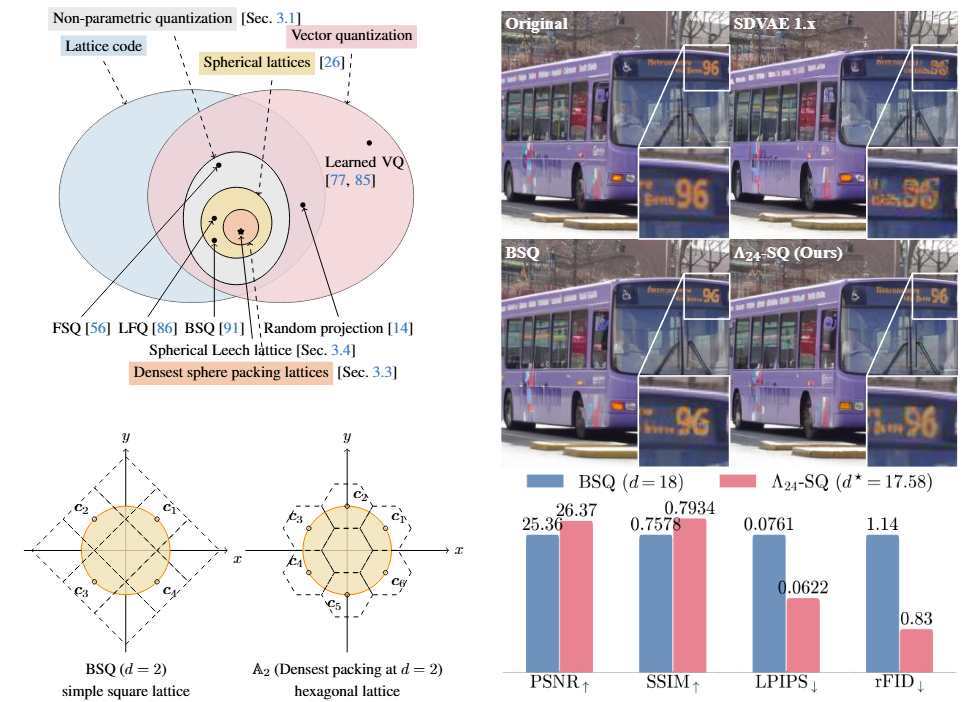
面向视觉 tokenizer 的球面量化方案,包含二值球面量化和 Leech 球面量化两种方法,用于压缩视觉 token 并提升表示效率。
Rust 原生本地推理后端,支持 GGUF 模型和量化,在 Apple Silicon 与 Windows 上跑 LLM,并提供 OpenAI 兼容接口。
ONNXim 是一个周期级多核 NPU 模拟器,能快速仿真 DNN 推理在 NPU 上的执行过程,帮助评估和优化硬件设计。

给 Linux 和 macOS 用的开源 AI 摄像头与麦克风增强工具,能实现背景虚化、自动取景、降噪、录制和本地会议转写,相当于把 NVIDIA Broadcast 那套效果搬到了非 Windows 平台。
整理扩散模型高效化方向的论文与代码合集,覆盖图像、视频、世界模型和语言生成,聚焦加速、量化、压缩、缓存与蒸馏。
用能量参与比方法自动分析和设计量子微波芯片与器件,把超导量子电路的设计流程从手工仿真变成脚本化计算。
在 Android 手机上搭建完整的编程环境,可直接创建、编写并编译基于 Gradle 或 Flutter 的安卓项目,也支持 Rust、Python、TypeScript 和 Web 项目。
汇总 token 级模型压缩相关论文与资源,涵盖 token 剪枝、合并等加速方法,方便快速查找视觉与深度学习模型压缩方向的研究资料。
基于特征基旋转和水填充比特分配的 KV-Cache 量化压缩方案,用于降低大模型推理时的显存占用。