多模态生成
共 261 个仓库 · 近 4 个月有推送

汇集 AI 工具、实用程序和资源的精选清单,帮开发者和创作者快速找到智能体框架、提示工程、文生视频等方向的现成方案。
汇总自动驾驶领域的视觉-语言-动作(VLA)模型资源,梳理其发展脉络与未来方向,方便快速了解该方向的研究与落地进展。

在多种虚拟游戏世界中继续预训练视觉语言模型,打造能跨游戏泛化的具身智能体,并公开模型权重。
ComfyUI 的本地短剧与长视频生成插件,基于 MiniMax H3 工作流实现无限时长视频,支持文生视频和图生视频。
把想法和素材交给 AI 导演智能体,自动生成生动的讲解视频,支持本地优先运行并自由接入任意模型。
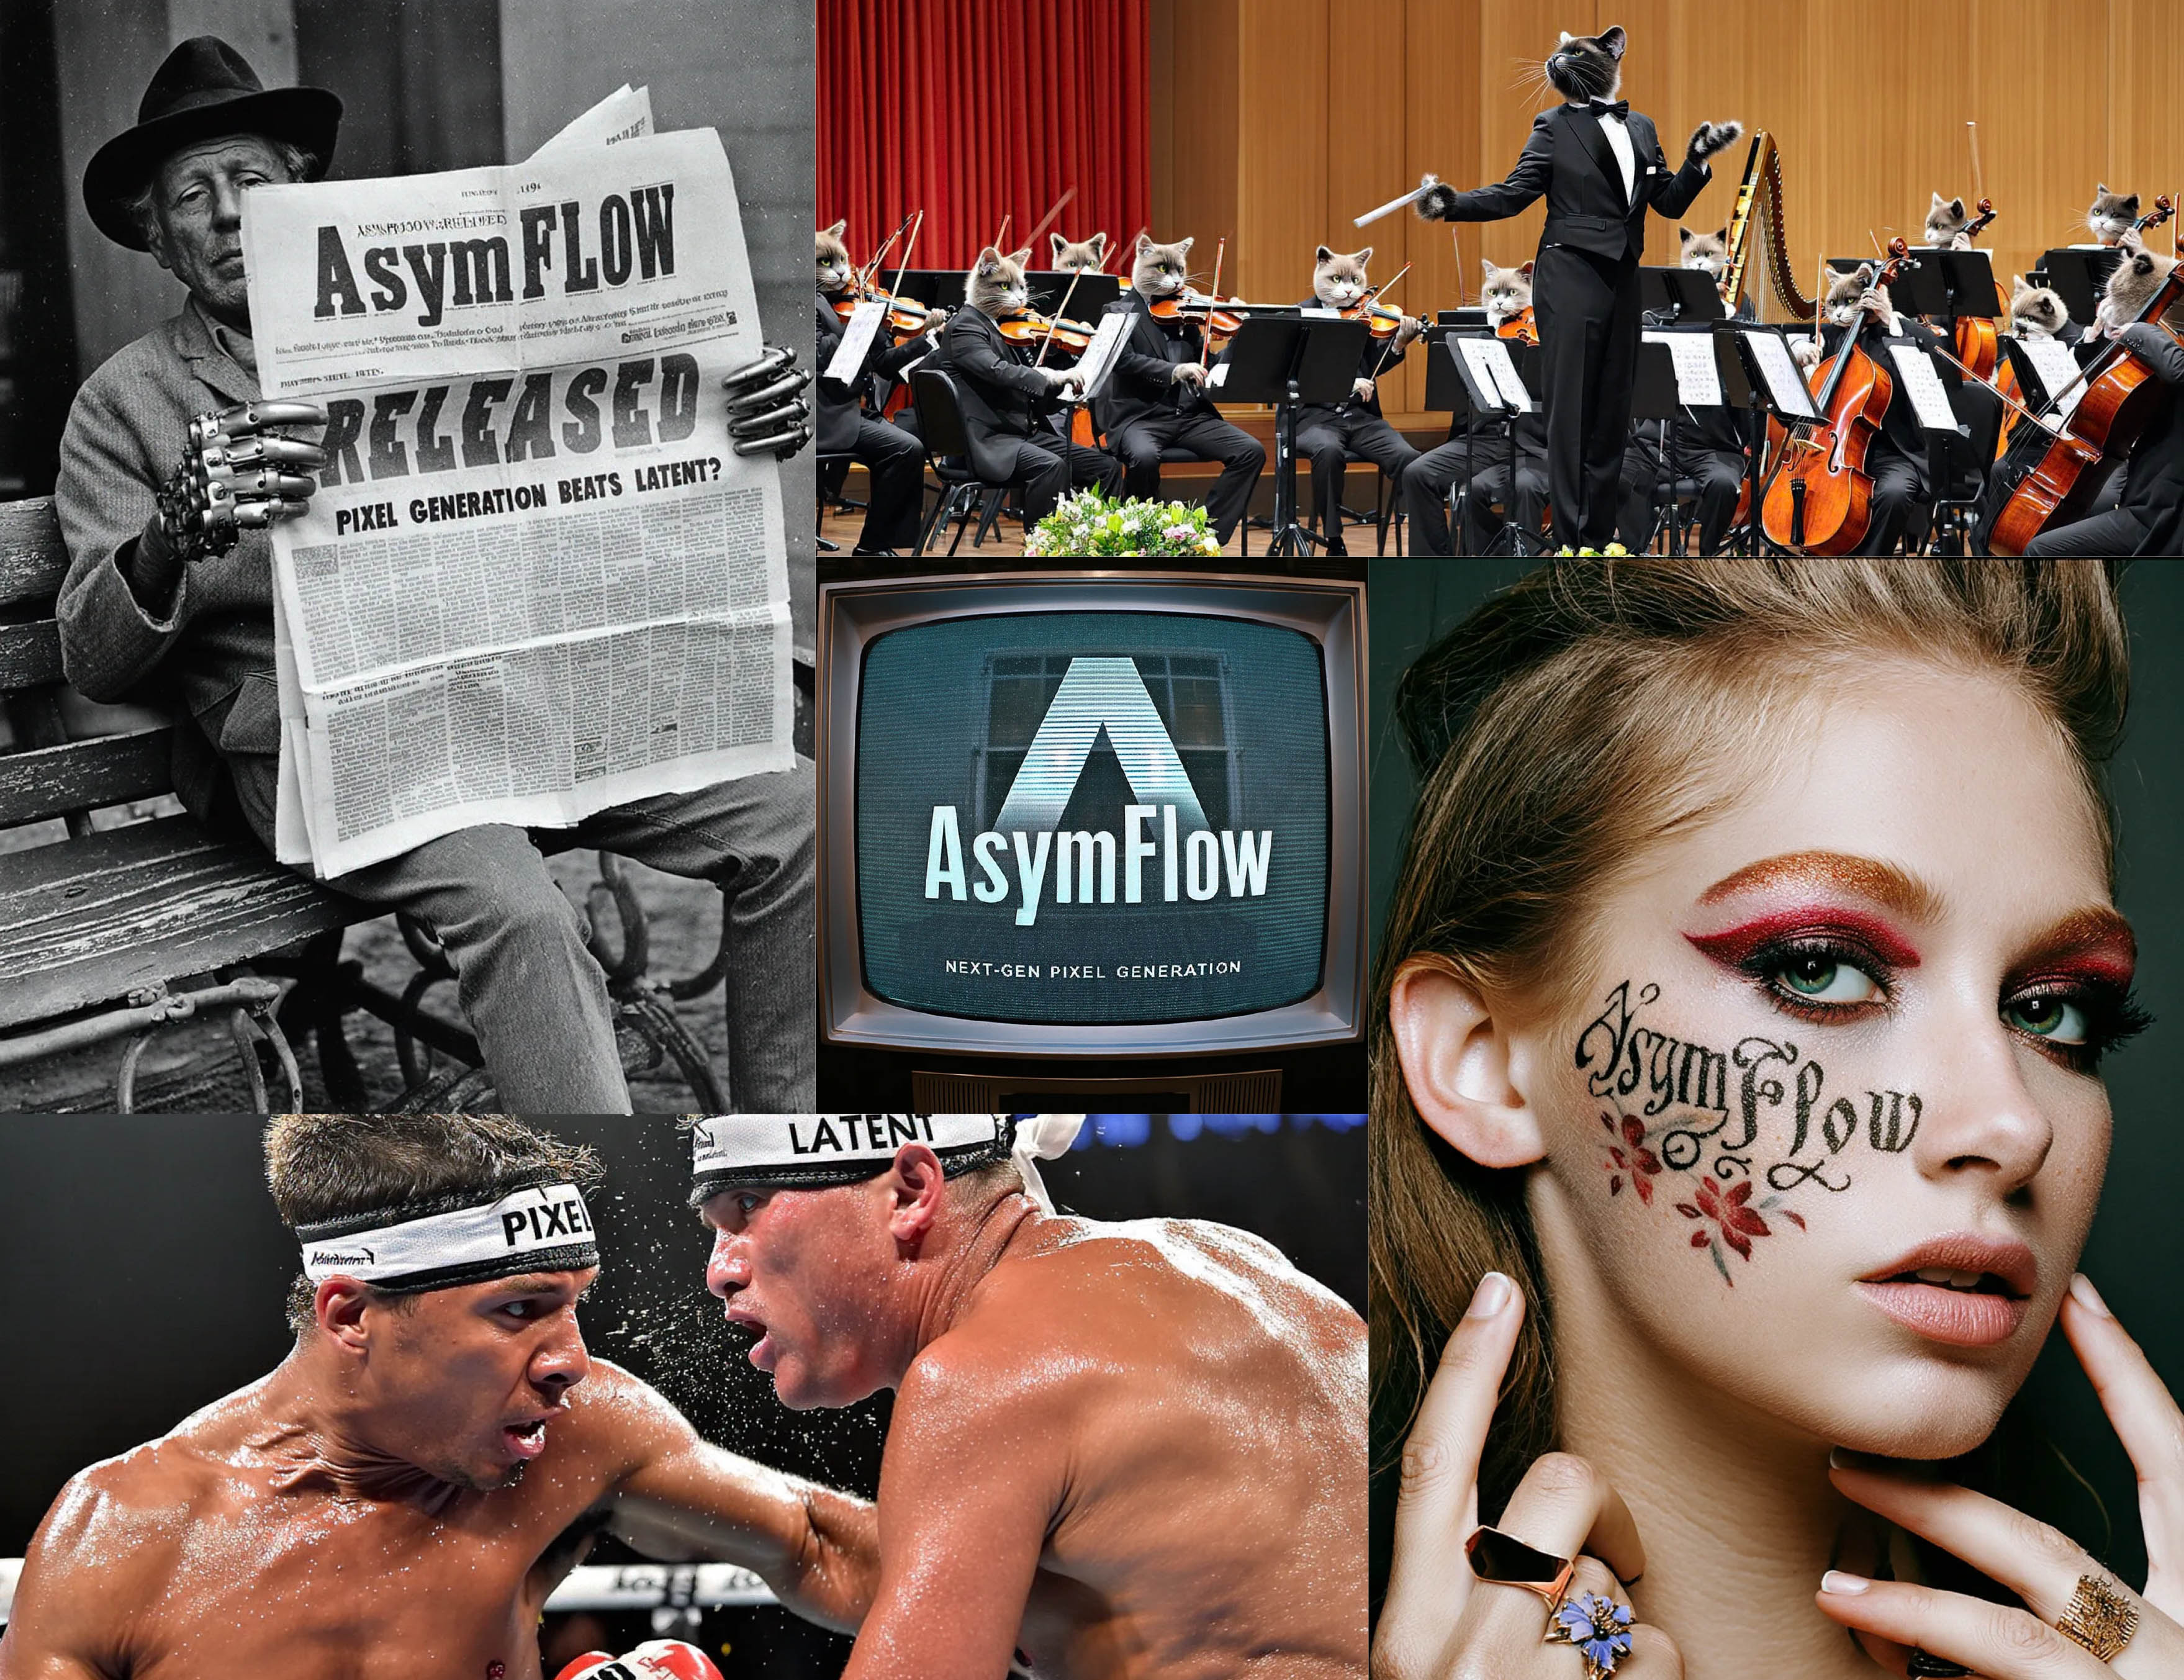
提供 AsymFlow、pi-Flow、GMFlow 等流匹配与扩散蒸馏算法的官方 PyTorch 实现,用于加速文本到图像生成模型的训练与推理。
汇总视觉语言模型空间智能方向论文与资源的 awesome 清单,配套综述《Spatial Intelligence in Vision-Language Models》,方便快速跟进空间推理研究进展。
用 OpenAI 的 CLIP 引导扩散模型,把文字描述直接生成图片,提供命令行工具和 Python 模块两种用法。
自托管的扫描件处理工具,通过 FTP、SMB 或监听文件夹接收扫描文件,用本地 Ollama 视觉模型识别内容并自动生成带日期的描述性文件名,再投递到 WebDAV 或本地目录。
在 Apple Silicon Mac 上本地跑 LTX-2 系列和 MiniMax H3 模型的视频生成应用,支持文生视频和图生视频,不用云端 GPU。

面向通用机器人策略的空间引导视觉-语言-动作框架,把视觉语言模型和动作输出打通,让机器人能按空间指令执行操作任务。
提供成人向 AI 视频生成 API,支持 Seedance Spicy 与 Wan NSFW 模型的文生视频、图生视频,带异步任务、Webhook 回调和积分计费。
把多模态大模型变成能调度各类计算机视觉任务的通用路由器,用指令调优统一处理检测、分割等任务,免去为每个任务单独建模。
RecA 用自监督学习让多模态模型在生成图像时借助自身的视觉理解能力,提升文生图和图像编辑的效果,可接入 ComfyUI 使用。
开源的 AI UGC 视频广告生成器,用 Veo、Seedance 等模型生成真人感 AI 演员口播视频,可自托管替代 Arcads 和 MakeUGC。
为 Hugging Face diffusers 提供注意力图提取与可视化工具,方便查看 Stable Diffusion 文生图时文本如何影响图像区域。
让视觉语言模型在推理时生成连续视觉 token 作为中间思考步骤,提升看图与推理表现,附带 ECCV 2026 论文官方实现。
收录 Seedance 2.5 官方指南与 36 个官方媒体素材,并保留旧版 Seedance 2 文档,方便查视频生成提示词和 API 用法。
MagicBrush 是 NeurIPS'23 发布的人工标注指令引导图像编辑数据集,为训练和评测文本指令驱动的图像编辑模型提供高质量数据。
VideoPrism 是 DeepMind 开源的视频理解基础视觉编码器,用自监督学习预训练,可直接抽取视频特征,支撑分类、检索、问答等下游任务。
MACE 是 CVPR 2024 提出的扩散模型大规模概念擦除方法,能从 Stable Diffusion 等文生图模型中批量移除指定概念,适合做内容安全与版权合规。
把 Stable Diffusion 等扩散模型用 BentoML 打包成可部署的推理服务,支持 LoRA 微调权重和 Kubernetes 部署,省去自己搭服务框架的麻烦。
轻量高效的全模态强化微调框架,支持 GRPO、DAPO 等算法,用奖励模型驱动 LLM 和多模态 VLM 训练。
精选 150+ 开源 AI 视频制作与自媒体运营工具,覆盖一键生成、文生视频、多平台分发、字幕翻译等场景,每周更新。