多模态生成
共 434 个仓库
用高分辨率语义编码器把视觉理解与图像生成统一到一个模型里,既能读懂图片,也能做文生图和图像编辑。
统一的世界模型代码库,整合扩散模型、高斯泼溅、3D 场景生成与视频编辑等能力,方便研究和复现各类世界模型。
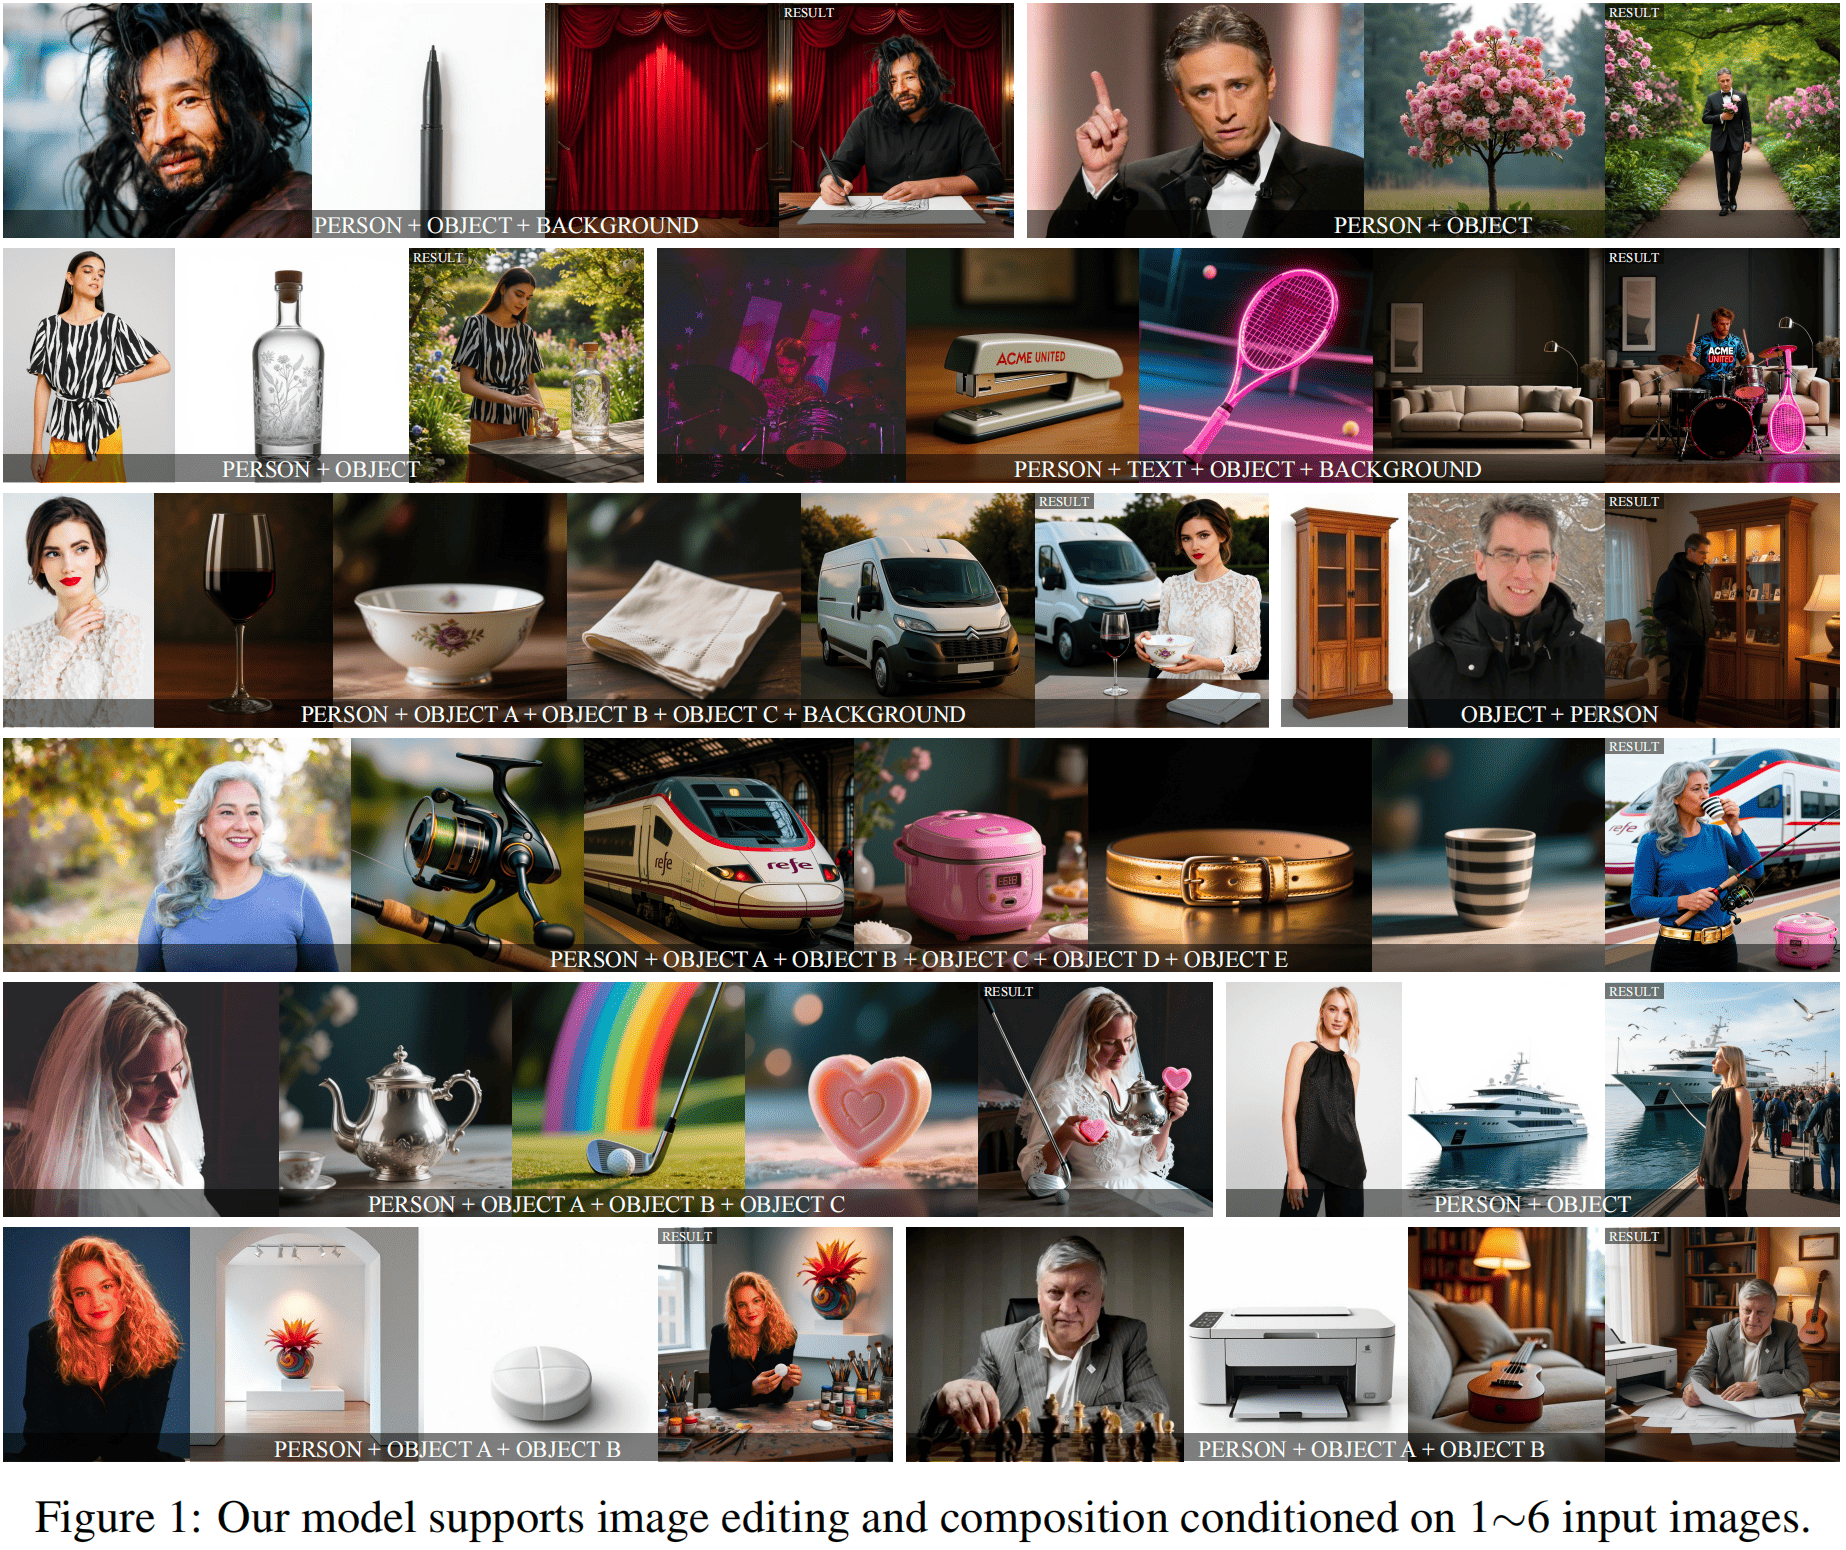
开源的多图编辑扩散模型,支持同时处理多张输入图像进行编辑与生成,适合需要批量或组合式图像编辑的场景。

Alpha-CLIP 是 CVPR 2024 提出的 CLIP 改进模型,通过引入 alpha 通道掩码让视觉语言模型能聚焦图像中指定区域,解决传统 CLIP 无法控制关注位置的问题。

基于扩散模型的身份保持文本到视频生成方案,通过频域分解在生成视频中稳定保持人物面部身份,适合做可控人物视频生成。
在 Debian 上从零搭建完全本地私有的 LLM 服务器,集成聊天、联网搜索、RAG、模型管理、MCP、图像生成和语音合成。
基于 PyTorch 的成像逆问题求解库,把去噪、去模糊、MRI 重建等任务统一到深度学习框架下,内置扩散模型和即插即用先验。
提供即插即用的 JSON 风格提示词,复制一个 style.json 就能让 Nano Banana Pro、GPT Image 和 Midjourney 生成风格统一的图像,每周更新新样式。
整理大模型训练数据全流程的精选资源库,覆盖数据获取、去重、过滤、配比、合成与溯源,配套「LLM × DATA」综述论文。
让视频扩散 Transformer 无需重新训练就能生成远超训练时长的长视频,通过改进位置编码实现长度外推,兼容 CogVideoX、HunyuanVideo 等模型。
整理大模型时代机器人领域的三维视觉论文清单,涵盖论文、代码和项目主页,方便快速跟进 3D 感知与操作方向的研究进展。
开源 11B 参数的多模态视觉语言模型,专攻长视频和实时流式视频理解,可用于视频问答等场景。
收录 908+ 个 Nano Banana Pro(Gemini 3 Pro Image)提示词案例,每个都配有效果图和在线图库,方便直接抄作业做 AI 图像生成。
多模态指令驱动的矢量动画生成器,输入文字或图片即可输出可直接使用的 Lottie JSON 动画文件,省去手工制作矢量动画的繁琐流程。
系统梳理视觉自回归模型的研究综述(TMLR 2025),覆盖图像生成、多模态、点云、运动预测等方向,帮研究者快速理清技术脉络与加速方法。
整理 CLIP 等视觉语言模型上 prompt learning 与 adapter learning 方法的论文清单,方便做少样本、零样本分类的研究者快速找到相关工作和基线。
一份简洁易读的扩散模型训练与采样代码,适合想搞懂扩散模型原理、动手复现图像生成流程的开发者。
系统梳理大模型、多模态模型等场景下的模型合并方法、理论与应用,涵盖攻击防御、持续学习、扩散模型等方向,适合快速了解该领域全貌。
用 Hugging Face diffusers 把扩散模型从图像搬到音频,能直接训练和生成音乐片段,省去自己搭扩散流程的麻烦。
汇总视频生成领域的论文与资源清单,覆盖扩散模型、GAN、文本生成视频等方向,方便快速追踪研究进展。
面向具身智能的一站式 VLA 工程平台,打通数据、模型训练到真机部署全流程,省去自己拼装工具链的麻烦。
极简但开箱即用的世界模型研究代码库,集成扩散模型、视频生成与模型预测控制,方便快速复现和推进世界模型实验。
汇总文本到图像生成领域的研究论文与资源,方便快速跟进扩散模型等文生图方向的进展。
X-VLA 是 ICLR 2026 论文的官方实现,用软提示 Transformer 构建可扩展的跨具身视觉-语言-动作模型,让同一套策略能迁移到不同机器人本体上做操作任务。