视觉与 3D
共 370 个仓库 · 一年内有推送
在 React Native 里跑 TensorFlow Lite 模型的高性能绑定库,支持 GPU 加速,适合在手机上做目标检测、人脸识别等端侧推理。

把 COCO、LabelMe、Labelbox、VoTT 等格式的 JSON 标注转成 YOLO 训练格式,适合做目标检测数据集迁移;官方已建议改用 Ultralytics 包里的 convert_coco()。
用 C++20 实现、带 Python 绑定的跨平台 3D 图形库,API 风格对齐 three.js,方便在原生和 Web 环境复用同一套高层接口做渲染与物理仿真。
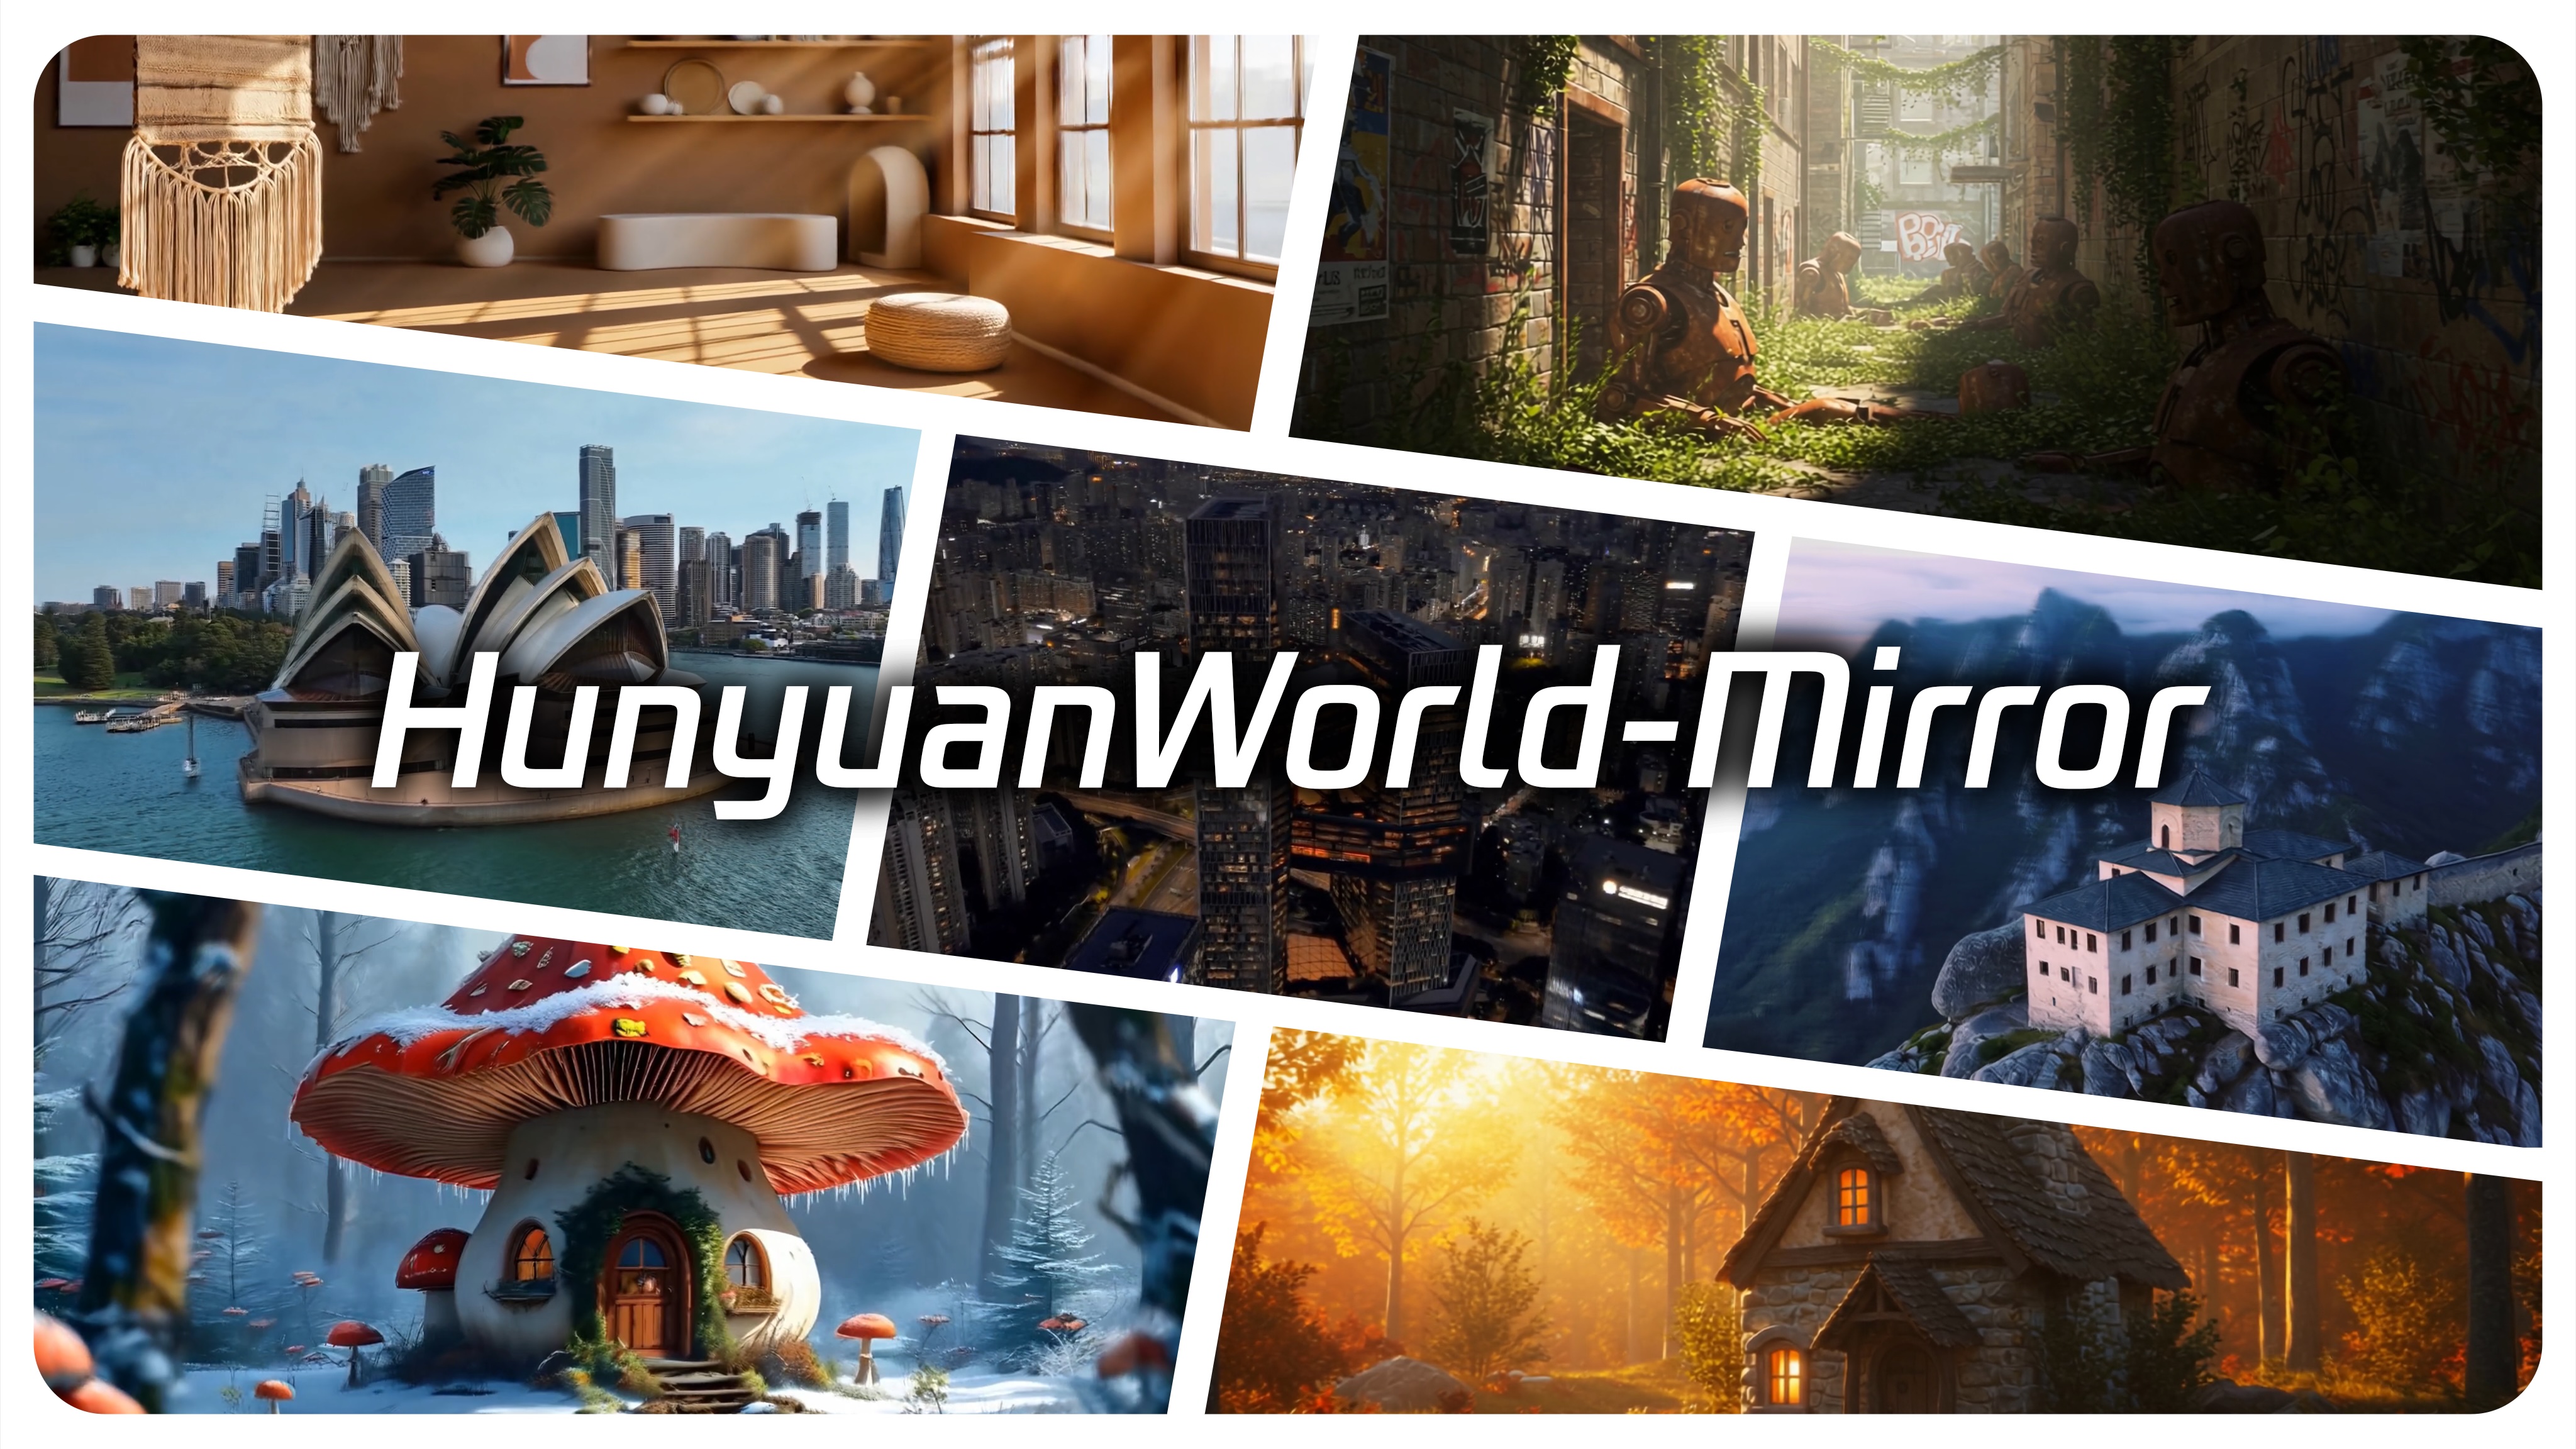
腾讯混元开源的通用三维重建模型,能从单图或多视图快速还原三维场景,面向图像转 3D 与世界模型生成等任务。
AirSLAM 是面向视觉定位的 SLAM 系统,融合 SuperPoint 与 SuperGlue 做特征提取和匹配,为机器人在未知环境中提供实时位姿估计与建图。
拆解 Intel/AMD CPU 底层机制的 C 语言实现合集,涵盖分页、分段、VT-x 硬件虚拟化与 EPT,适合想搞懂 CPU 内部原理和写 hypervisor 的人。

仅用激光雷达或激光-惯性融合的高鲁棒、高精度里程计,为机器人和自动驾驶提供可靠定位与建图,应对退化场景和传感器不确定性。
纯 Java 实现的高性能计算机视觉库,覆盖 SFM、相机标定、基准标记识别、目标跟踪和图像处理,适合在 Android 或 JVM 上做 3D 视觉与摄影测量。
用提示(如稀疏深度点或相机位姿)引导单目深度估计,输出高精度、尺度一致的深度图,用于三维重建和机器人抓取。
面向 Android 的机器学习工具包,封装 ML Kit 能力,几行代码就能接入文字识别、条码扫描、人脸与对象检测、图像标记等功能。
基于 VGGT 的稠密 RGB SLAM 系统,在 SL(4) 流形上做位姿优化,用纯视觉输入实现稠密建图与定位。
一套用于构建 Web 医学影像应用的 JavaScript 库,提供渲染、分割等基础能力,方便开发放射科阅片类应用。
把图片或提示词一键变成带贴图、骨骼和动画的游戏角色,本地跑在 Apple Silicon 或 NVIDIA 上,适合独立游戏开发者和 3D 美术。

OC-SORT 是 CVPR2023 提出的在线多目标跟踪算法,通过以观测为中心的设计提升遮挡和非线性运动场景下的跟踪鲁棒性,代码简单易用。
把 Ultralytics YOLOv8 到 YOLOv12 系列模型封装成 ROS 2 节点,让机器人项目能直接调用目标检测、实例分割、姿态估计和跟踪能力。

本地优先的专业视频监控平台,把摄像头接入、目标检测和人脸识别整合到一个现代化界面里,适合自建 NVR 和家庭安防。
面向 3D 激光雷达点云的快速地面分割算法,能在复杂场景下稳健剔除地面点,为后续检测与建图提供干净的非地面点云。
输入一张参考图和提示词,按指定相机轨迹生成可预览、可回放、可追溯的三维场景,并能在浏览器里直接查看彩色/深度动画和高斯点云。
从多视角立体图像给三维重建模型自动生成纹理贴图,解决重建网格缺少真实感表面外观的问题。
微软 AI for Good 实验室开源的生物多样性监测工具集,提供相机陷阱动物检测、声学识别等模型与边缘设备方案,帮生态保护者用 AI 自动处理野外影像和音频数据。

轻量级 LiDAR-惯性里程计算法,用由粗到细的连续时间轨迹构建做精确运动校正,为机器人和 SLAM 提供实时定位与建图。

用 Python 快速搭建复杂视频分析应用的多进程框架,把检测、跟踪等环节串成流水线,解决视频流处理中并行调度和模块编排的问题。
用卫星影像合成可沉浸漫游的 3D 城市场景,结合 3DGS 与扩散模型补全视角,解决大范围城市三维重建数据不足的问题。

面向商务场景的日语形态素分析器,能对日文文本做分词和词性标注,适合需要稳定处理业务文档的 Java 项目。