探索全部
共 1,808 个仓库 · 一年内有推送 · Python
跨平台系统清理工具,可深度清除缓存、日志和临时文件,并支持反取证式擦除,释放磁盘空间、保护隐私。
把 PDF、扫描件等非结构化文档通过 LLM 抽取成结构化 JSON,可直接接入 API 和 ETL 流水线,省去手工写解析规则。
把 PDF、Word、PPT 解析成适合喂给大模型的格式,尽量不丢内容,省去自己清洗文档的麻烦。

一站式 WebUI,基于 Diffusers 和 PyTorch 统一完成 AI 图像与视频生成、打标和后期处理,省去在多个工具间切换的麻烦。
单张图片就能快速重建出 3D 物体模型的前馈生成模型,适合需要批量产出 3D 资产的场景。
开源特征存储,统一管理机器学习特征的注册、存储与在线离线服务,解决训练和推理特征不一致的问题。
命令行里随手记日记和笔记的工具,支持加密存储与标签检索,不用离开终端就能收集想法。

基于大模型的自动化代码安全审计平台,多智能体协作挖掘漏洞,并在沙箱中自动验证 PoC,支持 Ollama 私有部署和一键生成报告。

面向个人用户的照片与文件管理工具,用标签和元数据整理文件,替代传统文件夹分类,方便检索和浏览。
用大语言模型把编译后的二进制代码还原成可读源码,为逆向工程提供自动化反编译能力。
像 htop 一样在终端里实时查看 NVIDIA GPU 的进程占用、显存和利用率,还能导出指标接入 Grafana 做监控面板。
面向大模型训练的数据处理流水线,把原始多模态数据清洗、过滤、去重并加工成高质量指令微调语料。
从网页抓取正文和元数据的 Python 库与命令行工具,支持爬取、解析并导出为 CSV、JSON、Markdown 等格式,适合构建语料库和 RAG 数据。
中文 LLaMA-2 与 Alpaca-2 大模型二期项目,提供支持 64K 超长上下文的中文预训练和指令微调模型,可直接用于长文本理解与对话。
纯 Python 实现的 PDF 解析库,能从 PDF 中提取文本、布局和元数据,适合做文档解析、内容抽取和 RAG 数据预处理。
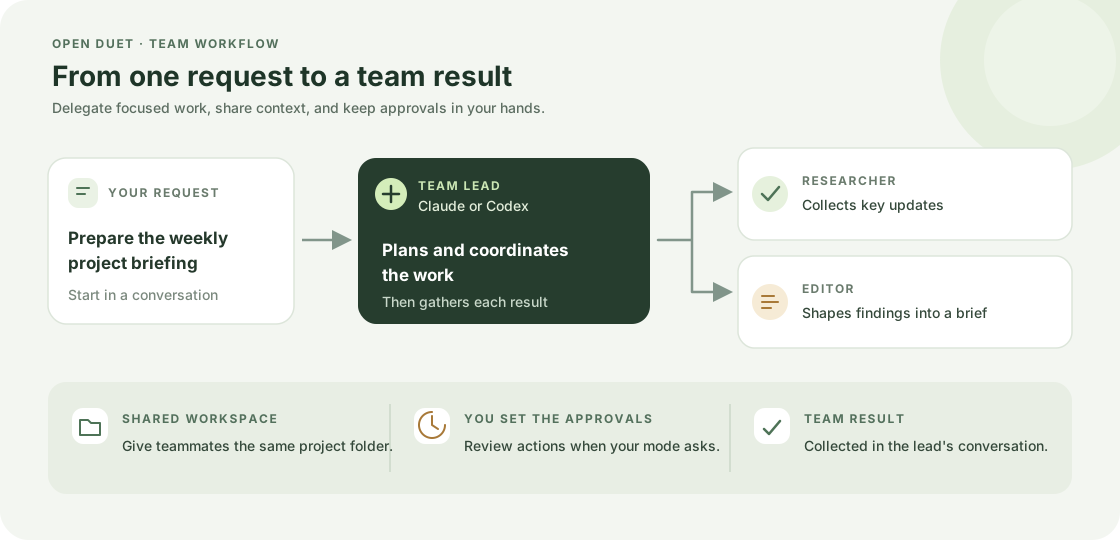
自托管的命名智能体工作区,用审批闸门和独立电脑替代 Manus 这类托管 AI 同事

基于大语言模型的 QQ 聊天机器人,主打拟人化对话风格,追求温暖真实的互动体验而非效率,适合搭建有情感陪伴感的群聊助手。
纯 Python 写的轻量级音乐下载器,覆盖网易云、QQ音乐、酷狗、B站、YouTube、Spotify 等数十个音乐和有声书平台,一条命令就能批量抓取歌曲。
一站式 MLOps/LLMOps 平台,把实验跟踪、数据管理、流水线编排和模型服务整合在一起,帮团队把 AI 训练与部署流程自动化。
自托管的 AI 数字同事平台,可创建带指令、记忆、例行任务和独立隔离电脑的命名智能体,执行操作前需你批准。
DeepSpeed 官方示例集,提供各类模型接入 DeepSpeed 分布式训练的现成代码,方便照着改自己的训练脚本。
逐镜头逆向分析任意视频,判断画面是实拍、AI 生成还是代码渲染,并给出复刻方案,适合短视频拆解与 AIGC 溯源。
无需越狱即可给 iOS 应用打补丁、注入 CaptainHook/Logos 插件和命令行工具,把 iOSOpenDev 那套逆向开发流程搬进 Xcode。
pre-commit 的官方钩子集合,开箱即用,帮你在提交代码前自动检查尾随空格、文件结尾、YAML/JSON 语法等常见问题。