需 Python 3.8-3.10 与 CUDA 11.7/11.8 环境;数据库、角色扮演、表情包等演示功能需另行下载百度网盘文件;本地模型、live2d、vits 等模型文件需自行放入 models 对应目录。
LLM-Kit
wpydcrAGPL-3.0更新放缓把主流大模型 API 和开源模型统一到一个 WebUI 里,覆盖知识库、数据库、角色扮演、文生图、LoRA 微调、数据集制作等全流程工具。
🚀WebUI integrated platform for latest LLMs | 各大语言模型的全流程工具 WebUI 整合包。支持主流大模型API接口和开源模型。支持知识库,数据库,角色扮演,mj文生图,LoRA和全参数微调,数据集制作,live2d等全流程应用工具
暂无版本555star63fork同步于 2026-11-07 07:31 UTC
git clone https://github.com/wpydcr/LLM-Kit.git
cd LLM-Kit
pip install -r requirements.txt 硬件要求按 README 说明
README 未给出具体显存要求;仅用 LLM API 时无需显卡,本地模型支持 4bit/8bit 量化,其中 bitsandbytes 仅支持 Linux,deepspeed 训练仅支持 Linux。
支持 Apple Silicon需要 CUDA
不写代码就能拥有定制大模型与专属应用的 WebUI 全流程整合包
把主流大模型 API 和开源模型统一到一个 WebUI 里,覆盖知识库、数据库、角色扮演、文生图、LoRA 微调、数据集制作等全流程工具。
核心能力
- 整合主流大模型 API 与开源模型推理
- 支持 LoRA 与全参数微调及数据集制作
- 内置 FAISS 本地知识库与 MySQL 数据库接入
- 提供角色扮演、表情包与 live2d 应用 demo
- 集成 Midjourney 文生图与 vits、svc 语音
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
暂无 release 数据(可能没有发版,或尚未同步)。
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。
苏秦(suqin) 语言大模型全工具链 WebUI 整合包
介绍
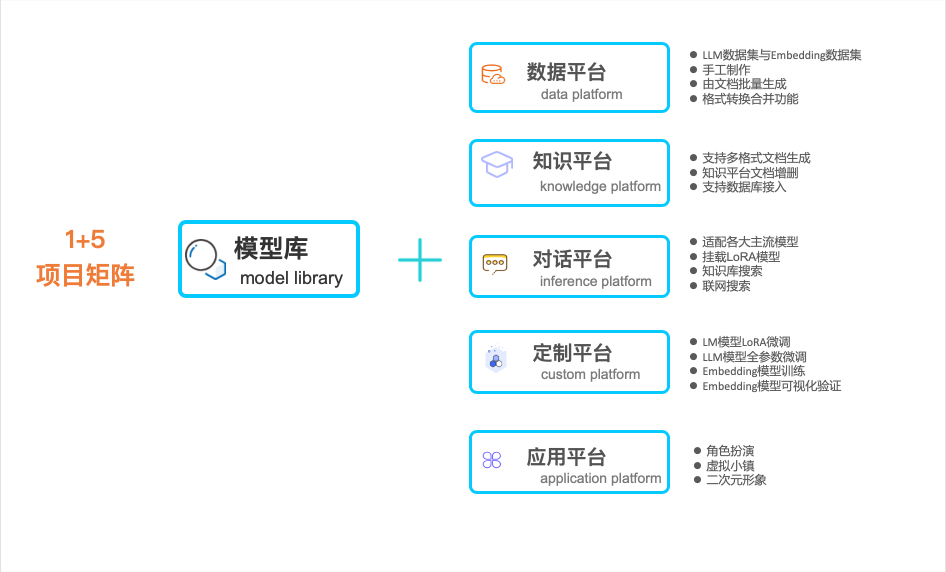
⛓️ 本项目目标是实现目前各大语言模型的全流程工具 WebUI 整合包。不用写代码即可拥有自己的定制模型与专属应用!
具体功能模块如下:
开发部署
初次使用建议查阅说明文档进行相关操作
软件需求
本项目已在 Python 3.8 - 3.10,CUDA 11.7/11.8 环境下完成测试。已在 Windows、Linux 系统中完成测试。
安装环境
1. 运行环境
# 拉取仓库
$ git clone https://github.com/wpydcr/LLM-Kit.git

# 进入目录
$ cd LLM-Kit

# 安装依赖
$ pip install -r requirements.txt
依赖也可以直接下载:Windows环境包, Linux环境包。
2. 执行脚本
- win环境,双击打开 web-demo-CN.bat 脚本
- Linux环境,双击打开 web-demo-CN.sh 脚本
3. 相关演示文件
文件目录
- env :集成包环境
- utils :工具代码
- modules :各模块代码
- agent :agent相关代码
- chatdb : 数据库接入相关代码
- svc : svc相关代码
- vits : vits相关代码
- apply :应用demo代码
- model :模型相关代码
- agent :agent相关代码
- data :数据文件
- apply :应用demo相关文件
- audio :生成的语音文件
- emotion :表情包文件
- play :人设提示词文件
- documents :知识库数据文件
- modeldata :模型训练数据文件
- LLM :大模型训练数据文件
- Embedding :嵌入模型训练数据文件
- apply :应用demo相关文件
- ui :ui界面代码
- output :训练中的checkpoints
- models :模型文件
- LLM :语言大模型文件
- Embedding :嵌入模型文件
- LoRA :LoRA模型文件
- live2d_models :live2d模型文件
- svc_models :svc相关文件
- hubert_model :声音编码器模型文件
- svc : svc模型文件
- vits_pretrained_models : vits模型文件
发展路线图
-
LLM API支持(无需显卡)
-
LLM 模型支持(训练/推理)
- 4bit与8bit量化(bitsandbytes仅支持linux)
- 使用内存替代部分显存(deepspeed训练仅支持linux,推理在windows需编译)
- chatglm-6b
- chatglm2-6b
- chatglm2-6b-32k
- moss-moon-003-sft
- phoenix-chat-7b
- Guanaco
- baichuan-vicuna-chinese-7b
- Baichuan-13B-Chat
- internlm-chat-7b-8k
- chinese-alpaca-2-7b(llama2)
- Qwen-7B-Chat
- Qwen-14B-Chat
- Baichuan2-7B-Chat
- Baichuan2-13B-Chat
-
多模态大模型(推理)
- qwen-vl
-
Finetune 支持
-
Embedding 模型支持(训练,推理:HuggingFaceEmbeddings能加载的都行)
-
工具
- 聊天
- LLM API 并行调用
- LLM API 流式调用
- 提示词模板
- 图像生成
- Midjourney(VPN)
- GEN-2
- Pika
- 数据集
- LLM训练数据集制作
- Embedding训练数据集制作
- LLM数据集格式转换
- Embedding数据集格式转换
- langchain
- 本地知识库
- FAISS
- 本地模型知识库并行调用
- 网络接入
- mysql数据库接入
- Agent 实现
- 本地知识库
- 扩展插件模式
- 聊天
-
应用demo
-
增加 API 支持
- 利用 fastapi 实现 API 部署方式
- 实现调用 API 的 Web UI Demo
- VUE 页面前端
贡献者
吴平宇 @USTC
发起人,负责整体项目架构和技术规划
廖文彬 @中科院计算技术研究所
负责gradio,图向量数据库,Mysql数据库,api接口集成等python开发
胡钜程 @伦敦大学学院UCL
负责图向量数据库, live2D,vits, svc,gradio等python开发
李璟辉
负责大模型训练与推理的后端代码开发
项目招募
详见说明文档
参考与学习


开源协议
本仓库的代码依照 AGPL-3.0 协议开源
一方面希望通过开源加强项目产品化程度;另一方面希望在社区中吸收更多的实践场景进而继续完善产品,也欢迎大家参与到项目中来。
AGPL-3.0 是 OSI 批准的许可证,符合自由和开源软件的所有标准,开源永远是我们的初心与核心,我们将始终不渝的坚持去做这件事,我们相信在社区的推动下,这件事我们一定会做的更好 。
或许很多开发者对此协议抱有一些疑问,开源社区目前也有很多采用 AGPL-3.0 协议的开源软件,例如 MongoDB、Grafana、Loki 等, 维基百科还专门有一份列表列出了哪些开源项目 采用了 AGPL-3.0 开源协议。
AGPL-3.0 协议有一个非常关键的点,即对修改上游开源项目代码后的二次分发版本必须也要开源,协议限制的是部分企业想 Folk 开源项目代码后进行闭源商业分发,跟上游开源项目的维护团队进行直接的商业竞争,如果仅仅只是企业内部自己使用而不进行任何层面修改,用户大可不必担心 AGPL-3.0 协议带来的限制, 这些条件旨在鼓励和希望修改软件的第三方也为项目和社区做出贡献。我们认为这是一种更公平的前进方式,我们相信这将有助于我们建立更强大的社区。
简单来讲:如果您修改了本项目源代码,那么您必须将这些修改贡献给社区, 绝不允许修改后和衍生的代码做为闭源的商业软件发布和销售。
我们也提供了商业授权,如果您需要将本产品进行二次开发、更改并进行任何附带商业化性质行为使用,请联系我们([email protected])进行商业授权,以遵守 AGPL-3.0 协议保证您的正常使用。
除此之外,我们也会酌情接受根据个人或企业需求的定制化开发。
目前在国内 GPL 协议具备合同特征,是一种民事法律行为 ,属于我国《合同法》调整的范围。 本项目团队保留诉讼权利。
本项目开源团队拥有对本开源协议的最终解释权。
引用
如果您在项目中使用了我们的模型、代码或者数据,请引用下面文章。
Please cite the repo if you use the data or code in this repo.
@misc{wupingyu2023,
  author={Pingyu Wu},
  title = {LLM Kit},
  year = {2023},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/wpydcr/LLM-Kit.git}},
}
Starchart
supabase
supabase·TypeScript
基于 Postgres 的一站式后端开发平台,提供专用数据库、认证、存储和向量检索能力,可替代 Firebase 快速搭建 Web、移动和 AI 应用。
Postgres+4向量化 / 重排服务
114745+11715kv1.26.082026-11-10 17:13 UTC

Langchain-Chatchat
chatchat-space·Python
基于 Langchain 和 ChatGLM、Qwen、Llama 等本地大模型搭建的知识库问答应用,支持 RAG 检索增强与 Agent 能力,可离线部署私有文档问答系统。
知识库问答+4向量化 / 重排服务
387136.3kv0.3.12025-11-10 09:27 UTC
WeKnora
Tencent·Go
把原始文档变成可查询的 RAG、自主推理 Agent 和自维护 Wiki 的开源 LLM 知识平台,适合搭建企业知识库与智能问答。
知识库+4向量化 / 重排服务
37103+3455.1kv0.9.02026-11-09 15:19 UTC

TencentDB-Agent-Memory
TencentCloud·TypeScript
把对话、文档和代码沉淀成聊天记忆、技能、LLM-Wiki、代码图谱四类可复用记忆资产,让多个 AI Agent 跨框架共享和治理长期记忆。
长期记忆+4向量化 / 重排服务
30746+1133.0kv2.0.32026-11-10 13:27 UTC