GPU 监控
显存、利用率、温度与多卡监控。
开源可组合的可观测性平台,把 Prometheus、Loki、Elasticsearch 等多源指标、日志和链路数据统一做成仪表盘,并支持告警。

开源监控系统与时序数据库,采集指标、配置告警规则并绘图展示,适合搭建从基础设施到 GPU 集群的可观测性平台。
像 htop 一样在终端里实时查看 NVIDIA GPU 的进程占用、显存和利用率,还能导出指标接入 Grafana 做监控面板。

在 NVIDIA Jetson 系列开发板上实时查看 CPU、GPU、内存和功耗状态,还能直接调整风扇与功耗模式,省去手动翻 sysfs 的麻烦。
在终端里实时查看 Apple Silicon Mac 的 CPU、GPU、内存和功耗,界面类似 top,适合跑本地模型时盯资源占用。
面向 Apple Silicon Mac 的实时系统监控工具,无需 sudo 即可查看 CPU、GPU 等硬件指标,提供 TUI 界面、JSON/Prometheus 指标服务和 Rust 库。
把 NVIDIA GPU 的硬件遥测数据导出成 Prometheus 指标,方便监控显卡温度、功耗、显存和利用率等运行状态。
在终端里实时查看 Apple Silicon Mac 的 CPU、GPU、内存和功耗占用,类似 top 但针对 M 系列芯片优化,适合跑本地模型时盯资源。
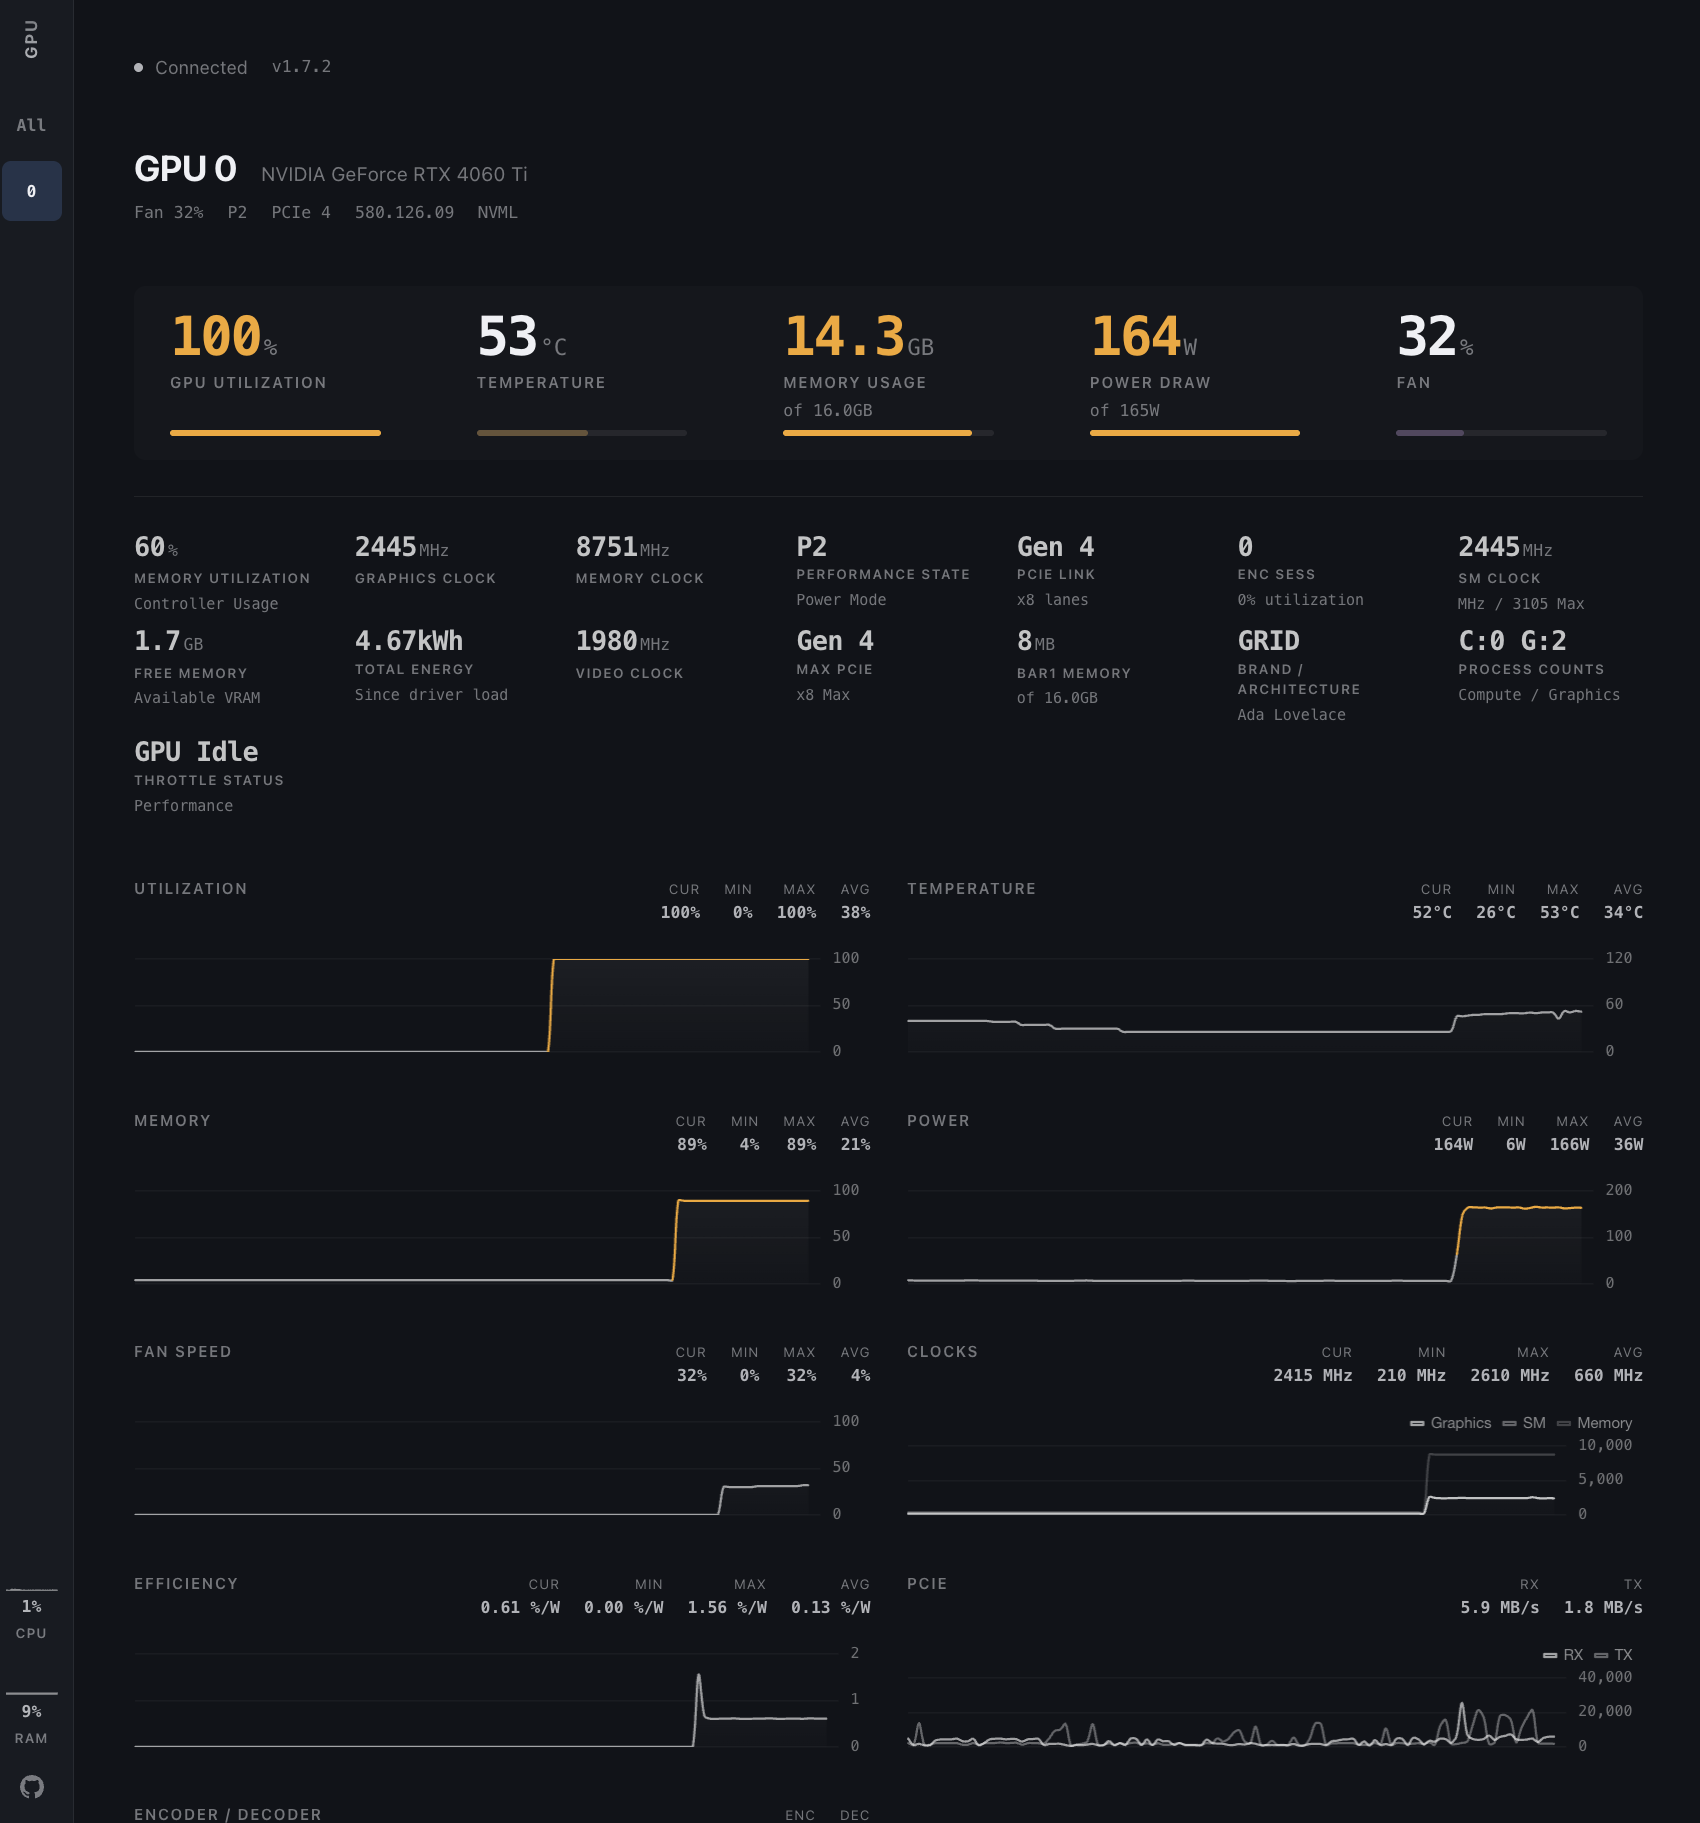
实时监控 NVIDIA GPU 的 Web 仪表盘,用图表展示显存、利用率、温度等指标,方便运维和 MLOps 排查显卡状态。
Keep an eye on system resources

Linux 系统和进程监控工具,能记录并回放 CPU、内存、磁盘、网络等资源使用情况,方便事后排查性能瓶颈。

把 CPU、GPU 等硬件传感器数据采集后推送到 Graphite、InfluxDB、Prometheus 等时序数据库,方便用 Grafana 做监控看板。
在 Kubernetes 集群里自动发现 GPU 节点故障并执行修复,减少加速计算任务因硬件异常中断。

用流水线方式自动运行 Python 程序,顺带监控 GPU 状态,适合管理机器学习实验的批量跑批场景。
轻量跨平台的 CPU/GPU 实时监控命令行工具,直接调用厂商 API 获取准确硬件数据,并用 ASCII 图表直观展示。
用 Rust 写的 NVIDIA GPU 终端监控面板,能实时查看显存占用和进程,比反复敲 nvidia-smi 更直观高效。

轻量级 Web 面板,实时查看多块 GPU 的占用率、显存和温度等状态,方便跑深度学习训练时随时掌握显卡负载。