向量数据库
ANN 索引与混合检索。
高性能内存键值数据库,兼作缓存、消息队列和向量检索引擎,帮实时数据应用把读写延迟压到毫秒级。
用 Rust 写的极速搜索引擎 API,支持全文、模糊、地理和 AI 混合检索,几行代码就能给网站或应用加上即时搜索。
一个免代码的 RAG 服务器,能随文档更新自动同步答案,支持 8 种向量数据库,基于 Pathway 构建。
高性能云原生向量数据库,专为大规模向量近似最近邻检索设计,适合搭建以图搜图、语义搜索和 RAG 等应用。
面向稠密向量的高效相似度检索与聚类库,支持十亿级向量近邻搜索,是构建向量数据库和 RAG 检索层的底层引擎。

面向不可预测增长的 Agent 负载设计的分布式数据库,原生支持事务、分析与向量检索,避免数据孤岛和资源争抢。

高性能大规模向量数据库与向量检索引擎,用 Rust 编写,支持 HNSW、混合检索和图像搜索,适合为 AI 应用和 RAG 提供相似度检索能力。
兼容 Redis 和 Memcached 协议的内存数据库,用多线程架构提升吞吐量,可直接替换现有缓存层。
开源的向量数据库,专门给 AI 应用做检索基础设施,支持 RAG、语义搜索和智能体记忆存储,底层用 Rust 重写后性能更强。
本地运行的简历匹配与生成工具,用 100+ 大模型解析简历、计算与职位描述的文本相似度,并生成 PDF 和求职信。
用 C++ 写的开源内存搜索引擎,支持模糊容错、分面和地理检索,可作为 Algolia、Pinecone 或 ElasticSearch 的轻量替代,快速搭建搜索体验。
给 Postgres 加上向量相似度检索能力的开源扩展,支持精确和近似最近邻搜索,让 RAG 和语义检索直接跑在现有数据库里。
开源向量数据库,同时存储对象和向量,把向量检索和结构化过滤结合起来,具备云原生数据库的容错与扩展能力。
面向多模态 AI 的嵌入式向量检索库,支持近似最近邻搜索和语义相似度检索,无需单独部署服务,帮开发者省去向量数据管理的麻烦。
一个不到 2KB 的轻量搜索引擎,能在浏览器、服务端或边缘网络里跑全文、向量和混合检索,还自带 RAG 流水线,适合做本地化搜索和轻量检索增强。

开源分布式数据库,兼容 MySQL,支持 HTAP 混合负载与全文检索,用一套引擎承载 OLTP、分析和 AI 场景下的高要求业务。
把全文检索、向量召回和聚合分析都塞进一个 Postgres 里,靠 pg_search 扩展实现 BM25 与混合搜索,省去额外维护搜索和向量库的麻烦。
基于 Rust 重写的云原生数据仓库,统一支持分析、搜索、AI 与 Python 沙箱,直接架在 S3 上,省去多套系统拼装。
MySQL 的社区分支,由原 MySQL 核心团队维护,提供功能完整、稳定且许可证宽松的开源关系型数据库,支持全文检索、GIS 和向量近邻搜索。
给 LLM 加一层语义缓存,相似问题直接命中缓存结果,省下重复调用 API 的钱和时间,已集成 LangChain 和 llama_index。

面向大规模数据与机器学习的 AI 搜索平台,支持向量检索、张量计算和推荐排序,适合搭建 RAG 与搜索服务。
基于 PyTorch 的度量学习库,提供对比损失、难例挖掘、采样器和检索指标,用来训练和评估相似度搜索所需的嵌入向量。

给 Redis 加上二级索引、全文检索、向量相似度搜索和聚合能力的查询索引引擎,让 Redis 直接承担搜索与 RAG 检索场景。
面向用户和 AI Agent 的实时分析数据库,支持低延迟 SQL 查询和向量检索,可从 Kafka 实时摄入数据做 OLAP 分析。
用 Go 写的轻量级分布式文本与向量搜索引擎,主打简单和速度,适合给应用快速加上全文检索或向量检索能力。
纯头文件的 C++/Python 近似最近邻检索库,实现 HNSW 算法,无需额外依赖即可嵌入项目,用于向量相似度搜索。
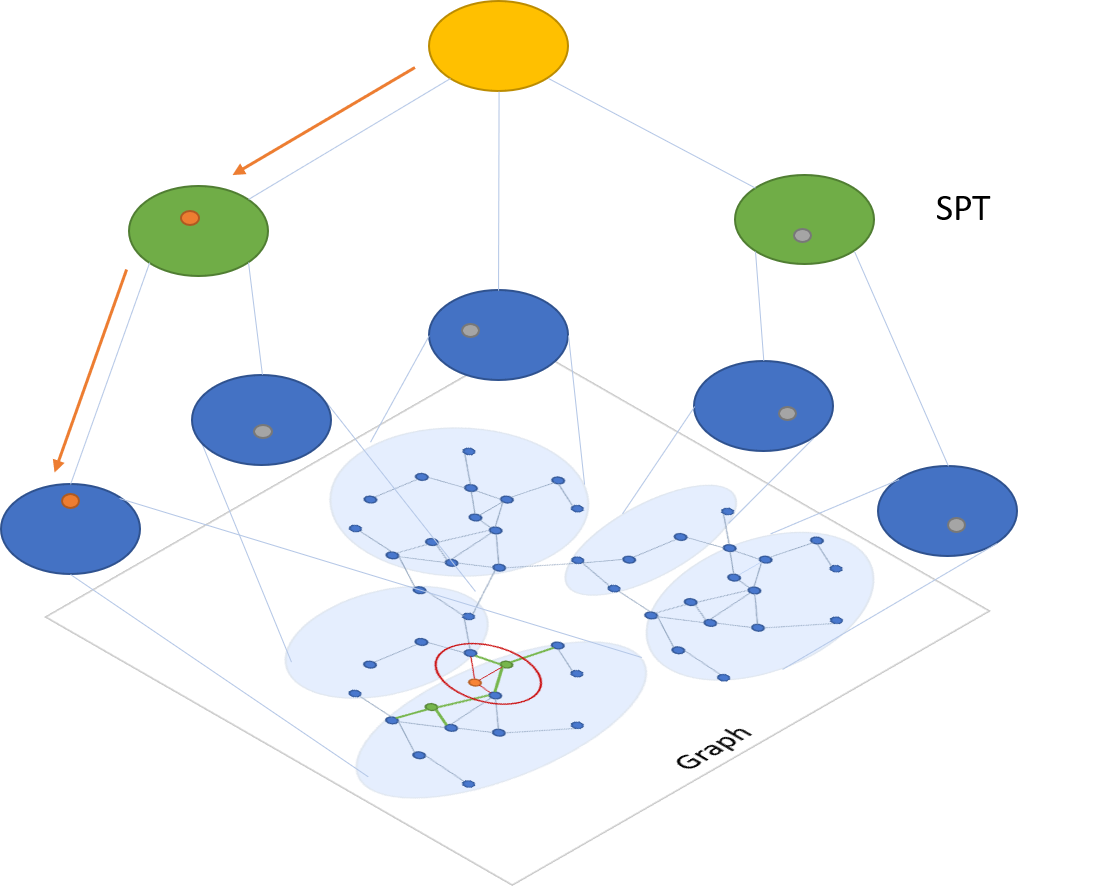
微软开源的分布式近似最近邻搜索库,提供高质量向量索引构建、搜索和在线服务工具,专为大规模向量检索场景设计。

轻量级向量与任意对象相似度搜索聚类引擎,支持十多种编程语言,可做近似最近邻检索、模糊搜索和推荐系统。

一个用 C# 编写的 ACID 文档数据库,内置全文搜索、索引、分片和空间查询,适合需要强一致性和复杂检索的 NoSQL 场景。
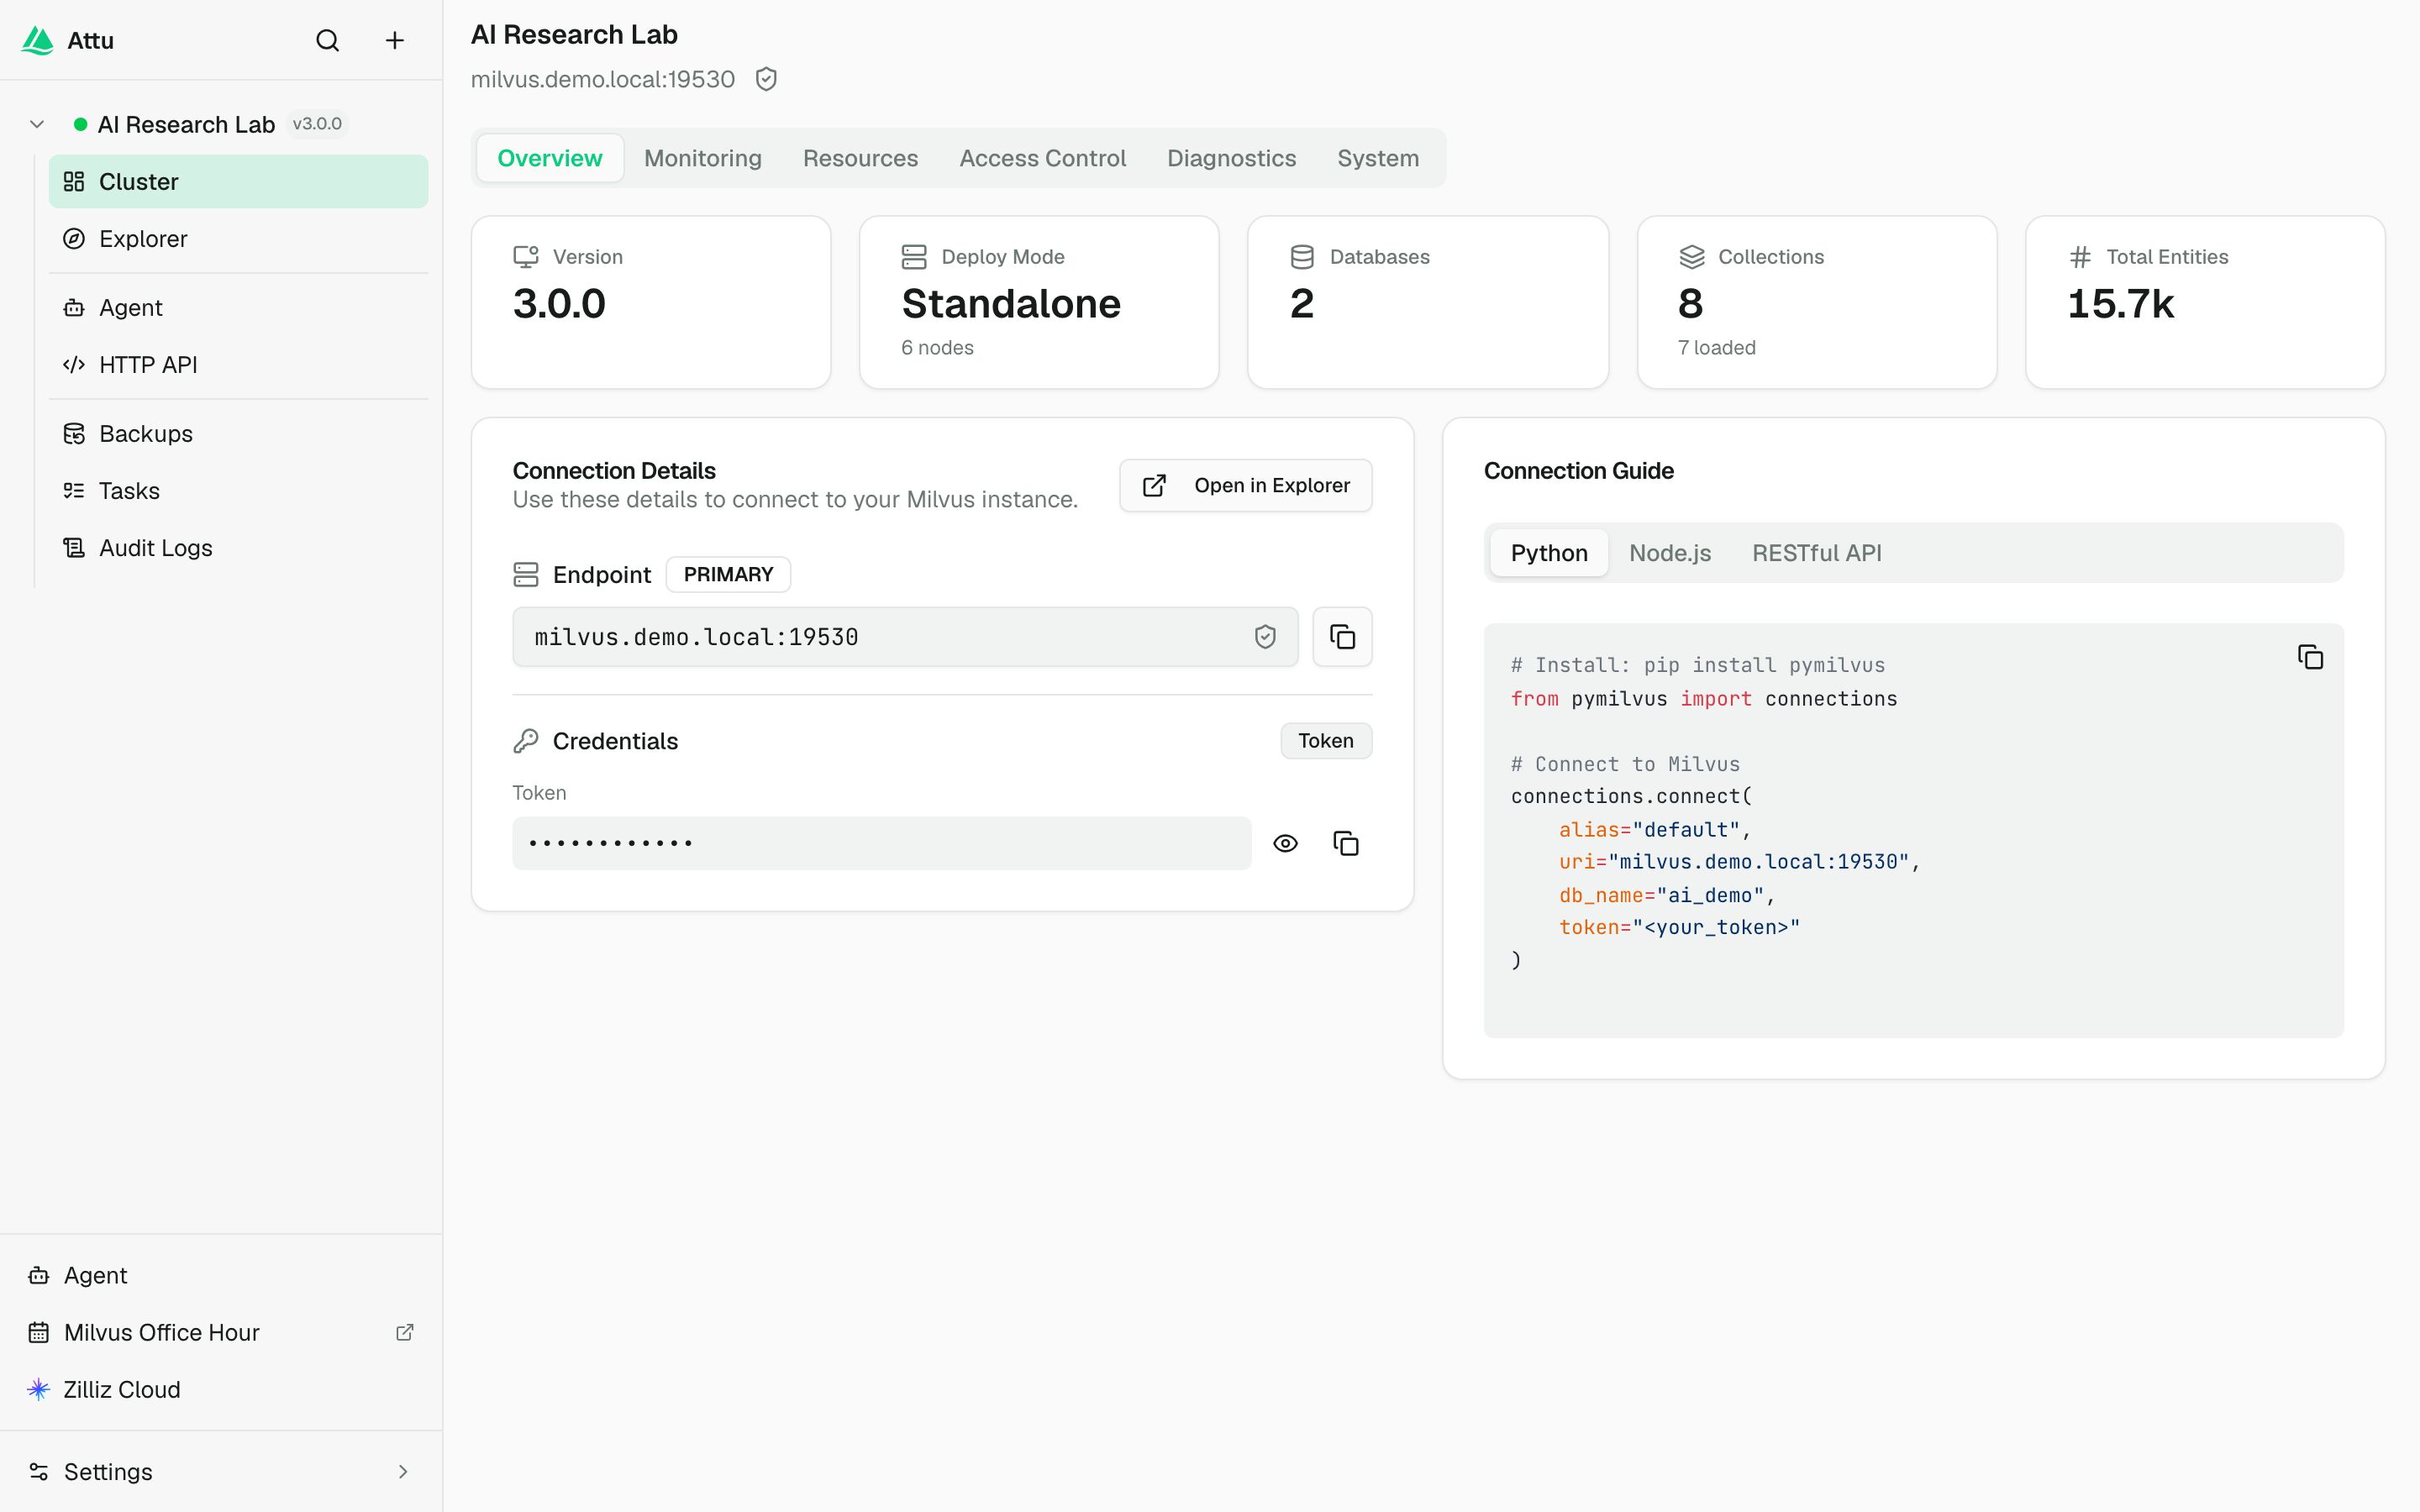
Milvus 向量数据库的图形化管理界面,可视化查看集合、索引和数据,省去手写命令的麻烦。
开箱即用的 AI Agent 微服务,用 Docker 一键部署,内置对话、函数调用和 MCP 客户端,帮你快速搭出可扩展的智能助手后端。
一套用来测试和实验提示词的开源工具,支持 OpenAI、LLaMA 等大模型以及 Chroma、Weaviate 等向量数据库,方便对比不同提示词的效果。

Pinecone 官方示例仓库,用 Jupyter Notebook 演示向量数据库的建库、检索和 RAG 语义搜索流程,适合快速上手实践。
用 Rust 写的高效近似最近邻检索算法库,集成 HNSW 等索引结构,为图像搜索、推荐系统等场景提供快速的向量相似度查询。

AI 原生 HTAP 数据库,内置向量检索和 Git-for-Data 数据版本管理,可作为智能体与 AI 应用的数据和记忆底座。
Rust 写的进程内搜索库兼多租户服务端,把 BM25 词法检索和向量检索揉在一起,适合做混合搜索和 RAG 的召回层。
一套 SIMD 加速的数值计算内核库,覆盖距离、点积、矩阵运算和地理几何计算,支持 16 种数值类型与多平台架构,为向量检索和科学计算提供底层高性能算子。
给 OpenCode 里的编码智能体加持久记忆的插件,用本地向量数据库存历史上下文,让 agent 跨会话记住之前做过的事。
纯 Java 实现的嵌入式向量搜索引擎,支持磁盘索引和增量更新,适合在 JVM 应用里直接做近似最近邻检索,不用额外部署服务。
基于 Next.js、OpenAI 和 Supabase 的文档搜索模板,帮你快速搭一个 ChatGPT 风格的问答式文档检索站。
兼容 MySQL 的多模态向量数据库,用统一 SQL 同时查询结构化与非结构化数据,支持向量 upsert 和检索,主打高并发、超低延迟。
汇总向量检索相关的库、服务和论文的 awesome 清单,帮你快速找到 KNN 搜索、相似度检索和向量搜索引擎的现成方案。
混合 AI 搜索引擎,能同时检索个人知识库和互联网,并自动生成带 UI 的页面,适合搭建 RAG 检索与内容生成场景。

一个用 Clojure 写的 Datalog 数据库,同时支持文档、图、键值和向量存储,还带全文检索,适合需要多种数据模型和向量检索的 AI 应用。
Milvus 向量数据库的官方 Python SDK,让 Python 开发者能直接建集合、写入向量并做相似度检索,是搭建 RAG 和向量搜索应用的基础客户端。

Qdrant 向量搜索引擎的官方 Python 客户端,方便在 Python 项目里接入向量检索,做相似度搜索和 RAG 应用。
基于邻域图和树结构的高维向量近邻检索库,用 C++ 实现,适合给向量数据库和 RAG 系统做低延迟的近似最近邻搜索。

基于 Java 的分布式内存数据网格和 NoSQL 键值存储,支持向量检索与语义搜索,可作为可扩展的缓存层或向量数据库用于 RAG 场景。
Endee.io – A high-performance vector database, designed to handle up to 1B vectors on a single node, delivering significant performance gains through optimized indexing and execution. Also available in the cloud at https://endee.io and under the Endee Enterprise license. Free 30-day evaluation: https://docs.endee.io/v2/quick-start/enterprise

提供 CUDA 加速的机器学习与信息检索基础算法和原语,方便快速搭建高性能应用,涵盖最近邻搜索、聚类、线性代数等常用模块。
用 Rust 写的高性能多线程 Redis/Valkey 替代品,可直接替换现有部署,并内置全文检索和向量搜索,适合做缓存和 RAG 检索后端。
LanceDB 官方的示例与教程合集,用向量检索搭配大模型,演示多模态 RAG、Agent 和微调等场景的落地写法。
基于 GPU 的向量检索与聚类库,为近似最近邻搜索和相似度计算提供 CUDA 加速,适合大规模向量数据和 LLM 检索场景。

可嵌入内存文档数据库,自带高层查询构建器,支持向量、全文和混合检索,适合在应用内直接做 RAG 与相似度搜索。
用 Rust 和 DataFusion 从零实现向量数据库,边写代码边学 HNSW、IVF 等近似最近邻检索原理,适合系统编程练手。
自托管的开源表情包搜索引擎,用语义搜索和向量数据库按含义而非文件名找梗图,适合在家庭服务器上部署。
把 Obsidian 笔记库改造成 AI 的持久工作记忆,用纯 Markdown 文件代替向量数据库,让智能体跨会话记住上下文。

一个多模态数据库,用单一 ACID 方案替代 MongoDB、Neo4J 和 Elastic,支持文档、图、键值存储,并提供 NetworkX、Pandas 接口和多语言绑定。
用 Rust 实现的多向量检索工具,把向量数据库和 grep 式搜索结合起来,支持从数据库到编码代理的检索场景。
C# .NET 的嵌入式 NoSQL 数据库,支持键值、对象存储、全文检索、语义检索和向量层,提供 ACID 事务,适合在应用内直接嵌入做多范式数据管理。