零代码微调平台
带 Web UI 的微调工具,适合快速试模型。
从零用 PyTorch 一步步实现类 ChatGPT 大语言模型,覆盖注意力机制、预训练、指令微调全流程,适合边跑代码边理解 LLM 内部原理。
面向 AI 应用的文档处理与 RAG 框架,把私有数据接入大模型,支持构建检索增强、智能体和多智能体应用。
多语言大语音生成模型,覆盖推理、训练到部署全流程,支持中英日粤语及跨语种合成,适合做语音克隆和对话机器人。
用 LoRA、Adapter 等少量参数微调大模型和扩散模型,大幅降低显存与训练成本,是 Hugging Face 生态里做参数高效微调的标准库。
Llama 官方示例手册,手把手教你在推理、微调、RAG 等场景中落地 Llama 系列模型,并覆盖多家云服务商的端到端方案。
把 DeepSeek、Llama 等开源大模型一键部署成兼容 OpenAI 的 API 服务,省去自己搭推理后端的麻烦。
低代码训练框架,用声明式配置就能构建和微调自定义 LLM、神经网络及其他 AI 模型,省去手写大量训练代码。
用一份 YAML 配置就能微调大模型,靠分层流式加载让 8B 模型在 4GB 显存的笔记本 GPU 上跑起来,省去手写训练脚本和显存焦虑。
一站式搞定 Qwen、Gemma 等开源大模型和多模态模型的微调(SFT/RL)、评测与部署,零代码也能上手。
用 Triton 重写 LLM 训练中的 RMSNorm、RoPE、交叉熵等关键算子,减少显存占用并提升微调吞吐,兼容 Llama、Mistral、Gemma、Phi 等主流模型。
无需写代码就能微调大语言模型的可视化界面,从数据准备到训练评估一站式完成,适合不想碰命令行直接调模型的团队。
轻量级自动机器学习库,能自动搜索模型和超参数,用较低算力快速找到不错的配置,适合分类、回归和调参场景。
RAG (Retrieval Augmented Generation) Framework for building modular, open source applications for production by TrueFoundry
低代码构建多智能体大模型应用的框架,把模型微调、知识库、数据流程等环节封装成简单接口,让开发者少写胶水代码就能搭出复杂 Agent 系统。
Multi-LoRA inference server that scales to 1000s of fine-tuned LLMs
整理 Text2SQL 及 Text2DSL、Text2API、Text2Vis 等自然语言转结构化查询方向的教程、数据集与论文资源,帮研究者快速入门并跟进大模型在该领域的最新进展。
一个能持续学习和自我进化的智能体框架,通过对话就能让 Agent 在线微调、积累技能,不用重新训练模型。

一站式扩散模型训练工具,支持 LoRA 和图像模型微调,提供图形界面,无需写代码即可完成训练配置。
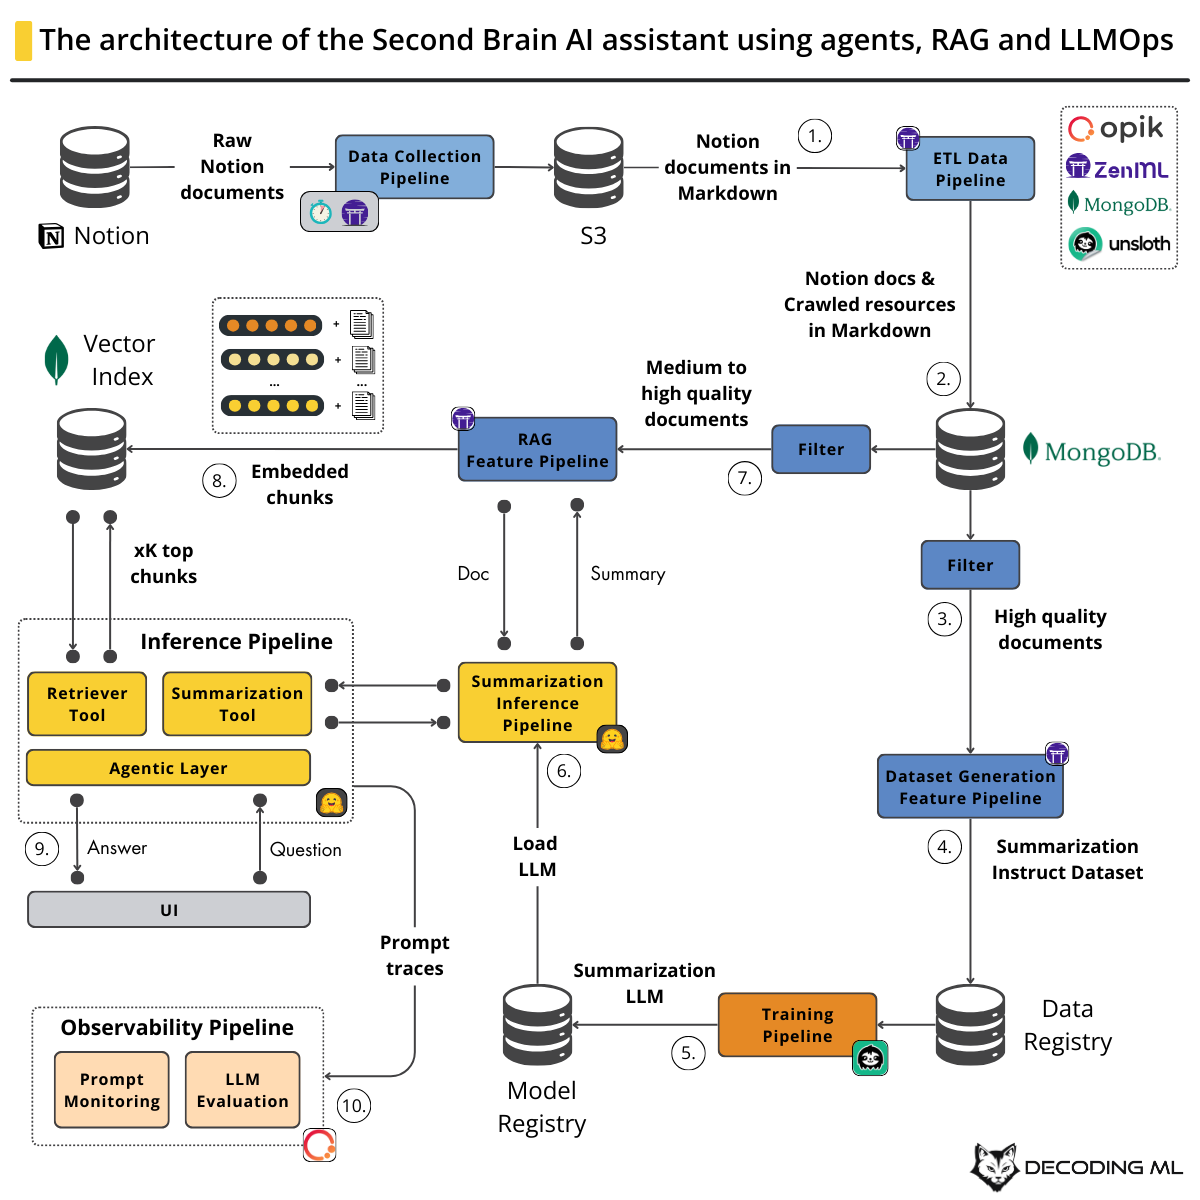
一套实战课程,教你用 LLM、Agent、RAG、微调和 LLMOps 搭建个人第二大脑 AI 助手,覆盖从数据工程到部署的完整链路。
用 PEFT 和 LoRA 对 Falcon、Llama、Llama2 等大模型做低成本微调的实战教程合集,以 Jupyter Notebook 形式提供可直接跑通的训练流程。
基于 PyTorch 的元学习研究库,提供 MAML、Meta-SGD 等算法实现和统一接口,方便快速复现和开发少样本学习、元强化学习实验。
一站式微调多模态模型的工具,支持 PaliGemma 2、Florence-2、Qwen2.5-VL 等,覆盖图像描述、目标检测和视觉问答任务,省去手写训练脚本的麻烦。
xTuring 提供从数据预处理到微调的完整流程,让开发者用 LoRA、Adapter 等轻量方法快速个性化开源大模型,降低训练门槛和显存开销。
用 Rust 封装 ONNX Runtime,让 ONNX 模型在 Rust 里跑推理和训练都很快,适合需要低延迟、无 Python 依赖的部署场景。
一套面向应用 AI 的实战教程,用 Jupyter Notebook 讲透大模型微调、推理与量化,帮工程师把 LLM 真正跑起来。
面向 GPU 工作负载的无服务器平台,可快速部署推理服务、沙箱和后台任务,按需自动扩缩容,省去自建集群的运维成本。
复现 DeepSeek Engram 记忆架构的研究项目,基于 Qwen-3 和 Stable Diffusion,用 LoRA/PEFT 给大模型注入外部记忆,免去全量微调。
用超网络仅凭任务文本描述就为 LLM 生成 LoRA 权重,免去标注数据和反向传播,让模型快速适配特定基准任务。
从 NLP 基础一路讲到 LLM 微调与部署的算法全栈教程,覆盖 BERT、LLaMA、LoRA 等内容,适合系统入门大模型。
基于 PyTorch 原生分布式训练的 LLM/VLM 训练库,开箱即用兼容 Hugging Face,方便微调 Llama、Gemma、GLM 等主流大模型。
面向企业和开发者的 OpenAI、Claude、Gemini 统一 API 代理,无需 OpenAI Key、账号或外币卡即可直接调用 GPT-5、Sora 等模型。

面向零基础学习者的 LLM 入门指南,涵盖微调、RAG、GPT/Llama 等实战路线,帮助快速跟上大模型前沿技术。
配套《Fine-Tuning LLMs with PyTorch and Hugging Face》一书的实战代码库,用 LoRA、PEFT、bitsandbytes 量化等手把手教你在消费级显卡上微调大模型。

开源大模型微调工具箱,支持 LoRA 等参数高效微调,还能做消融实验和单元测试,方便快速验证 Llama2、Mistral、Falcon 等模型在分类任务上的效果。
Halo 是 White Circle 开源的大模型与多模态模型训练框架,支持分布式训练、LoRA 微调、MoE 和异步强化学习,方便搭建和扩展训练流程。
单卡微调大模型前的显存预检工具,估算显存占用并给出可直接跑的 LoRA/QLoRA 配置,避免盲目开训就爆显存。
一套不依赖框架的 Colab 实战笔记本,覆盖模型 API、结构化输出、工具调用、RAG、评测、Agent 循环、LoRA 微调与提示注入防护,帮 AI 工程师和 FDE 快速上手真实技能。
一站式 LoRA 与微调工作室,支持 Klein 9B、Qwen Image 2.1、Z-Image Turbo 等图像、视频、音乐模型,可训练、微调、分析、修复并提取 LoRA/LoKR。
用 Docker 和 BuildKit 把开源大模型的微调、构建与部署串成一条流水线,并直接发布到 Kubernetes 上运行推理。
把 Ostris 的 AI-Toolkit 打包成 Windows 一键便携安装包,省去配环境、装依赖的麻烦,直接开跑 LoRA 和 Stable Diffusion 微调。
基于微软 VibeVoice 的多说话人语音合成 Web 系统,支持 LoRA 微调、批量生成和显存优化,开箱即用。
PiSSA 是一种参数高效微调方法,用主奇异值和奇异向量初始化 LoRA 的低秩矩阵,让大模型微调收敛更快、效果更好。

给 Minecraft 智能体提供开放世界技能的开源方案,通过微调大语言模型让智能体在游戏中自主完成多样化任务。
极简的多模态大模型微调代码库,支持 LLaVA、Qwen-VL、Llama-3.2-Vision 等主流视觉语言模型,方便快速做指令微调实验。
基于微调大语言模型的知识库问答框架,先生成逻辑形式再检索,提升复杂问题在知识图谱上的 SPARQL 查询准确率。
在 Apple Silicon Mac 上本地运行 Phi-3、Phi-3.5 和 Phi-4 视觉与语言模型,基于 MLX 和 Metal 加速,支持微调、LoRA 与多智能体编排。
在神经网络层面实时干预基础模型的输出,用 PyTorch 和 Jupyter Notebook 做液态神经网络与注意力机制的可视化微调实验。

系统梳理大模型有害微调攻击的综述,汇总攻击与防御方法,帮安全研究者快速掌握微调带来的对齐失效风险。
NVIDIA Alpamayo 的开发者配方库,提供自动驾驶与机器人模型的微调、强化学习后训练、量化和部署现成方案,省去从零搭建流程的麻烦。