AI · 算法工程
共 1,645 个仓库 · Python
一站式视觉模型训练工具,支持 YOLO、ViT、RT-DETR、DINOv3 等模型的预训练、微调与知识蒸馏,省去自己搭训练流程的麻烦。
一个仅 100 万参数的轻量 OCR 模型,在 CPU 上就能跑,速度比 tesseract 快 15 倍,精度接近十亿参数级大模型,适合文档解析和 RAG 场景。
用 Transformer 从单目视频里重建并跟踪三维人体,输出带 SMPL 参数的动作序列,适合做人体建模和动作分析。
一套 0.8B 到 27B 的开源决策模型,一次前向就能为每个选项给出校准概率,只在不确定时才输出简短思考;配套 vLLM、llama.cpp 和 MLX 推理引擎。
YOLOv13 的官方实现,用超图增强的自适应视觉感知提升实时目标检测精度,适合需要落地部署检测模型的场景。
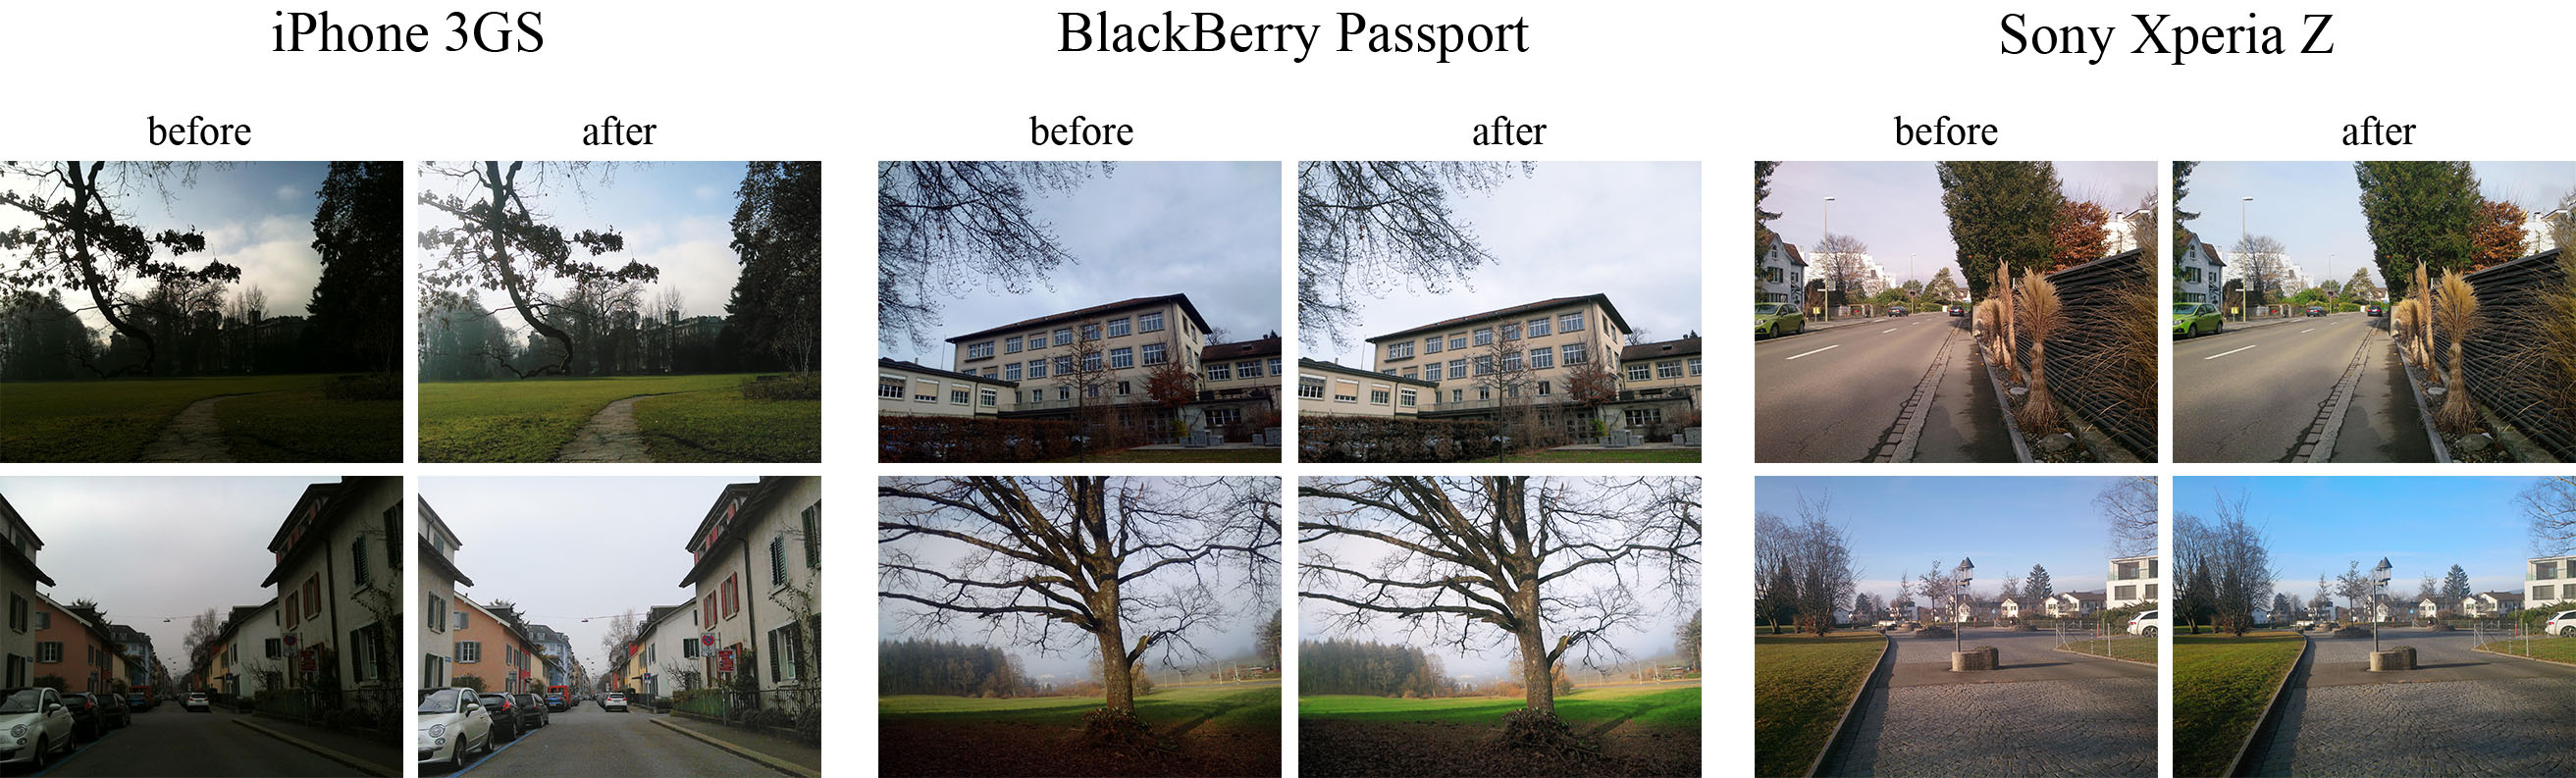
用深度卷积网络自动提升照片画质,提供预训练模型和训练代码,可把手机照片修出单反质感。
ImageReward 是 NeurIPS 2023 提出的文本生图人类偏好奖励模型,用人类偏好数据训练打分器,评估生成图像质量并支持 RLHF 微调扩散模型。
开源 MLOps 平台,把数据、模型训练、流水线和在线服务串成一条自动化链路,方便在 K8s 和 CI/CD 环境里持续交付机器学习应用。
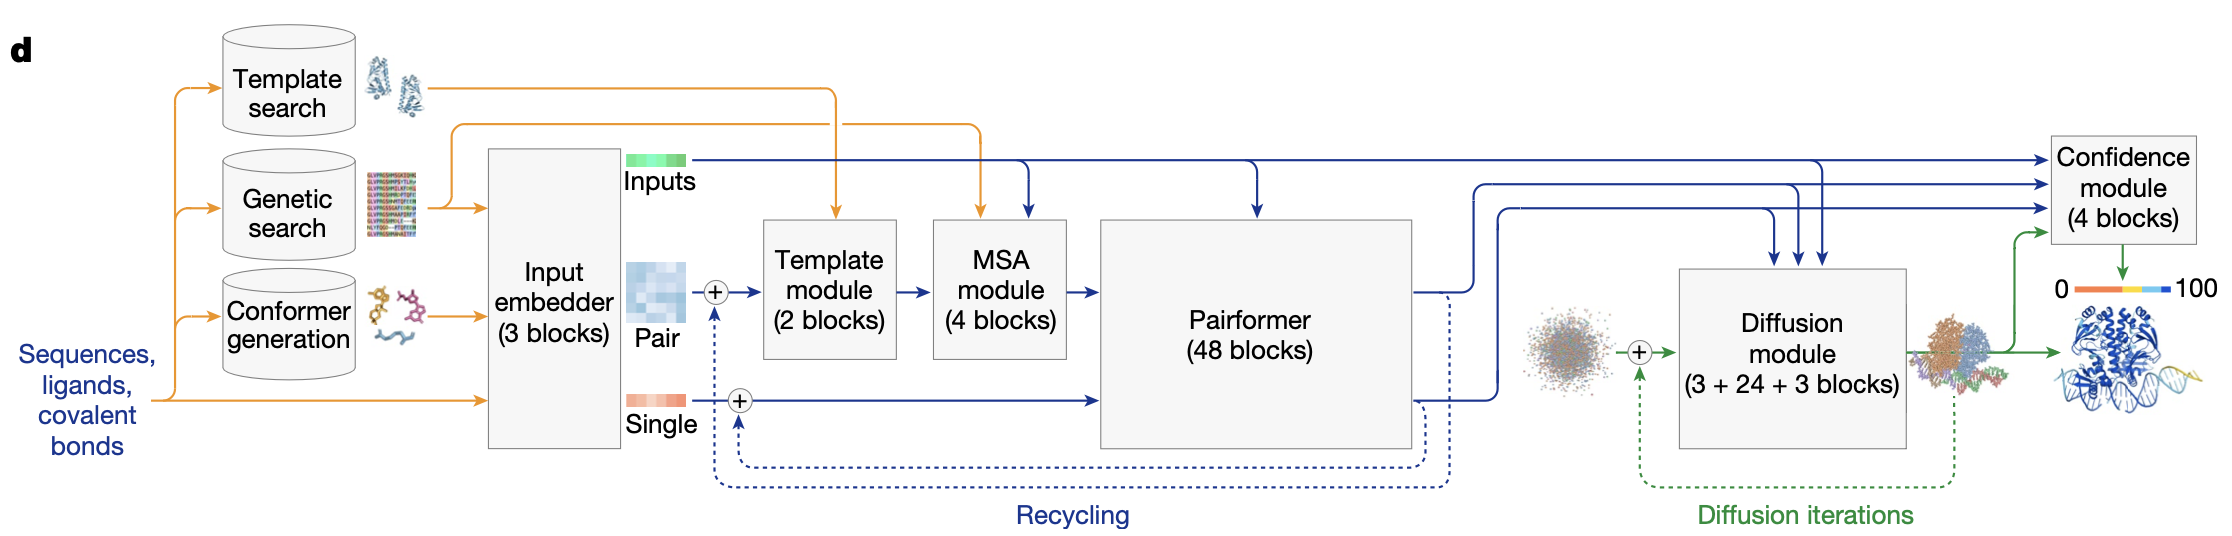
用 PyTorch 复现 DeepMind AlphaFold 3 的蛋白质结构预测模型,包含注意力机制与去噪扩散模块,方便研究和二次开发。
Intel 开源的模型量化工具,用训练后量化的低成本达到量化感知训练级别的精度,支持 int4、GGUF、MXFP4 等格式,可直接对接 vLLM、SGLang 推理。
面向日语文档的 AI 图像解析 Python 包,可完成版面分析和 OCR,把扫描件或照片里的日文内容结构化提取出来。
用 Python 搭建 WhatsApp 智能体 Ava 的实战课程,串联语音转写、语音合成和向量数据库,带你跑通一个能对话的 Agent 完整流程。
开源的多模态大扩散语言模型,用块扩散、混合思维链和统一强化学习,把多模态理解与生成放进同一个模型里做。
用结构化数据和链式调用语法在代码里快速搭建 GenAI 应用与智能体,并用事件驱动流程编排复杂逻辑,切换模型无需改代码。

基于 PyTorch 的端到端神经压缩研究库与评测平台,提供预训练模型、常用网络结构和指标,方便复现和对比学习类图像压缩算法。
用自然语言加无限画布编排 AI 视频创作流程,把剧本拆解、分镜、素材生成到合成串成可编辑的工作流,支持自托管。
在 Apple Silicon 上跑大模型的高性能推理服务,兼容 OpenAI 和 Anthropic 接口,支持 MLX 原生加速、连续批处理、多模态和 MCP 工具调用。
DEIM 是一个面向实时目标检测的 DETR 改进方案,通过优化一对一匹配策略加速模型收敛,让 DETR 系列检测器训练更快、精度更高。
BiSeNet 语义分割网络的 PyTorch 实现,支持 Cityscapes、ADE20K、COCO-Stuff 数据集,并提供 ncnn、OpenVINO、TensorRT、Triton 等推理部署方案。
基于 PyTorch 的知识蒸馏框架,无需写代码即可复现和对比 28 种顶会蒸馏方法,附带训练模型、日志和配置,方便做可复现的深度学习研究。
Soprano 是一个超写实、低延迟的文本转语音引擎,能把文字快速合成接近真人音色的语音,适合需要即时发声的场景。
一个能自我创建、持续在后台运行的通用 AI 智能体,可自主完成编码、操作桌面等任务,适合需要长期自主执行能力的场景。
基于扩散模型生成逼真说话人像视频,通过连贯运动合成让口型与头部动作自然同步,适合做数字人播报和虚拟主播。
基于安全强化学习的人类反馈对齐框架,通过约束优化让大模型在有用性和安全性之间取得平衡,附带 Beaver 系列模型与数据集。