AI · 算法工程
共 1,644 个仓库 · Python
抓取系统音频和麦克风,用 Whisper/SenseVoice 做语音识别,再通过 LLM API 流式翻译并实时显示字幕,适合主播、VTuber 和看外语视频时用。
用高分辨率语义编码器把视觉理解与图像生成统一到一个模型里,既能读懂图片,也能做文生图和图像编辑。
统一的世界模型代码库,整合扩散模型、高斯泼溅、3D 场景生成与视频编辑等能力,方便研究和复现各类世界模型。
基于 PyTorch 的通用分割精修网络,通过全局与局部级联细化,把任意已有分割掩码提升到超高分辨率,无需针对特定类别重训。

本地离线运行的便携式 OCR 软件,用 DeepSeek-OCR-2 模型直接在你自己机器上识别图片和 PDF,适合不想把文档传到云端的场景。
一个高效易用的深度学习模型压缩框架,支持剪枝、训练后量化和量化感知训练,能把 PyTorch 模型转换部署到端侧。
基于 Playwright 的 MCP 服务器,让 AI Agent 在反检测隐身 Firefox 上浏览网页,绕过反爬和验证码,适合自动化抓取与求职等场景。
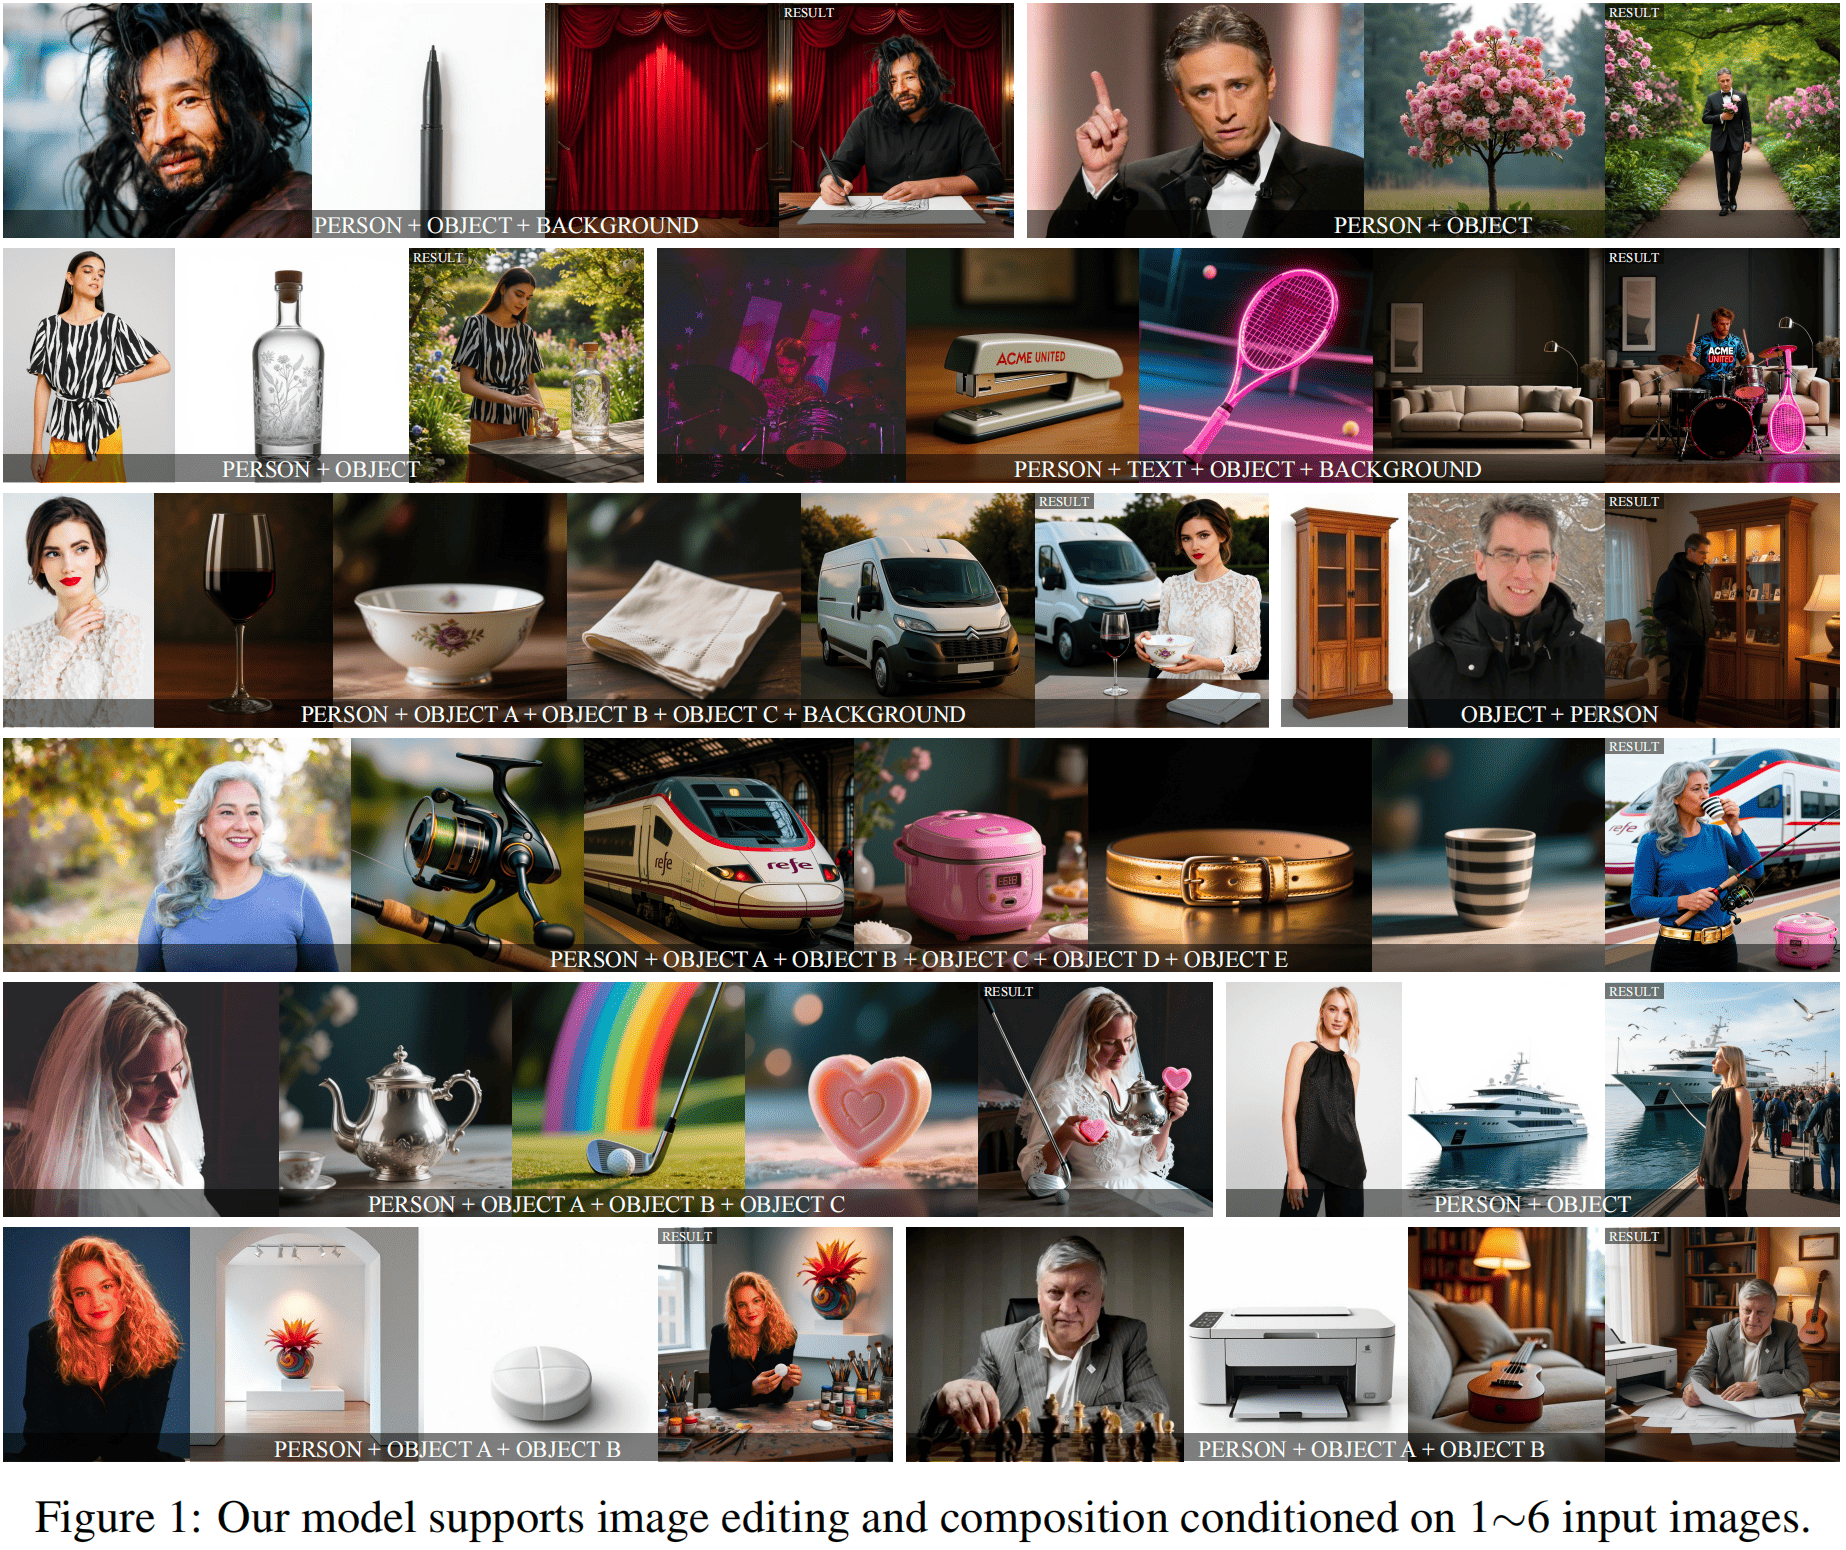
开源的多图编辑扩散模型,支持同时处理多张输入图像进行编辑与生成,适合需要批量或组合式图像编辑的场景。
把本地代码库切块并生成向量索引,通过 MCP 服务让 LLM 和 Neovim 按语义检索相关代码,省去手动翻文件。
OpenCUA 提供构建电脑操作智能体(CUA)的开放基础,包含数据集、基础模型和评测基准,让 GUI 自动化智能体有可复现的训练与评估方案。
自托管的 RSS 阅读器兼个人知识管理工具,内置 MCP Server,可让 AI Agent 直接读取订阅内容并整理知识。

开源大模型微调工具箱,支持 LoRA 等参数高效微调,还能做消融实验和单元测试,方便快速验证 Llama2、Mistral、Falcon 等模型在分类任务上的效果。

把 3D 高斯泼溅烘焙进扩散去噪器,单阶段从单张图快速生成和重建可扩展的 3D 场景与网格,免去多阶段流程。
基于 PaddlePaddle 的端到端中文语音识别项目,提供 DeepSpeech2、Conformer、Squeezeformer 等主流模型,既有入门案例也有企业级实战方案。
基于 Python 的视频分析与计算机视觉框架,内置 NVIDIA DeepStream 和 CUDA 支持,可在边缘设备上快速搭建目标检测、实例分割等推理流水线。

基于扩散模型的身份保持文本到视频生成方案,通过频域分解在生成视频中稳定保持人物面部身份,适合做可控人物视频生成。
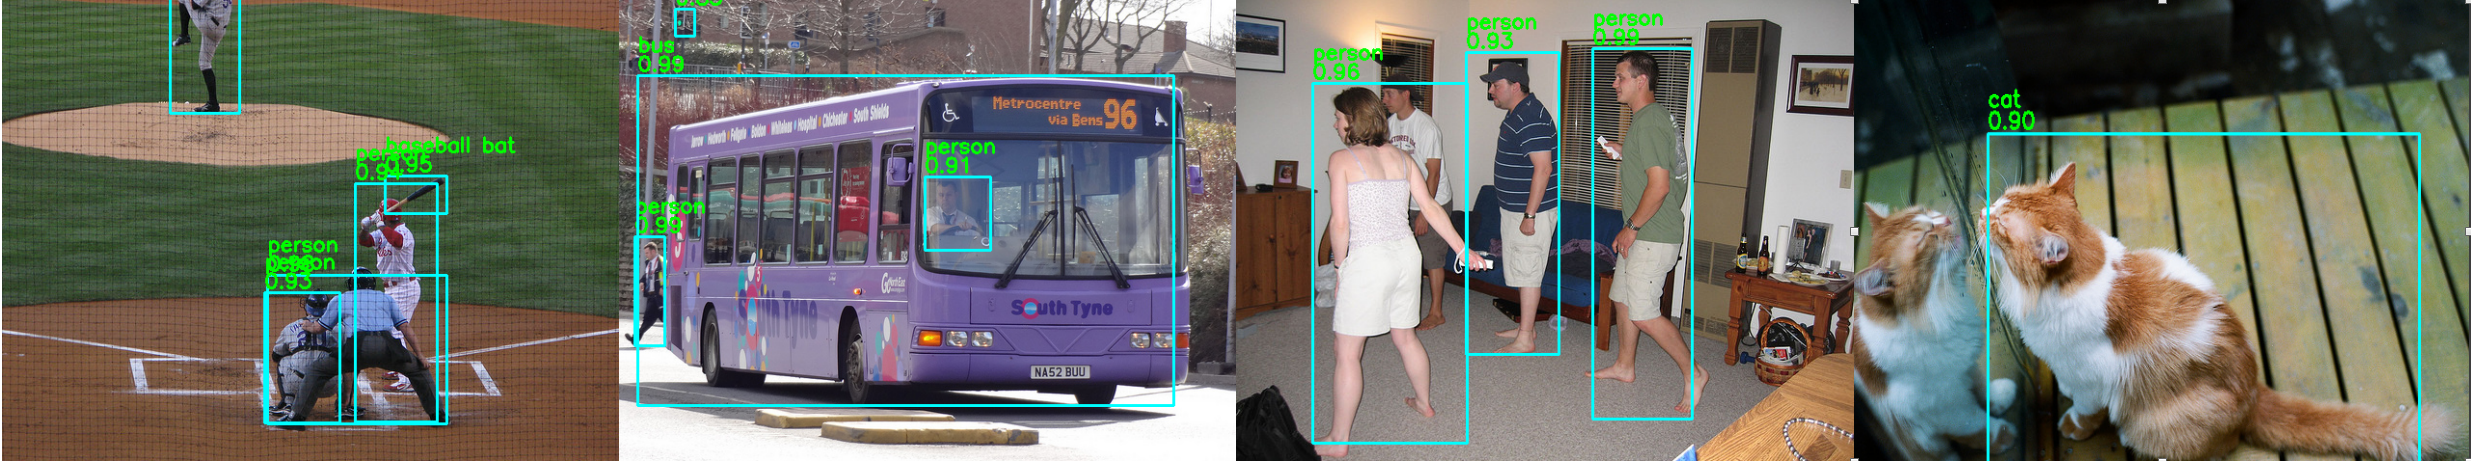
超轻量无锚框目标检测算法,权重仅 250K 参数,比 yolo-fastest 快 10%,后处理更简单,适合边缘设备部署。
在浏览器里跑安卓模拟器,为移动 GUI 智能体提供可验证、高并发的评测与在线强化学习训练环境。
Halo 是 White Circle 开源的大模型与多模态模型训练框架,支持分布式训练、LoRA 微调、MoE 和异步强化学习,方便搭建和扩展训练流程。
DIPY 是 Python 的 3D/4D 医学影像处理库,覆盖扩散、灌注与结构成像,提供配准、去噪、机器学习和可视化等通用方法。
面向 Mac 和 NVIDIA DGX Spark 的 AI 电影制作工作室,按剧组流程规划分镜,并用 Qwen-Image、FLUX、MiniMax 等模型生成带声音的画面与视频。
一份轻量规则文件,帮你在 Cursor、Windsurf 等 AI 编码工具里用更少的调用次数完成更多任务,节省每月额度。
Grounding DINO 的第三方复现实现,把 DINO 检测器与图文预训练结合,支持用自然语言描述做开放世界目标检测。
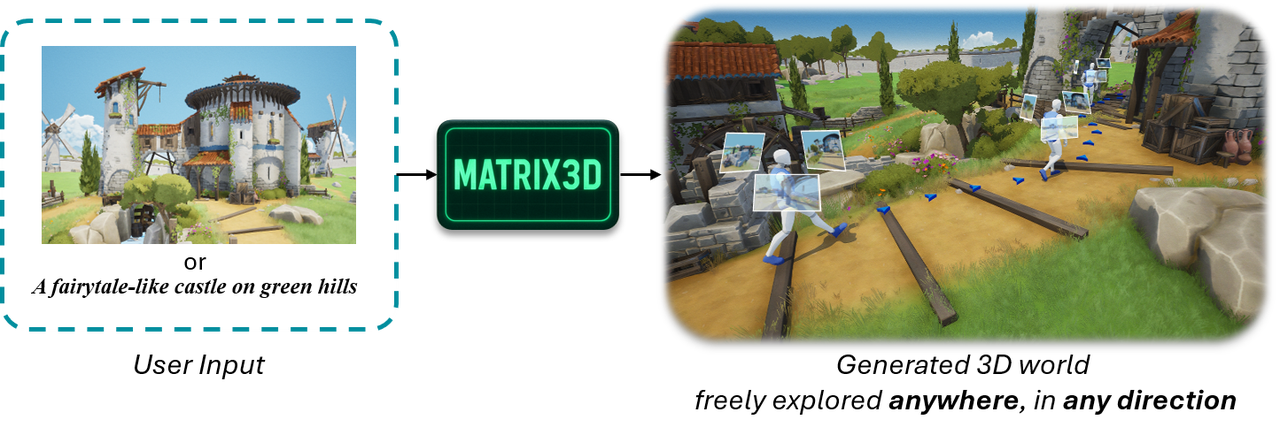
从单张图片或一句文本提示生成大范围可漫游的 3D 场景,先产出高质量全景视频再重建三维空间,适合做可探索虚拟场景。