AI · 算法工程

共 1,644 个仓库 · Python

打开分类页
SkillCorpus
EverMind-AI·Python

把散落的 SKILL.md 文件整理成可检索、可评测的智能体技能语料库,自带检索与评测工具,方便给 Agent 搭建技能库。
智能体技能+4Agent 框架
701+2117v0.4.02026-11-09 05:09 UTC
long-context-attention
feifeibear·Python

统一序列并行注意力实现,把 Ulysses 和 Ring Attention 混合成 2D 并行,让长上下文 Transformer 训练和推理能扩展到超长序列。
序列并行+4大模型推理服务
696860.6.42026-09-16 06:06 UTC
mvsnerf
apchenstu·Python

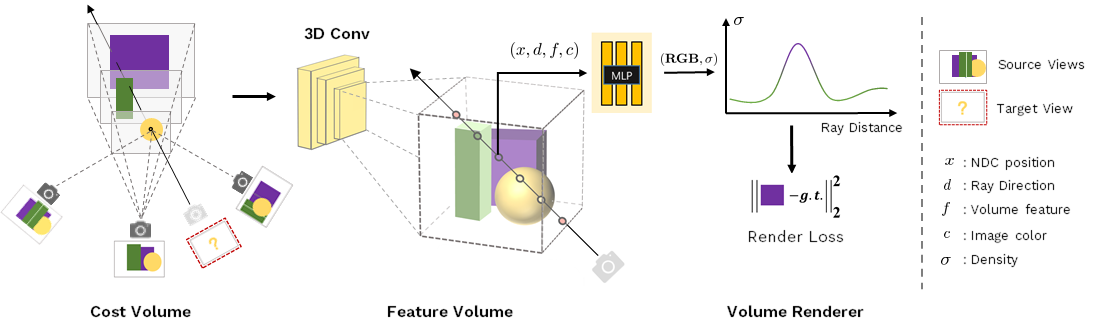
ICCV 2021 提出的神经渲染方法,能从多视角图像高效重建几何与神经辐射场,用于新视角合成。

神经辐射场+33D 重建
696832025-06-19 20:06 UTC
multi-object-tracker
adipandas·Python

Python 实现的多目标跟踪算法集合,集成 IoU Tracker 等多种跟踪器,配合 OpenCV 和 SSD-MobileNet 等检测模型,快速搭建视频目标跟踪流程。

多目标跟踪+4检测 / 分割
6961012026-07-17 02:37 UTC
Awesome-CUA
reacher-z·Python

收录计算机使用智能体(CUA)的开放资源清单,整理经过审阅的论文、GUI 模型、数据集、基准测试和工具,并提供可直接复用的 JSONL/SQLite 数据。

计算机使用智能体+4Agent 框架
693+139140v2026.10.182026-11-10 17:05 UTC
timber
kossisoroyce·Python

把 XGBoost、LightGBM、scikit-learn、CatBoost 和 ONNX 模型一键编译成原生 C99 推理代码,省去 Python 运行时开销,推理速度最高提升 336 倍。

模型编译+4编译器 / 运行时
69023v0.6.02026-04-16 16:38 UTC
YUME
stdstu12·Python

Yume 是一个交互式世界模型,支持文本或图像驱动实时视频生成,可用于构建可交互的虚拟场景。

世界模型+4视频生成
685442026-01-14 04:05 UTC
openlrc
zh-plus·Python

用 Whisper 把音频转成文字,再调用 GPT、Claude 等大模型翻译润色,直接输出 LRC 字幕文件,省去手动打轴和翻译的麻烦。
语音转字幕+4语音推理
685541.7.0a22026-08-10 09:21 UTC
OmniVinci
NVlabs·Python

OmniVinci 是英伟达开源的全模态大模型,能同时理解视觉、音频和语言三种输入,适合做多模态联合推理与训练研究。

全模态大模型+4视觉语言模型
684552026-08-31 06:28 UTC
agnes-video-generator
lcy362·Python

开源自托管的 AI 视频生成器,在网页界面里输入文字就能生成带旁白、字幕和数字主播的多场景视频,完全免费。

视频生成+4视频生成
680+19237v7.5.12026-11-10 12:01 UTC
buffer-of-thought-llm
YangLing0818·Python

用「思维模板」库增强大模型推理:把可复用的推理思路存成元缓冲区,遇到新问题时检索并套用,提升复杂任务准确率并降低成本。

思维增强推理+4RAG 框架
678662025-06-28 11:56 UTC
wcgw
rusiaaman·Python

Shell and coding agent on mcp clients

编码 Agent
678672026-09-12 18:18 UTC
HunyuanImage-2.1
Tencent-Hunyuan·Python

腾讯混元开源的 2K 高分辨率文生图扩散模型,能根据文字直接生成高清图像,兼顾生成效率与画质。

文生图+4图像生成
676552025-10-14 06:38 UTC
pyannote-whisper
yinruiqing·Python

用 pyannote 做说话人分离、Whisper 做语音识别,把会议录音转成带说话人标记的文字,再交给 ChatGPT 生成会议纪要。

说话人分离+4语音推理
6751072025-09-24 06:49 UTC
pyRANSAC-3D
leomariga·Python

用 RANSAC 从点云中拟合平面、球、圆柱、长方体、圆和直线等 3D 基元,适合 LiDAR 与三维重建场景做形状检测和分割。

点云分割+43D 重建
67480v0.7.02026-08-28 22:11 UTC
RAGLight
Bessouat40·Python

模块化 RAG 框架,能自由替换 LLM、嵌入模型和向量库,还支持 MCP 接入外部工具与数据源,省去重复搭建检索增强流程的功夫。

检索增强生成+4RAG 框架
6721023.4.72026-10-16 12:17 UTC
DFloat11
LeanModels·Python

面向 LLM 和扩散 Transformer 的无损压缩方案,在 GPU 推理时压缩模型权重、降低显存占用,同时保持输出完全一致。
无损压缩+4量化
666402025-11-24 09:46 UTC
FoleyCrafter
open-mmlab·Python

给无声视频自动配上生动且与画面同步的音效,基于扩散模型实现视频到音频的拟音合成。
视频拟音+4图像生成
665682026-06-15 04:39 UTC
Open-dLLM
pengzhangzhi·Python

开源的扩散式语言模型,专攻代码生成,一并放出预训练、评测、推理代码和模型权重,方便直接复现和二次开发。

扩散语言模型+4图像生成
66452v1.02026-07-20 19:31 UTC
ReconViaGen
GAP-LAB-CUHK-SZ·Python

用生成模型提升多视角 3D 物体重建精度,从多张图片还原准确的三维形状与位姿,适合做图像到 3D 的研究与落地。

三维重建+43D 生成
664222026-04-04 14:17 UTC
Cambium
KimGLee·Python

给 LLM 维护的知识库定治理规范,并提供参考工具链,让 AI 代理改文档时有确定性校验和人工审核,避免知识库越改越乱。

知识治理+4Agent 框架
663422026-09-12 08:44 UTC
llama-cpp-agent
Maximilian-Winter·Python

基于 llama.cpp 的 LLM 智能体框架,支持对话、结构化函数调用和结构化输出,即使模型未针对 JSON 或函数调用微调也能用。
智能体框架+4Agent 框架
662720.2.352026-03-09 05:57 UTC
Open-AgentRL
Gen-Verse·Python

面向 LLM 与 Agent 场景的开源强化学习训练库,集成 GRPO、PPO、熵方法等算法,支持编码、GUI、多智能体等任务。

强化学习+4编码 Agent
661592026-06-12 09:28 UTC
NOVA
baaivision·Python

NOVA 是一种无需向量量化的自回归视频生成方法,用扩散式连续表示替代离散 token,绕开 VQ 编解码器直接生成视频。

视频生成+4图像生成
661212025-10-29 02:21 UTC