AI · 算法工程
共 191 个仓库 · Rust

轻量级 VPS 监控方案,由 Rust 编写的采集端和 Axum 服务端配合 React 网页面板,自托管即可实时查看服务器状态。
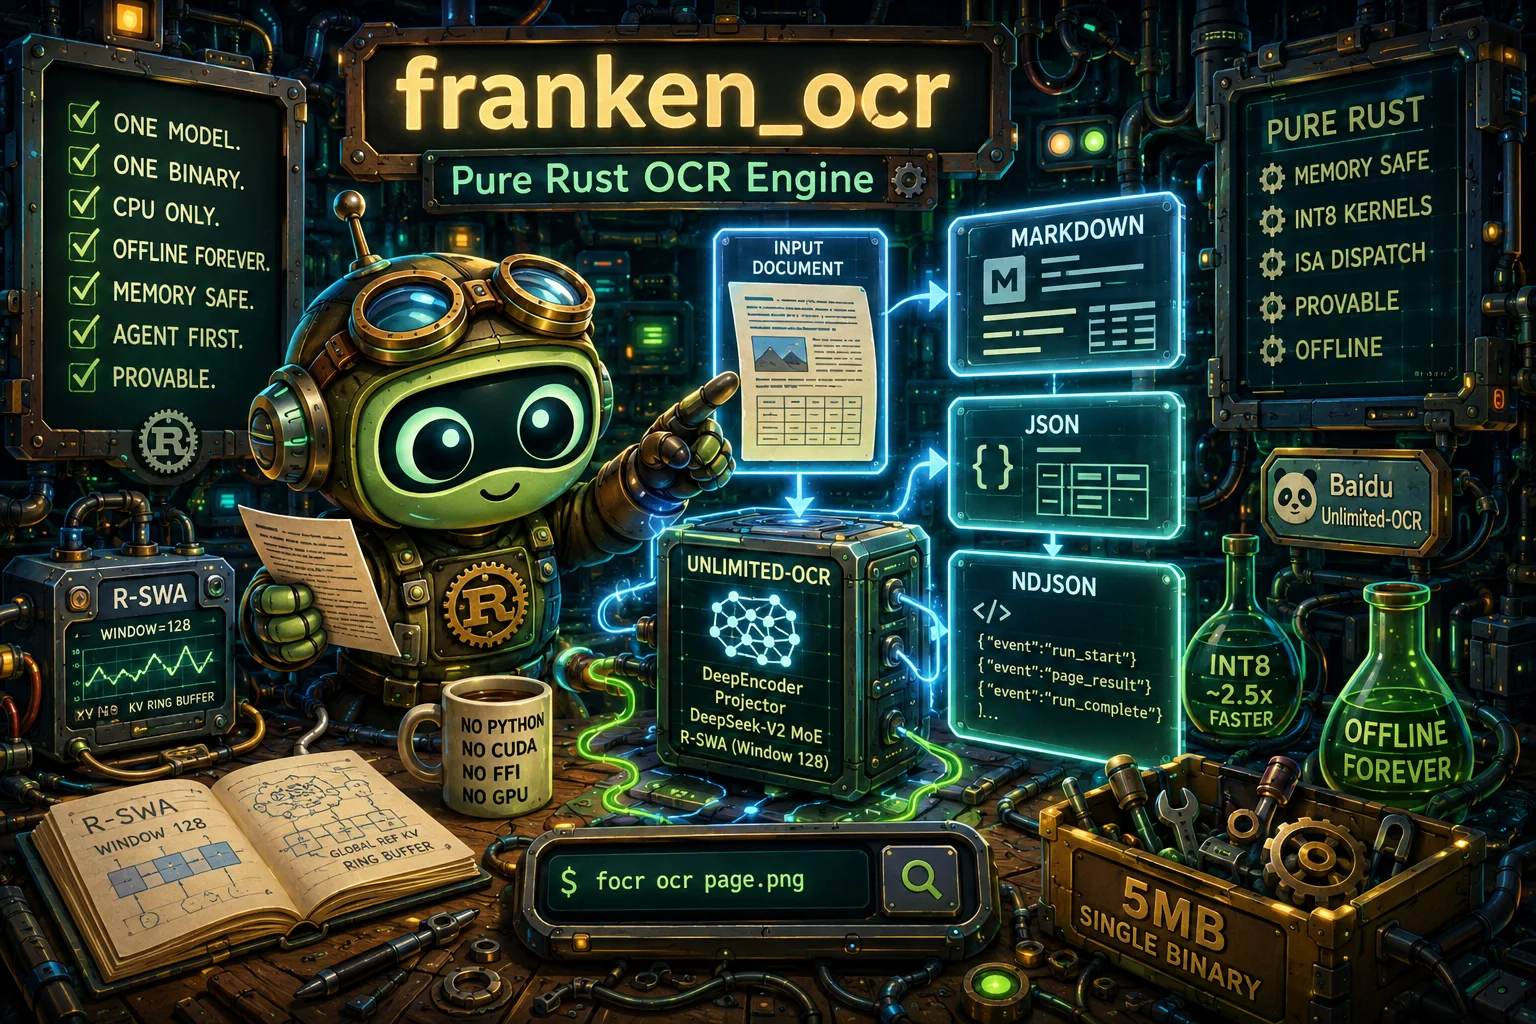
纯 Rust 实现的 CPU 端 OCR 引擎,跑百度 Unlimited-OCR 这个 3B MoE 视觉语言模型,自带 int8 定制算子,不依赖 ML 框架、Python 或 GPU。
基于 MCP 协议的桌面自动化服务器,让任意 AI Agent 通过 stdio 控制屏幕、窗口、鼠标键盘和 Chrome 浏览器,实现 computer use 能力。
面向 Apple Silicon 的本地大模型推理与微调框架,用 Rust 实现,支持 LoRA/QLoRA 微调、量化、模型服务和 MLX/Metal 加速。
用 Rust 和 WebGPU 实现的 3D Gaussian Splatting 渲染器,让浏览器端也能高效渲染三维高斯泼溅场景。
基于 Zed 和 pi 打造的 macOS 原生 AI 编码 Agent 工作台,把代码编辑与审查、浏览器操作、电脑操控和全局权限管控整合到一处。

让 PC 开机直接进入大模型运行环境,基于 Rust 的 UEFI 常驻方案,底层不需要操作系统,省去启动系统开销。
Rust 写的超快日文分词器,用逐点预测模型做形态素分割,适合需要低延迟、高吞吐的 NLP 流水线。
为 Bevy 引擎提供高斯泼溅渲染管线插件,让 Rust 游戏和 3D 应用能直接加载并实时渲染 3D Gaussian Splatting 场景。
面向智能体应用的一站式后端底座,把 AI 网关、数据建模和 CRUD API 串起来,省去自己拼装 LLM 路由与可观测性。
用 Rust 写的 Vim 风格模态文本编辑器,内置 AI 编码 Agent 和 LSP 支持,适合想要 Neovim 式操作又需要 AI 辅助写代码的开发者。
面向 vLLM 和 SGLang 的 KV cache 复用层,用 Rust 实现,把前缀缓存扩展到 DRAM、SSD 和跨主机,降低大模型推理的重复计算和显存压力。
统一调用 170+ 家 LLM 提供商的单一 API 客户端,Rust 内核并提供各主流语言原生绑定,省去为每家模型单独对接的麻烦。
自托管的网页抓取与文档解析服务,把 URL、带 OCR 的 PDF 和 Office 文件转成干净的 Markdown/JSON 供 AI Agent 使用,兼容 Firecrawl 和 Jina 接口,单个 Rust 二进制即可部署。
用 Rust 打造的浏览器智能体,能真正理解 Instagram、LinkedIn 等社交平台,快速精准地完成深度调研与自动化操作。
用 Rust 写的 NVIDIA GPU 终端监控面板,能实时查看显存占用和进程,比反复敲 nvidia-smi 更直观高效。
用 Rust + CUDA 写的 SSD 流式推理引擎,让消费级 16GB 显卡也能跑 743B 级 MoE 大模型,自动测 PCIe 带宽并分配注意力与热专家。

面向 LLM 推理的高性能 KV cache 存储层,通过 GPU 卸载、SSD 缓存和 RDMA 跨节点共享,缓解长上下文推理的显存瓶颈,兼容 vLLM 与 SGLang。
Rust 原生本地推理后端,支持 GGUF 模型和量化,在 Apple Silicon 与 Windows 上跑 LLM,并提供 OpenAI 兼容接口。
用 Rust 封装 ONNX Runtime 跑 Ultralytics YOLO 推理,支持 CUDA、CoreML、OpenVINO 等 GPU 后端,还带命令行和 WebGPU/WASM,方便在本地或浏览器里做目标检测、分割、姿态估计。
用 Rust 写的开源 AI 网关,把 OpenAI、Anthropic、Gemini、Bedrock 等模型统一到一个 OpenAI 兼容接口,顺带做路由、护栏、缓存、限流和可观测性。
面向 AI Agent 的执行控制平面,统一管控模型请求、MCP 工具调用、A2A 委派和下游动作,同时保持原生 LLM 协议不变,支持多模型接入与故障切换。
跨平台操作系统自动化编排层,用 TypeScript、Rust、Python、Go 的 SDK 统一驱动桌面和手机 GUI 操作,零 token 成本,替代 computer use 方案。