推理与服务
共 679 个仓库 · 一年内有推送
在 iOS 和 macOS 上离线运行 LLaMA、GPT-2、RWKV 等大语言模型的 Swift 应用,基于 GGML 库,无需联网即可本地推理。
按公司分类整理的 AI 工程面试题库,覆盖 LLM 推理等方向的问题与答案,适合面试前按目标公司集中刷题准备。
为 LLM 推理提供虚拟化弹性 KV Cache,让多个推理任务动态共享 GPU 显存,减少显存碎片和浪费,提升 GPU 利用率。
专为 AMD Ryzen AI NPU 深度优化的本地大模型推理引擎,几分钟内就能在 AMD NPU 上跑起 LLM,省去繁琐配置。
开源推理研究平台,用于在 AMD、CUDA 等不同 GPU 上对 LLM 推理服务做基准测试和性能对比,帮团队选型加速卡。
汇集各类 RAG(检索增强生成)框架、项目和资源的社区清单,方便快速找到并对比检索增强生成生态里的现成方案。
开源工业级语音识别模型,支持普通话、中文方言和英语,在公开普通话 ASR 榜单上刷新 SOTA,还能精准识别歌词。
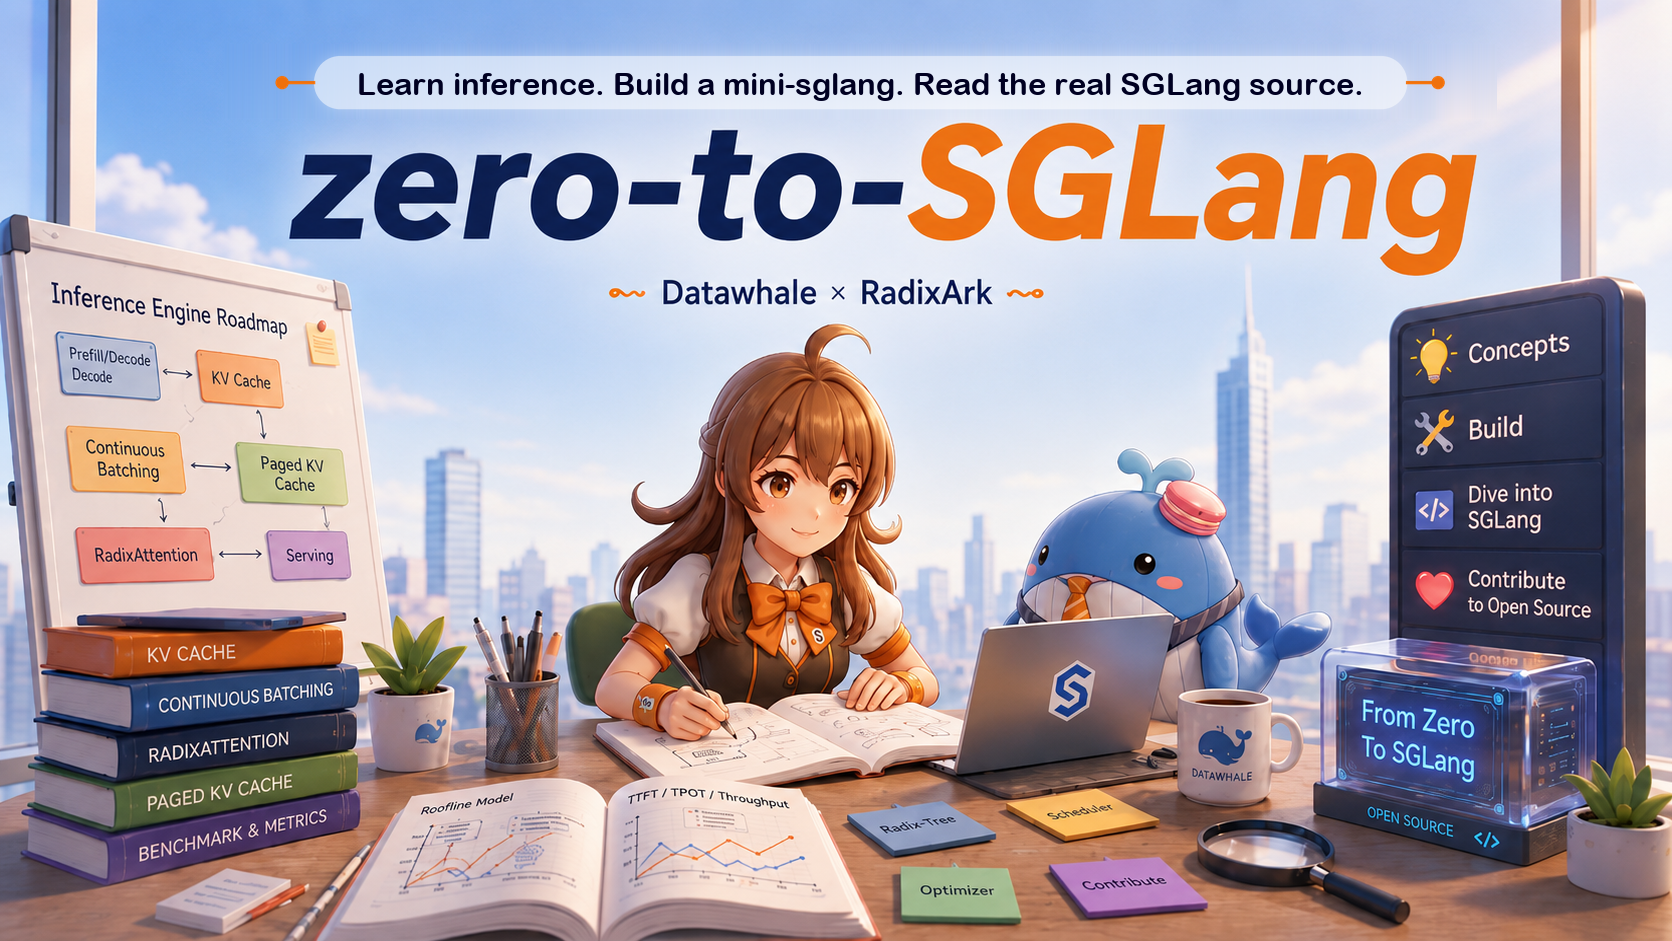
Datawhale 与 SGLang 官方合作的 LLM 推理课程,从零手写 mini-sglang 理解推理原理,再读真实源码并完成第一个 PR。
让 vLLM 在 Apple Silicon 的 Mac 上跑起来,通过 Metal 和 MLX 后端把大模型推理搬到本地苹果芯片,省去 GPU 服务器。
基于 Meta Llama 3 开发的中文大模型项目,提供中文 LLaMA-3 和 Alpaca-3 模型及训练、部署方案,解决中文场景下开源大模型可用性问题。

本地运行的代码语义搜索与调用图工具,让 AI 编程助手在不上传代码的前提下理解仓库结构、定位相关代码。
整理说话人分离(Speaker Diarization)领域的论文、开源库、数据集与工具资源,方便快速找到「谁在什么时候说话」相关的实现和评测材料。
用 Rust 写的命令行语义搜索与文档解析工具,能在终端里对本地文档做向量化检索,省去自己搭服务。
Kotlin 编写的 OpenAI API 客户端,支持多平台和协程,方便在 Kotlin 项目中调用 GPT、DALL·E、Whisper 等模型接口。
把 ChatGPT 式对话、AI 绘图、内容审核、自定义知识库和 YouTube 摘要整合进 Discord 的机器人,让社区频道直接变成可对话的 AI 助手。
面向 LLM 角色扮演的易用客户端,可自建角色与剧情,接入 GPT、Claude、Gemini、Llama 等多种模型聊天。
统一管理 VLLM、Sglang、llama.cpp、exllamav3 等本地大模型推理引擎的控制面板,省去逐个配置和切换的麻烦。
把草图或科学图表图片自动转成可编辑的 TikZ/LaTeX 绘图代码,省去手写矢量图代码的麻烦。
云原生高性能 AI 与 API 网关,把各家大模型 API 统一成一套请求和返回格式,顺带做申请审批、调用统计、负载均衡和多模型灾备,一键部署开箱即用。
Ollama 的现代化跨平台客户端,支持 Android、Windows、Linux,让本地大模型对话和管理更顺手。
面向 A 股的桌面行情分析与 AI 智能投研工作台,集股票分析、量化交易分析和盘后复盘于一体,用大模型智能体辅助投研决策。
百聆是一个类 GPT-4o 的实时语音对话助手,串联 ASR、大模型和 TTS,端到端延迟低至 800ms,支持打断,Mac 等低配设备也能跑。

把 ExecuTorch 推理运行时封装进 React Native,让手机端直接跑 LLM、视觉、语音等模型,数据不出设备。
腾讯开源的模型压缩工具包,支持量化、投机解码和扩散模型加速,帮你在部署大模型时降低显存占用、提升推理效率。