推理与服务
共 46 个仓库 · C++
在手机等移动设备上高效运行多模态大模型的 C++ 推理引擎,让视觉语言模型能在端侧低资源环境下完成推理。
面向 LLM、VLM、DiT 和 REC 模型的高性能推理引擎,针对多种 AI 加速卡做优化,适合在异构硬件上部署大模型服务。
把大模型接入 Lean 4 定理证明流程的推理服务,支持在证明环境中调用模型做前提检索、策略建议和自动补全。
用 C++ 和 CUDA 手写一个高性能 LLM 推理引擎的教学项目,是 vLLM 的精简版,涵盖 PagedAttention 和连续批处理等核心机制。
基于下一代 Kaldi 的语音转文字服务端框架,支持流式与非流式识别,可通过 WebSocket 对外提供 ASR 服务。
把 OpenVINO 优化过的模型部署成可扩展推理服务的服务器,支持云端和边缘、Kubernetes 与 DAG 流水线,方便生产环境上线模型。

纯 C++ 实现的大模型推理引擎,无需 Python 环境即可在电脑的 CPU 和 GPU 上实时运行对话模型。
面向 Llama 及其变体的大模型推理加速引擎,用 CUDA 和 C++ 做底层优化,主打高吞吐低延迟的模型服务部署。

基于并行图计算的高性能向量数据库,用于存储和检索 embedding 向量,支撑语义搜索与 LLM 应用。
基于 Whisper 的端侧语音转文字应用,支持 100 多种语言,用 Compose Multiplatform 同时覆盖 Android 和 iOS,全程本地推理不上传云端,适合注重隐私的转写场景。
一套 TensorRT C++ API 实战教程,演示如何用 C++ 加载 ONNX 模型并构建高性能推理引擎,适合想在工程里落地 GPU 推理的开发者。
基于 ggml 的 C++ 语音推理运行时,统一跑 Cohere Transcribe、Parakeet TDT、Voxtral、Canary 等多语言 ASR 与 TTS 模型,还带通用强制对齐。
把 OpenAI Whisper 模型通过 TensorFlow Lite 搬到 Android 手机上,实现完全离线的语音识别,不用联网也能把说的话转成文字。
用 C++/CUDA 从零实现的 LLM 推理引擎,除 I/O 外不依赖任何第三方库,适合学习推理底层或做轻量部署。
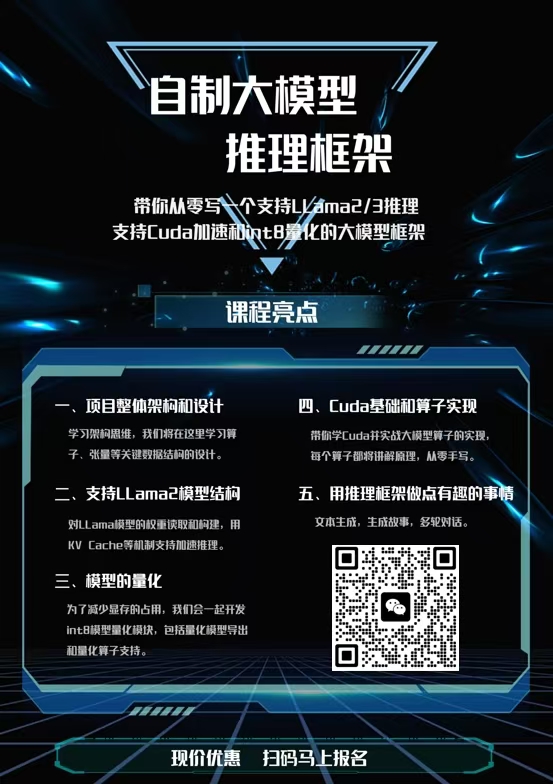
从零手写支持 Llama2/3 和 Qwen2.5 的大模型推理框架,用 C++ 和 CUDA 实现,适合校招、秋招、春招和实习作为练手项目。
Krasis 是一个混合式 LLM 推理运行时,通过 CPU+GPU 协同把大模型跑在显存有限的消费级显卡上,支持 MoE 和 GGUF 模型。
基于深度学习与 NVIDIA GPU 加速的 3D 物体位姿估计 ROS/ROS2 包,可在 Jetson 上通过 TensorRT 推理,为机器人抓取和操作提供实时六自由度位姿。
A high-performance inference system for large language models, designed for production environments.
用 C++ 复刻 vLLM 的推理引擎,支持连续批处理、分页 KV 缓存,并额外提供 GGUF 加载、RadixAttention 和缓存感知调度,适合想在 C++ 环境跑大模型推理的场景。
暂无描述
RaBitQ 官方向量量化与近似最近邻检索库,提供 C++ 和 Python 接口,用 SIMD 加速高维向量的相似度搜索。
面向 ROS2 机器人的 GPU 加速目标检测包,基于 TensorRT 和 Triton 推理深度学习模型,可在 Jetson 上实时运行。