推理与服务
共 34 个仓库 · Jupyter Notebook

单张 4GB 显存显卡就能跑 70B 甚至 2.8T 参数大模型的分层推理方案,通过逐层加载权重把显存需求压到极低,适合本地低配设备部署大模型。

面向中文用户的 Linux 环境大模型实战教程,手把手教你在本地微调(全参数/LoRA)和部署国内外开源 LLM 与多模态模型。
用 Jupyter Notebook 逐个演示 RAG 系统的进阶技巧,从嵌入、检索到重排都有可运行教程,适合动手搭建和优化检索增强生成流程。
离线语音识别 API,支持 Android、iOS、树莓派和服务器,提供 Python、Java、C#、Node 多语言绑定,适合注重隐私、不依赖云端的语音转文字场景。
Amazon SageMaker 官方示例集,用 Jupyter Notebook 演示如何构建、训练和部署机器学习模型,适合上手 MLOps 全流程。
Official inference library for Mistral models
预训练语音合成模型集合,支持俄语、亚美尼亚语等多种语言,几行代码就能把文本转成语音,省去自己训练模型的麻烦。
基于 OpenAI Whisper 的语音转写工具,能自动识别不同说话人并切分对话,适合会议记录、访谈整理等多人语音场景。
提供基于 GPU 加速和微服务架构的生成式 AI 参考工作流,涵盖 RAG、LLM 推理等场景,帮你在 Triton、TensorRT 等基础设施上快速搭建可落地的服务。
一套基于 LangChain 的 RAG 应用构建教程与代码集合,覆盖从基础检索增强到 Agentic RAG 的完整实现路径,帮你快速搭出带检索能力的问答机器人。
面向中文 NLP 的大模型实战代码库,覆盖数据准备、模型训练与推理全流程,含 BERT、ChatGLM、LLaMA 等示例,适合直接上手跑通中文大模型任务。

Pinecone 官方示例仓库,用 Jupyter Notebook 演示向量数据库的建库、检索和 RAG 语义搜索流程,适合快速上手实践。

Milvus 官方实战教程库,用 Jupyter Notebook 演示以图搜图、音频检索、分子搜索、视频分析和 RAG 问答等非结构化数据处理方案。
Google Gemini API 和 Gemma 模型的官方文档与示例代码集合,涵盖聊天机器人、嵌入等用法,但仓库已弃用并将归档。
提供 Amazon Bedrock 上各类基础模型的入门示例代码,涵盖嵌入、知识库和 RAG 等场景,方便开发者快速上手生成式 AI 应用开发。

汇总 Transformer 自然语言处理模型的论文、视频、博客、官方代码和 Colab 笔记本,方便快速查找和上手各类预训练模型。
从基础原理出发系统讲解嵌入(embeddings)的深度教程,用 Jupyter Notebook 带你理解向量表示是怎么算出来、怎么用的。
LanceDB 官方的示例与教程合集,用向量检索搭配大模型,演示多模态 RAG、Agent 和微调等场景的落地写法。
面向吞吐量优化的高性能 LLM 服务框架,通过 CUDA 加速提升大模型推理的并发处理能力。
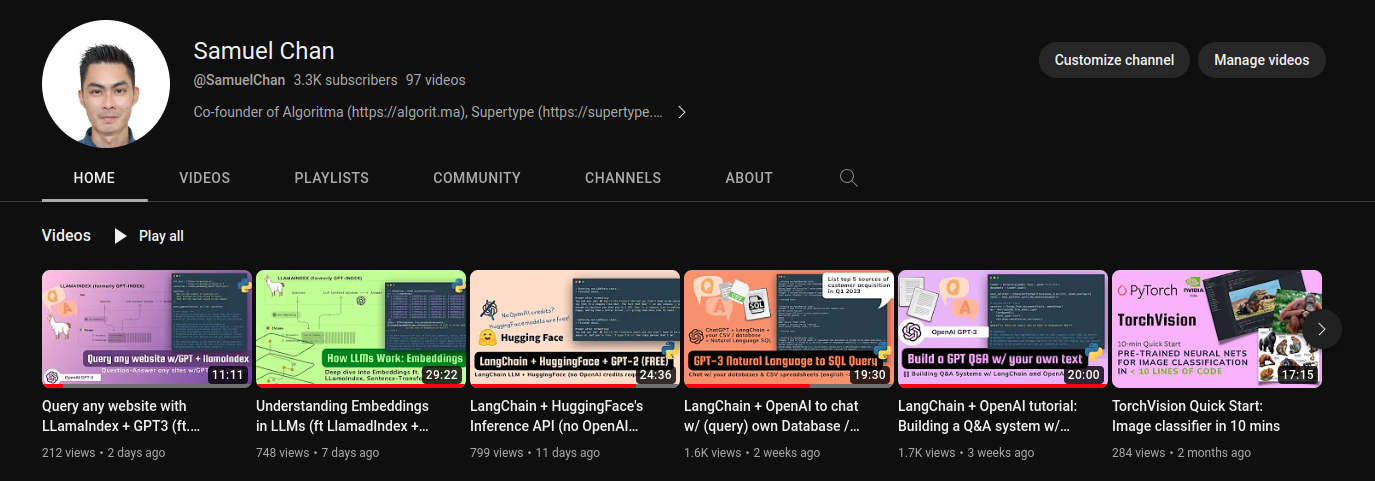
一套基于 Jupyter Notebook 的大模型实战教程和示例脚本,覆盖 LangChain、OpenAI、LlamaIndex、ChromaDB、Pinecone 等主流工具,帮你快速上手 LLM 应用开发。
微软出品的 5 周 RAG 学习路线,用 Jupyter Notebook 带你从索引、混合检索到量化压缩,系统掌握检索增强生成。
Azure AI Search 向量检索功能的官方代码示例集,涵盖嵌入生成、索引构建与查询,帮开发者快速接入向量搜索。
一套面向音频处理的深度学习实战代码集,覆盖语音识别、说话人验证、关键词唤醒、语音合成与音色转换等任务,可直接参考实现来训练和微调模型。
微软 Foundry 的示例、文档与加速器合集,用 Jupyter Notebook 演示 Azure OpenAI、ChatGPT、DALL·E、嵌入模型等服务的调用方式。