推理与服务
共 751 个仓库
用纯 Java 实现的现代 LLM 推理引擎,支持 LLaMA、GPT 等 Transformer 模型,借助 SIMD 加速在 JVM 上直接跑大模型推理。
用 WebGL 在浏览器里跑力导向图布局和渲染,把大规模网络图的计算交给 GPU,适合做高节点数的交互式图可视化。
用 Python 实现 node2vec 图嵌入算法,把网络中的节点映射成低维向量,方便下游做节点分类、链接预测等图学习任务。
一个模型同时搞定离线与流式的语音识别、语音翻译和语音合成,无需为不同任务分别部署系统。
提取抖音无水印视频链接,视频文案,douyin-mcp-server,mcp,claude skill,支持龙虾
在 AMD Strix Halo 上本地跑 Qwen3.8-Flash-Next 和 NPU 小模型,用同一端口同时提供 OpenAI 与 Anthropic 兼容 API,让本地推理像调前沿云服务一样顺手。
Linux 上的原生语音转文字工具,提供系统级听写,速度快、准确率高且数据本地处理,适合注重隐私的用户。
把 BERT 等预训练上下文向量和传统主题模型结合,用来在多种语言上抽取更连贯的主题,适合文本挖掘和主题分析。
面向 Apple Silicon 的本地语音工具箱,用 MLX 和 CoreML 在 iOS/macOS 上跑语音识别、语音合成、语音转换、VAD 和说话人分离,全程端侧推理。
免训练稀疏注意力方案,可直接接入任意模型推理,加速 LLM、视觉 Transformer 和视频生成,无需重新训练即可降低注意力计算开销。
基于 Vosk 和 Kaldi 的语音识别服务端,通过 WebSocket、gRPC、WebRTC 接口对外提供离线 ASR 能力,方便把语音转文字集成进自己的应用。

Graphite 的基于文件的时间序列数据库格式,用固定大小文件存储监控指标,解决指标数据高效读写和长期保留的问题。
高通官方维护的预优化模型库,模型已针对延迟和内存调优,可直接部署到骁龙等高通设备上推理。

开源多模态训练框架,基于 Qwen3 等底座训练视觉语言模型,降低多模态模型训练门槛。
基于 PyTorch 微调 Whisper 语音识别模型,支持有无时间戳、无语音数据训练,并用 CTranslate2 加速推理,可部署到 Web、Windows 和安卓。
一个语音聊天应用,把语音识别、大模型对话和语音合成串成完整链路,跑在 Modal 无服务器平台上,适合快速搭建可对话的语音助手原型。
轻量级 Python RAG 工具包,用 DuckDB 或 PostgreSQL 就能搭起检索增强生成,省去部署向量数据库的麻烦。
EAGLE-4 的官方推理代码,用投机解码加速大模型生成,可接入 SGLang、vLLM 等主流推理框架,显著提升 token 吞吐。
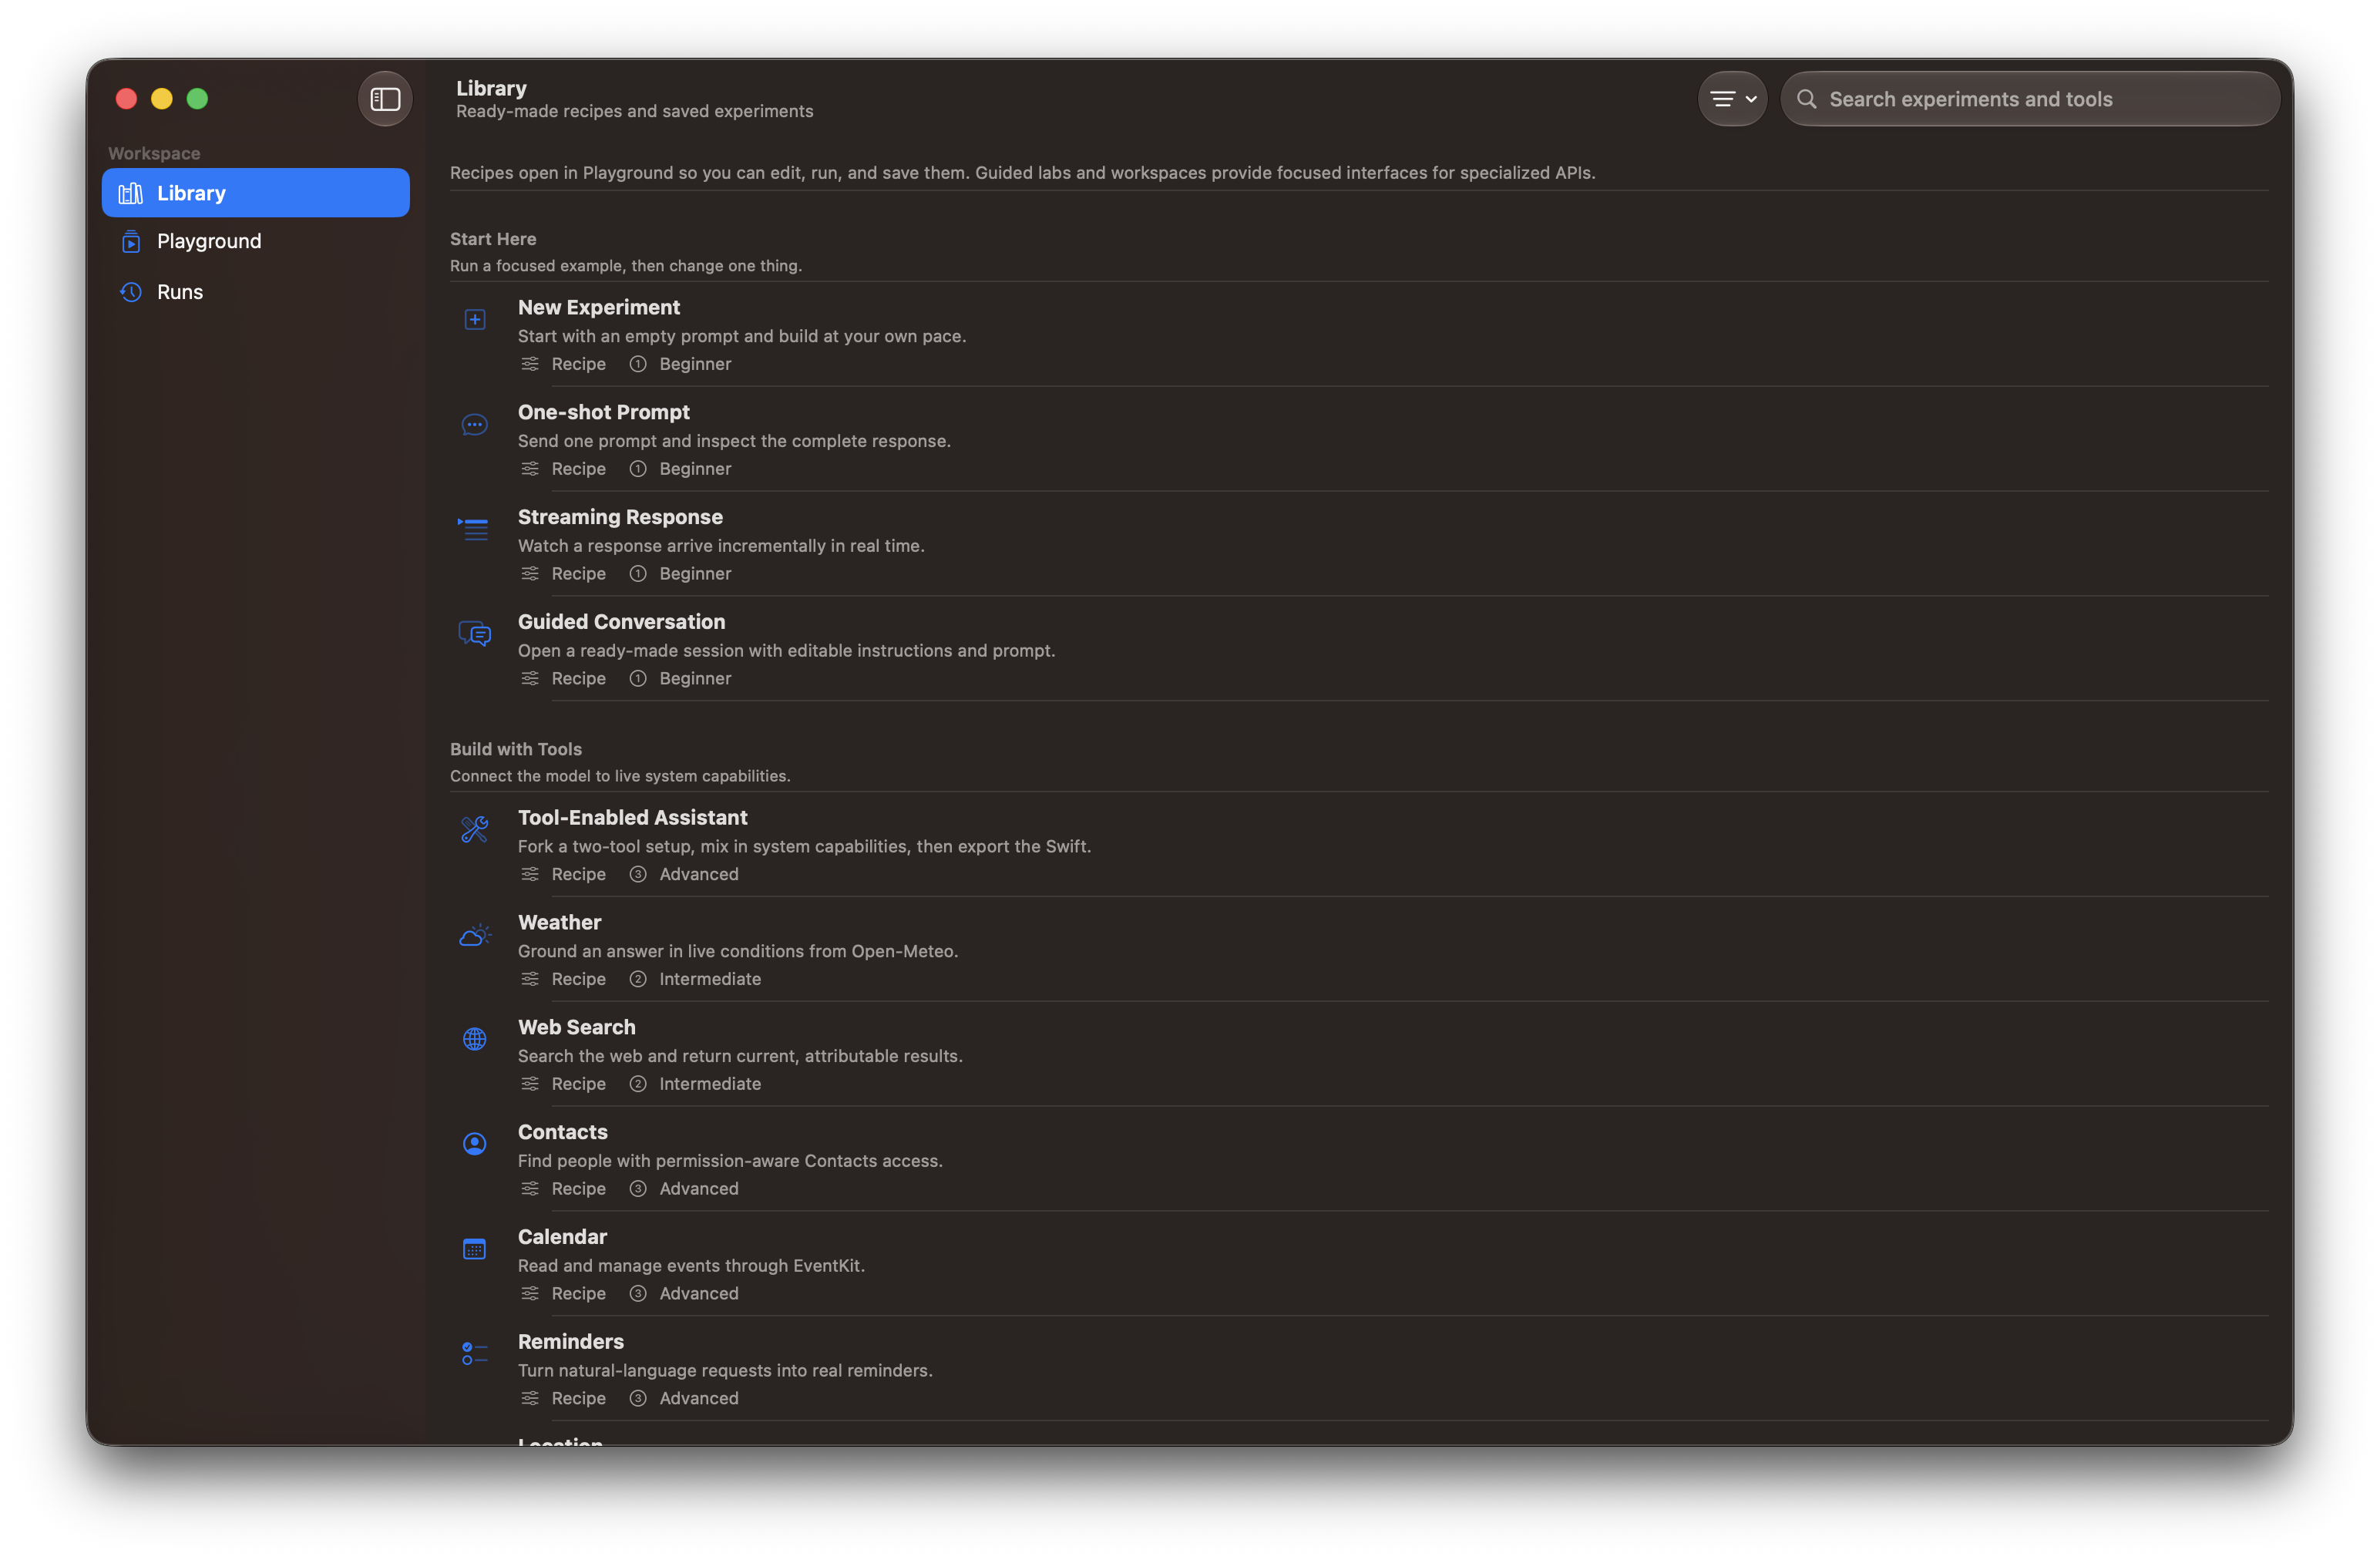
面向 Apple Foundation Models 框架的实战实验场,帮你在 iOS 和 macOS 上动手搭建、测试并评估端侧大模型应用。
用 C++ 和 CUDA 手写一个高性能 LLM 推理引擎的教学项目,是 vLLM 的精简版,涵盖 PagedAttention 和连续批处理等核心机制。
离线运行的俄语语音助手,通过插件机制扩展技能,适合在无网络环境下做语音交互和自定义语音指令开发。

汇总 Transformer 自然语言处理模型的论文、视频、博客、官方代码和 Colab 笔记本,方便快速查找和上手各类预训练模型。
截屏后调用大模型识别并解答屏幕内容,代码报错、题目图表、外文资料框选即得答案,常驻后台可当面试或刷题助手。
用 USB-C 把 iPhone 接到 Mac 上,让手机参与跑 27B 大模型,加快提示词读取并扩展上下文,适合本地推理场景。