多模态生成
共 261 个仓库 · 近 4 个月有推送
汇总自动驾驶场景生成与分析方向的基础模型论文,涵盖扩散模型、大语言模型和多模态模型,持续更新最新研究进展。
基于基础模型的医学图像分析代码库,涵盖MAE预训练、Mamba状态空间模型、视觉语言模型与医学报告生成,为医学影像研究提供可复用的模型实现。

面向电商场景的 GPT Image 2.5 提示词手册,覆盖商品主图、模特试穿、产品展示、互动场景和社交电商素材的生成与修图。
一套面向 AI 编程助手的生成式媒体技能包,让 Claude、Cursor 等助手能直接产出高质量图片、视频、音频和语音内容。
面向视觉语言模型的对齐与安全研究代码库,提供对抗攻击方法,用于评估多模态基础模型的鲁棒性和可信度。
用强化学习对扩散模型做后训练,支持文生图、文生视频和图生视频,主打高效、稳定、可扩展。
把 fal.ai 上 1400 多个图像、视频、音频和 LLM 模型接进 ComfyUI 的自定义节点,自带缓存和费用控制,方便在本地工作流里直接调用云端生成能力。
多供应商 AI 图像生成器,支持 Gitee AI、HuggingFace、ModelScope 等后端,提供 OpenAI 兼容 API 与 token 轮换,可一键部署到 Cloudflare Pages。
Iris-3B 是一个 3B 参数的扩散 Transformer,直接在像素空间生成图像、无需 VAE;同一预训练先验微调后还能做单目深度估计和 4 倍图像修复。
面向新手的 ComfyUI 前端界面,简化 Stable Diffusion 和 Flux 等图像生成工作流操作,降低上手门槛。
收集视觉语言模型在流式视频场景下的论文与开源代码,帮研究者快速定位在线视频理解方向的资料。
为 ComfyUI 提供 MiniMax H3 文生图、参考图编辑和 Qwen 细节精修的节点与实测工作流,开箱即用。
面向视觉语言模型的 INT4 量化部署方案,通过量化感知蒸馏把大模型压缩到 4bit,在保持多模态能力的同时大幅降低显存占用。
在官方 DocVQA 基准上让智能体自动迭代 Qwen3-VL 的训练代码,省去手工调参和实验设计,支持 NVIDIA 多卡与 Apple Silicon。
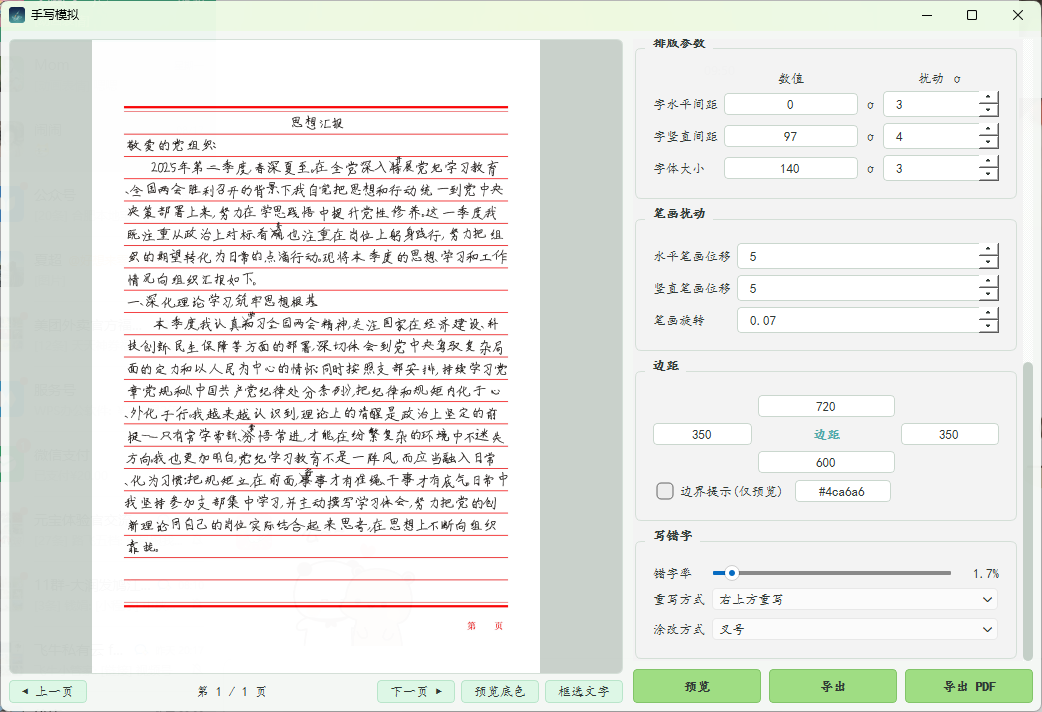
把普通文本渲染成逼真的手写体图片,支持手写字体、信纸背景和字距行距笔画随机扰动,提供 GUI 和 CLI 两种用法。
汇总各家 AI 视频生成模型的横向对比清单,覆盖模型能力、可用 API、价格和生成速度,方便选型时快速查表。
收集整理 MiniMax H3 视频生成提示词,覆盖电影感、广告、动漫、UGC、产品视频等场景,附带可播放示例和创作者署名,方便直接参考套用。
把 Qwen-Image-2.1 的文生图和多图编辑提示词按阿里官方规范自动改写优化,让 AI Agent 出图更准。
从长视频游戏录像里自动剪出适合竖屏短视频的精彩片段,靠 AI 场景分析挑高光、GPU 加速渲染,还能加 AI 配音。
整理扩散模型风格迁移最新方法的资源清单,涵盖文本到图像、文本到视频等方向,方便快速查找和对比相关论文与实现。
CVPR'24 论文官方实现,用上下文残差学习加少量样本提示,让一个通用模型跨类别做异常检测,免去每类单独训练。