多模态生成

共 261 个仓库 · 近 4 个月有推送
打开分类页
sokuji
kizuna-ai-lab·TypeScript

面向双语会议的实时双向语音翻译工具,自动识别说话语言并双向互译,支持云端或完全离线本地运行,覆盖桌面端和浏览器插件。

实时翻译+4语音推理
1487+9209v0.50.12026-11-11 04:33 UTC
LanPaint
scraed·Python

面向各类 Stable Diffusion 模型的高质量免训练图像修复方案,可作为 ComfyUI 自定义节点直接接入工作流,无需额外训练即可完成局部重绘。

图像修复+4图像生成
1481572.2.02026-09-28 12:35 UTC
awesome-japanese-llm
llm-jp·TypeScript

汇总日语大语言模型资源的清单,涵盖基础模型与生成式模型,方便快速查找和对比日语 LLM 生态。

日语大模型+3视觉语言模型
1446492026-11-09 05:37 UTC
AeroSandbox
peterdsharpe·Jupyter Notebook

用计算图变换(如自动微分)加速飞行器设计优化,提供气动、推进、结构、轨迹设计等可组合分析工具,适合多学科设计优化场景。
飞行器设计+4视觉语言模型
1390+32142026-10-30 20:20 UTC
pruna
PrunaAI·Python

面向开发者的模型优化框架,能对扩散模型、LLM、语音识别等模型做压缩加速,以极低改造成本换来更快、更省资源的推理。
模型优化+4图像生成
1384+20125v0.3.52026-11-09 21:55 UTC
Matcha-TTS
shivammehta25·Jupyter Notebook

基于条件流匹配的快速非自回归语音合成架构,用更少采样步数生成高质量语音,适合搭建低延迟 TTS 系统。

语音合成+4图像生成
1370218v0.0.72026-11-02 23:51 UTC
finetrainers
huggingface·Python

面向扩散模型的可扩展、显存优化训练框架,基于 PyTorch 和 Diffusers,让大模型微调在有限显存下也能跑起来。

扩散模型+4图像生成
1364145v0.2.02026-09-23 12:32 UTC
airunner
Capsize-Games·Python

本地离线跑图像生成、实时语音对话和 LLM 聊天机器人的桌面推理引擎,数据不出本机,适合注重隐私的创作与自动化工作流。

离线推理+4图像生成
1317104v6.1.112026-11-10 01:46 UTC
TTS-Audio-Suite
diodiogod·Python

把 RVC、F5-TTS、Chatterbox、IndexTTS-2 等十多种本地语音合成与变声引擎集成进 ComfyUI,支持多语言、超长文本、SRT 时间轴和角色音色,一站式完成配音与音频编辑。

语音合成+4语音
1261155v5.6.02026-11-05 20:00 UTC
UForm
unum-cloud·Cuda

轻量级多模态模型库,能同时理解多语言文本和图像,速度比 OpenAI CLIP 和 LLaVA 快 5 倍,适合做图文检索和内容生成。

多模态+4视觉语言模型
125276v3.1.42026-11-10 19:35 UTC
vibe-knowledge-film
HeyChengC·JavaScript

拆解抖音爆款知识短片,自动生成导演分镜表、配音效并一键出片,适合批量做知识类短视频。

知识短片+4视频生成
1234+1111152026-10-13 06:12 UTC
LLaVA-OneVision-2
EvolvingLMMs-Lab·Python

开源多模态训练框架,基于 Qwen3 等底座训练视觉语言模型,降低多模态模型训练门槛。

多模态训练+3视觉语言模型
1233+1782.02026-11-09 09:20 UTC
ekho
hgneng·Lex

支持普通话、粤语、藏语的中文语音合成引擎,可离线把文本转成语音,适合做多语言 TTS 应用。

语音合成+4语音
1214267v9.02026-10-30 00:34 UTC
MeanFlow
haidog-yaqub·Python

MeanFlow 与 iMF 的 PyTorch 实现,用一步生成建模替代多步扩散采样,让图像生成推理更快。
一步生成+4图像生成
1213682026-10-28 23:08 UTC
wunjo.wladradchenko.ru
wladradchenko·C++

本地免费运行的一站式 AI 视频与图像编辑工具,集换脸、口型同步、抠图去物、风格重绘、人声分离与克隆、视频生成于一体。
换脸+4图像生成
1188119build-v3.2.02026-10-21 11:22 UTC
biniou
Woolverine94·Python

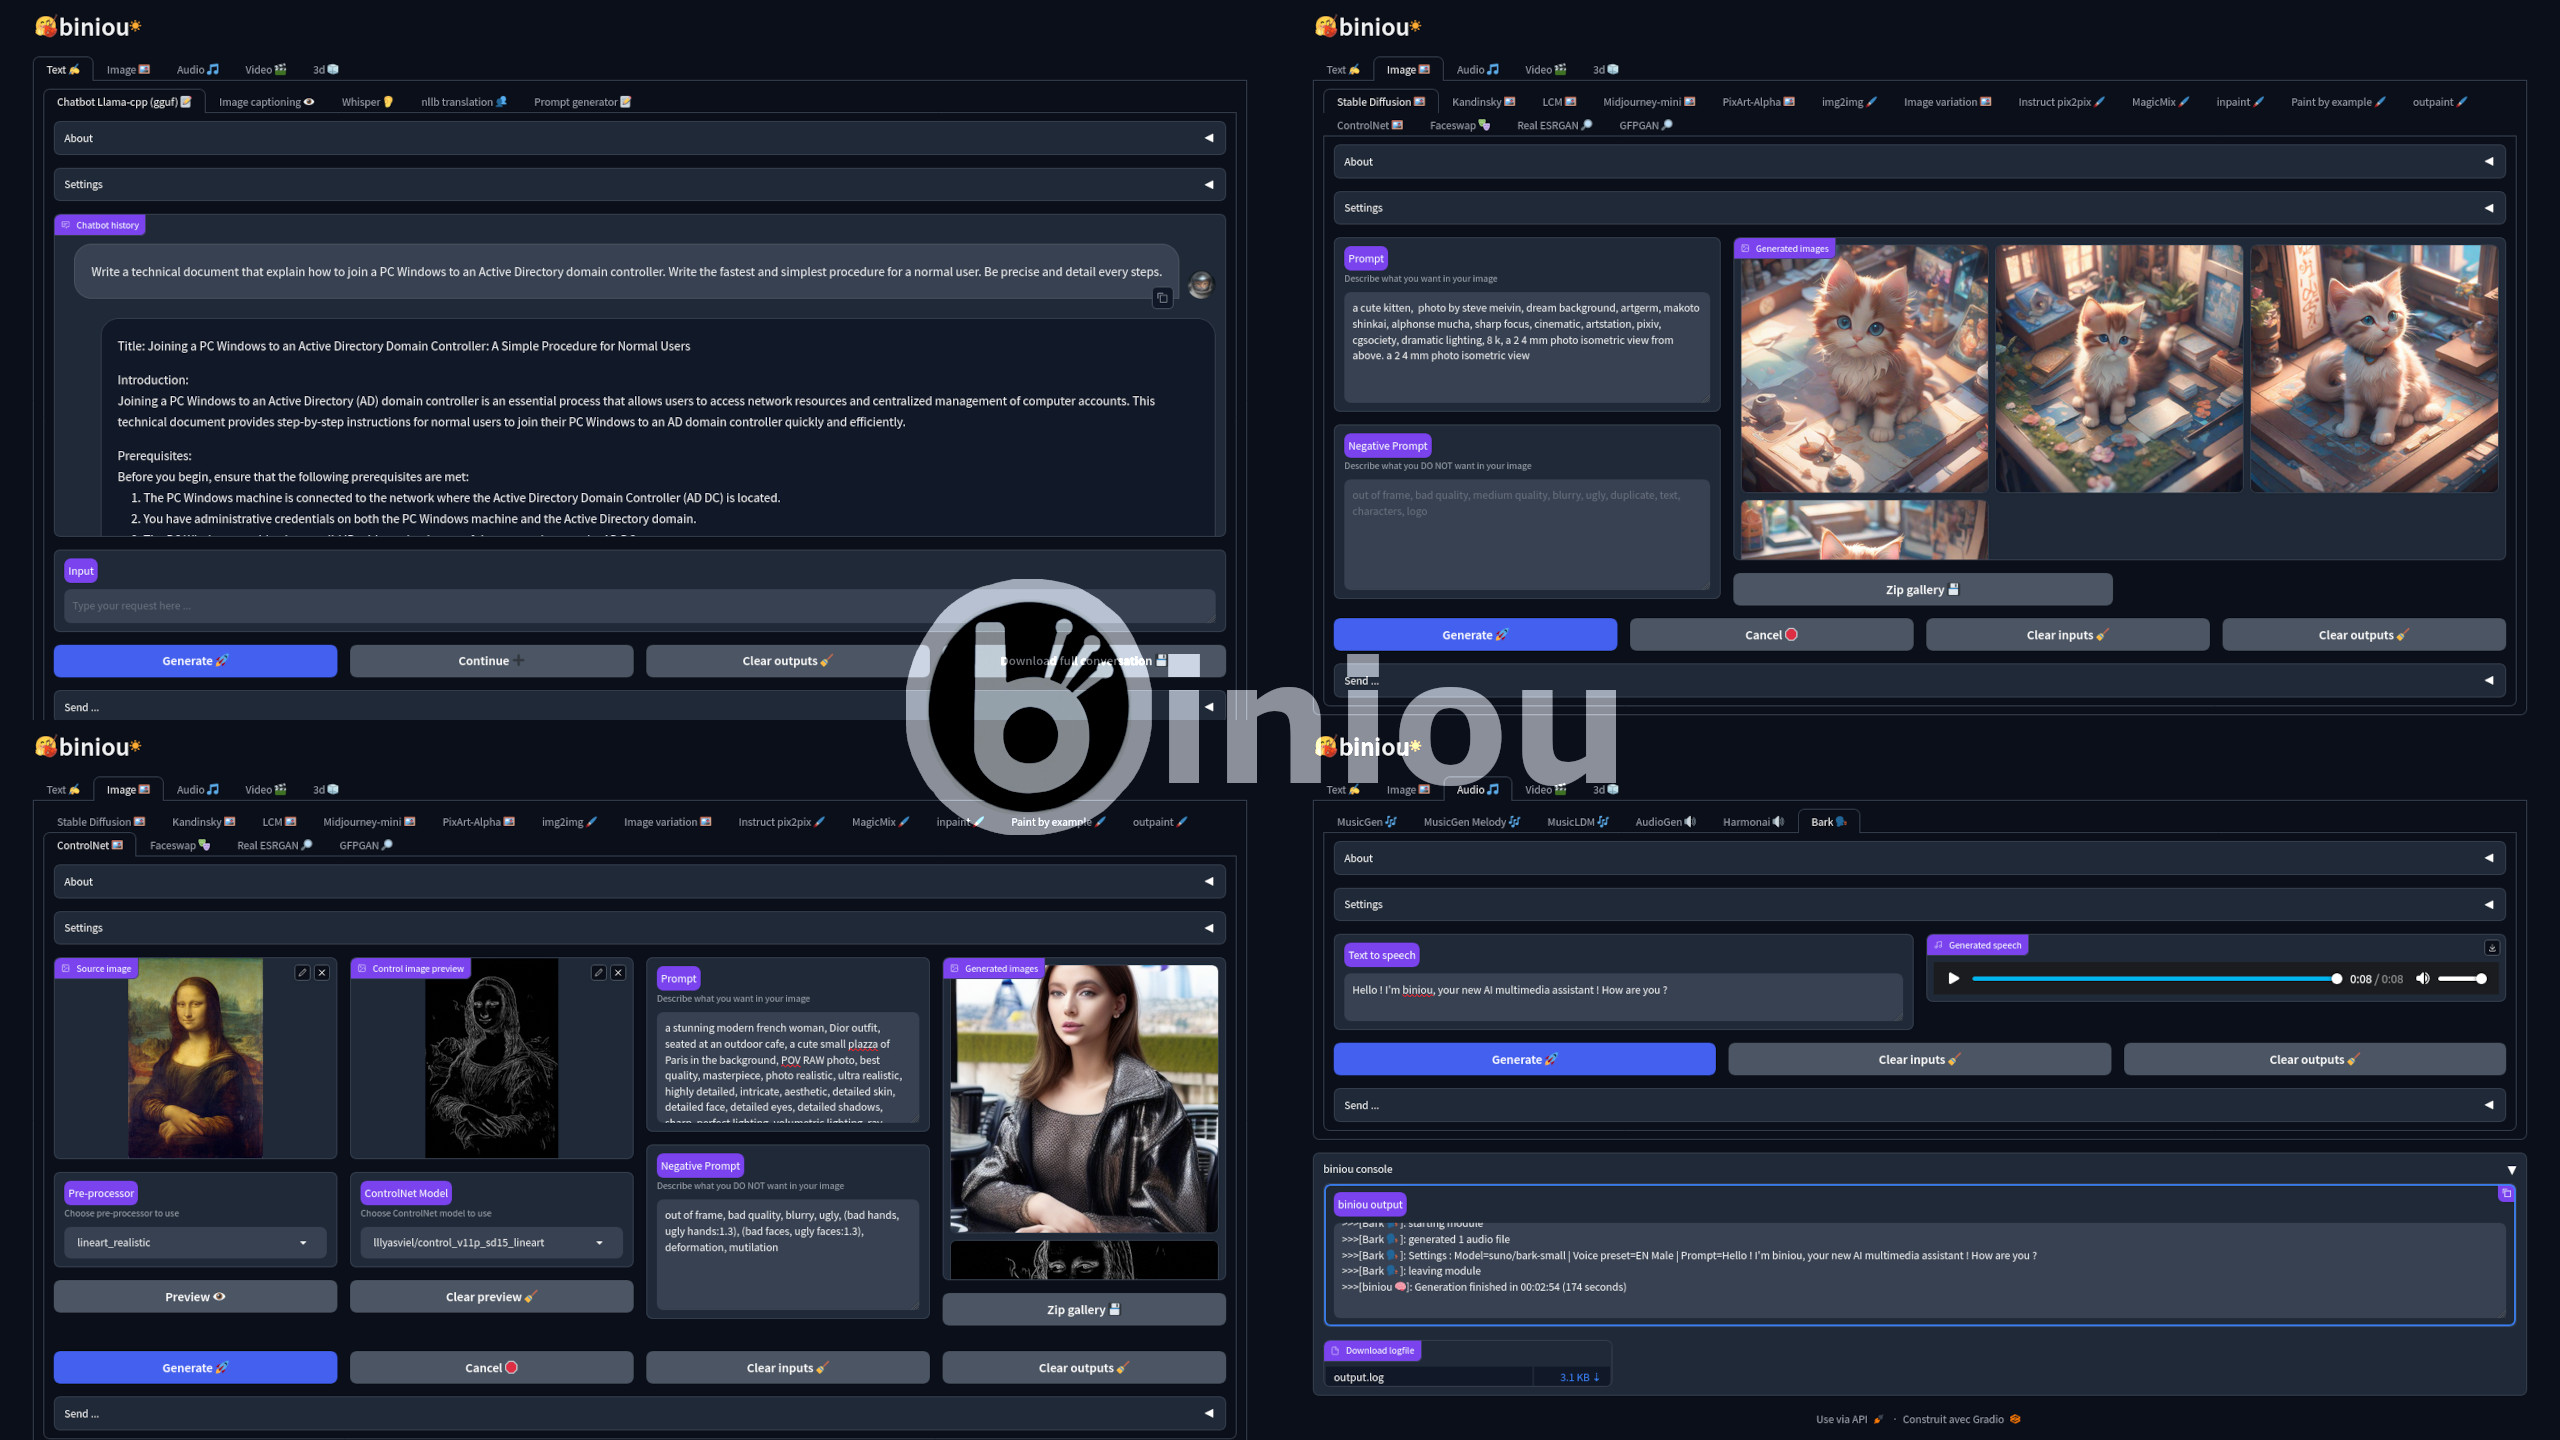
自托管的生成式 AI 网页界面,集成 30 多种模型,覆盖图像、视频、音频生成,用浏览器就能统一调用,省去逐个搭建环境的麻烦。
生成式AI+4图像生成
1153136v0.0.12026-11-10 18:24 UTC
MOVA
OpenMOSS·Python

单模型同时生成画面与声音的基座模型,解决视频和音频分开生成后不同步的问题,适合做带声视频创作。

视频音频生成+4图像生成
1141+1972026-11-10 08:01 UTC
FastGen
NVlabs·Python

NVIDIA 开源的扩散模型加速生成方案,用一致性模型、分布匹配蒸馏和流映射等蒸馏技术,把扩散模型的多步采样压缩到极少步数,显著提升出图速度。

扩散模型+4图像生成
1115+693v0.2.02026-11-10 17:36 UTC
Awesome-Controllable-T2I-Diffusion-Models
PRIV-Creation·Python

汇总文本到图像扩散模型可控生成方向的论文、代码与工具资源,覆盖空间控制、多概念组合和个性化生成,方便快速查找与调研。

可控生成+4图像生成
1111342026-11-09 01:30 UTC
awesome-agent-apis
Anil-matcha·Python

收录 660+ 个生成式媒体模型和第三方 API 工具的目录,每个条目一个 YAML 文件,按能力分类浏览,方便给 AI Agent 快速找接口。

API 目录+4图像生成
10672862026-10-14 17:43 UTC
DiffusionOPSD
worldbench·Python

把在线策略自蒸馏引入扩散模型后训练,用强化学习思路提升文生图和图像编辑的生成质量,省去额外奖励模型。

扩散模型+4图像生成
1057+992026-10-12 09:28 UTC
dsh-voice-ai-girlfriend
beiyege-01·TypeScript

给 DeepSeek Harness 加语音女友的插件:Whisper 听你说话,Qwen3-TTS 克隆音色并逐句流式朗读,配数字人动画窗,支持插话打断。

语音助手+4语音
1035+432952026-11-02 10:49 UTC
Causal-Forcing
thu-ml·Python

把自回归扩散模型蒸馏成少步采样,实现高质量实时交互式视频生成,解决扩散模型推理慢、难以实时出片的问题。

视频生成+4图像生成
1026622026-10-24 03:51 UTC
FlowEdit
fallenshock·Python

基于预训练流模型实现免反演文本编辑,无需先反演再重建,直接按文字指令修改图像,简化流程并提升编辑效果。

文本编辑图像+4图像生成
1024542026-08-16 14:52 UTC