多模态生成
共 290 个仓库 · Python
MAGI-1 是一个大规模自回归视频生成模型,把视频拆成片段逐段预测生成,适合需要长时序连贯性的视频创作场景。
把随手写的提示词改写成更清晰、结构化的版本,让文生图和图像编辑模型生成效果更稳定。
逆向 Google Gemini 网页版得到的 Python 异步接口,能直接调用对话、图像生成等能力,省去官方 API 的申请和限制。
MiniMax 官方开源的文本大模型 MiniMax-Text-01 和视觉语言模型 MiniMax-VL-01,基于线性注意力架构,可用于长上下文理解与多模态推理。
收录可直接复制的 AI 图像与视频提示词,每条都附真实生成效果和来源,还提供用 agent 编辑视频的配方。
面向越南语的本地语音合成工具,支持即时声音克隆,在 CPU 上实时推理并输出 48kHz 音频,适合做越南语 TTS 应用。
Skywork-R1V 是昆仑万维开源的多模态视觉语言推理模型系列,基于强化学习训练,擅长图像理解与复杂推理任务。
轻量级图像与视频生成推理框架,支持 Wan、Hunyuan、LTX 等主流视频模型及自回归扩散模型,降低多模态生成模型的部署与推理门槛。
面向图像、视频、音频扩散模型的通用微调工具箱,支持 Stable Diffusion、Flux 等模型,帮你在自有数据上快速训练出定制生成模型。
在普通电脑上跑 MiniMax H3 视频生成,最低 8GB 显存加 16GB 内存就能用,还会根据硬件自动选择加速方案。
用 100 行 Python 代码复现各类深度学习论文,涵盖扩散模型、GAN、元学习、逆渲染等,适合通过精简代码快速理解论文核心思想。
面向 Blackwell 架构 GPU 的高速 LLM 推理引擎,支持 DeepSeek、Kimi、GLM 等模型,主打极致推理吞吐与低延迟。
用 Python/C 实现的强制对齐工具,能把音频和对应文本自动对齐到词或音素级别,适合做语音数据集标注和字幕时间轴生成。
基于 Kokoro 模型和 ONNX Runtime 的轻量级语音合成方案,用 Python 就能在本地跑出高质量 TTS,省去复杂环境配置。
MOSS-Image 是一个 50 亿参数的 DiT 基础模型,主打高质量文字渲染、布局生成和高效微调,适合需要精准控制文字与版式的文生图场景。
基于 FLUX 扩散 Transformer 的身份保持图像生成工具,上传几张人脸照片就能在换场景、换风格时保持长相一致,适合做个性化写真和照片重绘。
用置信度感知的姿态引导,从单张参考图生成高质量人体动作视频,解决动作视频生成中姿态不准、画面抖动的问题。
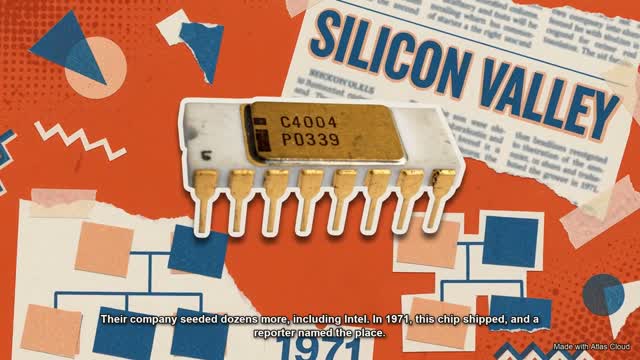
输入一个主题就能自动生成 Vox 风格的拼贴解说视频,从脚本、素材到 ffmpeg 合成全流程跑通,适合做科普短视频。
一个多模态语言 Agent 开发框架,把视觉模型和 LLM 编排在一起,帮你快速搭出能看能听的原型并推向生产。
Python 库和命令行工具,调用 Google 翻译的文本转语音接口,把文字快速合成语音并保存为音频文件。
在 Apple Silicon 上用 MLX 原生跑 FLUX、Qwen-Image 等前沿图像与视频生成模型,省去 PyTorch 依赖,让 Mac 本地出图更顺畅。
GLM-4.6V/4.5V/4.1V-Thinking 系列视觉语言模型,通过可扩展强化学习提升多模态推理能力,支持图像理解、视频理解和图文问答。
端到端重放 ChatGPT Plus/Team/Pro 订阅协议的逆向工具集,自带从零实现的 hCaptcha 视觉求解器,用于反欺诈机制实证研究。

把视频按场景切分、去重抽帧并配上字幕文本,让 Claude 等大模型真正「看懂」视频内容,支持 URL 或本地文件,全程本地运行。