多模态生成

共 290 个仓库 · Python

打开分类页
Helios
PKU-YuanGroup·Python

能实时生成长视频的扩散模型,支持图生视频和交互式长上下文生成,解决长视频生成速度慢、画质难兼顾的问题。
长视频生成+4图像生成
2258+21982026-11-01 09:00 UTC
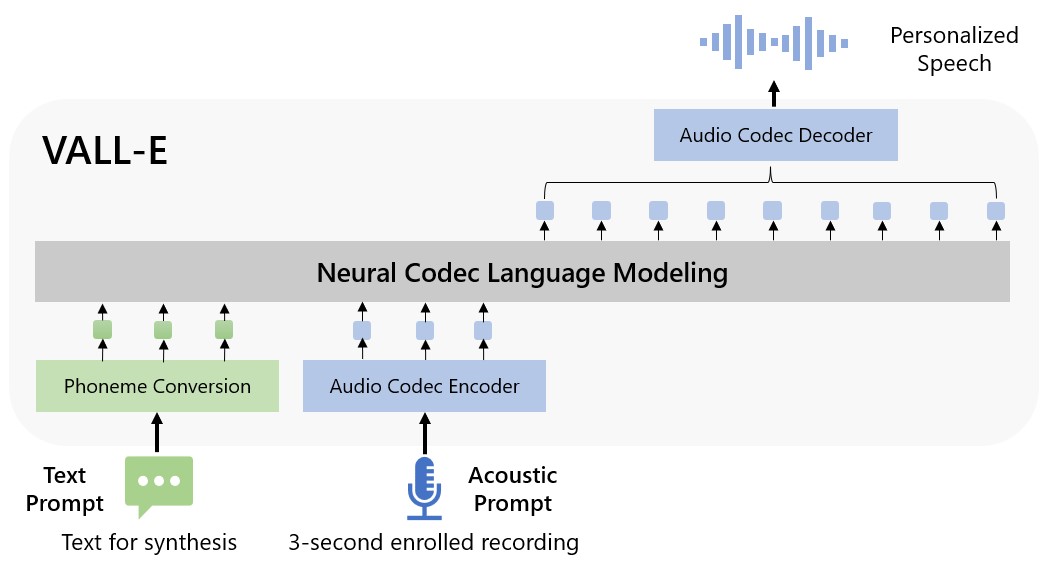
vall-e
lifeiteng·Python

用 PyTorch 复现 VALL-E 零样本语音合成,只需几秒参考音频就能克隆音色朗读任意文本。

零样本语音合成+3语音
2220326v1.02025-09-10 16:08 UTC
IMS-Toucan
DigitalPhonetics·Python

基于 PyTorch 的多语言语音合成工具包,支持 7000 多种语言的可控快速 TTS,可训练和微调自己的语音模型。

语音合成+4语音
2212319v3.1.22026-01-25 14:45 UTC
openai-edge-tts
travisvn·Python

用微软 Edge 的在线语音合成能力,自建一个免费、高质量的 TTS 接口,直接替换 OpenAI、Azure 或 ElevenLabs 的付费语音服务。

语音合成+4语音
2153332v2.0.02025-07-01 23:56 UTC
parlor
fikrikarim·Python

在本地设备上跑实时多模态 AI 的 Python 项目,整合语音识别、语音合成和本地大模型,实现类似 GPT-Live 的实时对话体验,支持 Apple Silicon 和 MLX。

端侧AI+4视觉语言模型
2112281v2.0.02026-08-03 18:06 UTC
ICEdit
River-Zhang·Python

用单张 LoRA 做图像编辑,仅需 0.1% 训练数据就能在身份保持上超过 GPT-4o,4GB 显存即可运行。

图像编辑+4图像生成
20951102025-12-19 19:08 UTC
epub_to_audiobook
p0n1·Python

把 EPUB 电子书自动转成有声书音频,内置 WebUI,输出格式适配 Audiobookshelf,支持 OpenAI/ChatGPT 语音合成。

有声书生成+4语音
2084+1222v0.8.82026-10-28 14:23 UTC
YandexStation
AlexxIT·Python

把 Yandex Station 等带 Alice 语音助手的智能家居设备接入 Home Assistant,实现语音控制和 TTS 播报。
智能家居+4智能家居
2008+4186v3.22.32026-10-22 12:36 UTC
Show-o
showlab·Python

用一个 Transformer 统一多模态理解与生成,既能看图回答,也能按文字生成图像,省去多模型拼接的麻烦。

多模态理解+4图像生成
1986942026-01-08 16:30 UTC
Qwen-VL-Series-Finetune
2U1·Python

开源微调 Qwen-VL 系列多模态大模型的实现,支持 Qwen2-VL、Qwen2.5-VL、Qwen3-VL 等版本,方便按自己的数据定制视觉语言模型。

多模态微调+4视觉语言模型
19802232026-09-09 16:55 UTC
custom-diffusion
adobe-research·Python

只用几张图片就能让文生图扩散模型学会多个新概念,并把它们组合到同一张图里,适合做个性化图像生成和少样本微调。

文生图+4图像生成
19791392026-05-24 19:31 UTC
FlashVSR
OpenImagingLab·Python

面向流式视频超分的一步扩散框架,用局部约束稀疏注意力和微型条件解码器把扩散超分做到实时,适合直播、视频通话等低延迟场景。

视频超分辨率+4图像生成
1972+61652026-10-16 09:00 UTC
CatVTON
Zheng-Chong·Python

轻量级虚拟试衣扩散模型,仅需不到8G显存即可生成1024×768试穿效果,训练和推理都很省资源。

虚拟试衣+4图像生成
1907244ComfyUI2025-12-16 00:59 UTC
VideoClaw
HITsz-TMG·Python

把一句想法丢进对话,就能自动完成脚本、配图、配音到成片的 AI 视频生成多智能体系统,适合快速产出短片。
视频生成+4图像生成
18932782026-08-26 05:31 UTC
HunyuanVideo-I2V
Tencent-Hunyuan·Python

腾讯混元开源的图生视频模型,基于 HunyuanVideo 构建,支持自定义控制,把静态图片转成连贯视频。

图生视频+4图像生成
18542012026-04-07 06:13 UTC
Genie-TTS
High-Logic·Python

把 GPT-SoVITS 语音克隆模型转成 ONNX 并做推理的引擎,方便在没有 PyTorch 环境里跑少样本音色克隆和语音合成。

语音合成+4语音
1844+4125v2.0.22026-11-01 09:58 UTC
DeTikZify
potamides·Python

把草图或科学图表图片自动转成可编辑的 TikZ/LaTeX 绘图代码,省去手写矢量图代码的麻烦。

TikZ生成+4视觉语言模型
182893v0.3.02026-09-17 11:48 UTC
ImageReward
zai-org·Python

ImageReward 是 NeurIPS 2023 提出的文本生图人类偏好奖励模型,用人类偏好数据训练打分器,评估生成图像质量并支持 RLHF 微调扩散模型。
人类偏好+4图像生成
1711912025-10-29 13:40 UTC
MMaDA
Gen-Verse·Python

开源的多模态大扩散语言模型,用块扩散、混合思维链和统一强化学习,把多模态理解与生成放进同一个模型里做。

扩散语言模型+4图像生成
1676882026-02-14 05:50 UTC
soprano
ekwek1·Python

Soprano 是一个超写实、低延迟的文本转语音引擎,能把文字快速合成接近真人音色的语音,适合需要即时发声的场景。

语音合成+3语音
16331402026-01-15 16:32 UTC
fantasy-talking
Fantasy-AMAP·Python

基于扩散模型生成逼真说话人像视频,通过连贯运动合成让口型与头部动作自然同步,适合做数字人播报和虚拟主播。

说话人像生成+4图像生成
16291272026-01-26 17:59 UTC
MiniMax-MCP
MiniMax-AI·Python

把 MiniMax 的语音合成、文生图、文生视频等生成能力封装成 MCP 服务,让 Claude 等支持 MCP 的客户端直接调用。

MCP服务+4图像生成
15962862026-08-20 12:06 UTC
Infinity
FoundationVision·Python

Infinity 是一个用位级自回归建模做高分辨率图像生成的模型,把 GPT 式架构扩展到视觉生成,解决高分辨率文生图的质量和扩展性问题。

自回归建模+4图像生成
1593952026-04-16 03:02 UTC
Irodori-TTS
Aratako·Python

基于流匹配的语音合成模型,通过表情符号控制说话风格,支持声音克隆,让 TTS 输出带情绪和语气变化。

语音合成+4图像生成
1584+251872026-11-09 01:38 UTC