多模态生成
共 434 个仓库
本地免费运行的一站式 AI 视频与图像编辑工具,集换脸、口型同步、抠图去物、风格重绘、人声分离与克隆、视频生成于一体。
面向机器人导航的开源平台,用多模态大模型和视觉语言动作模型构建通用导航基础模型,解决跨场景视觉导航与空间智能问题。
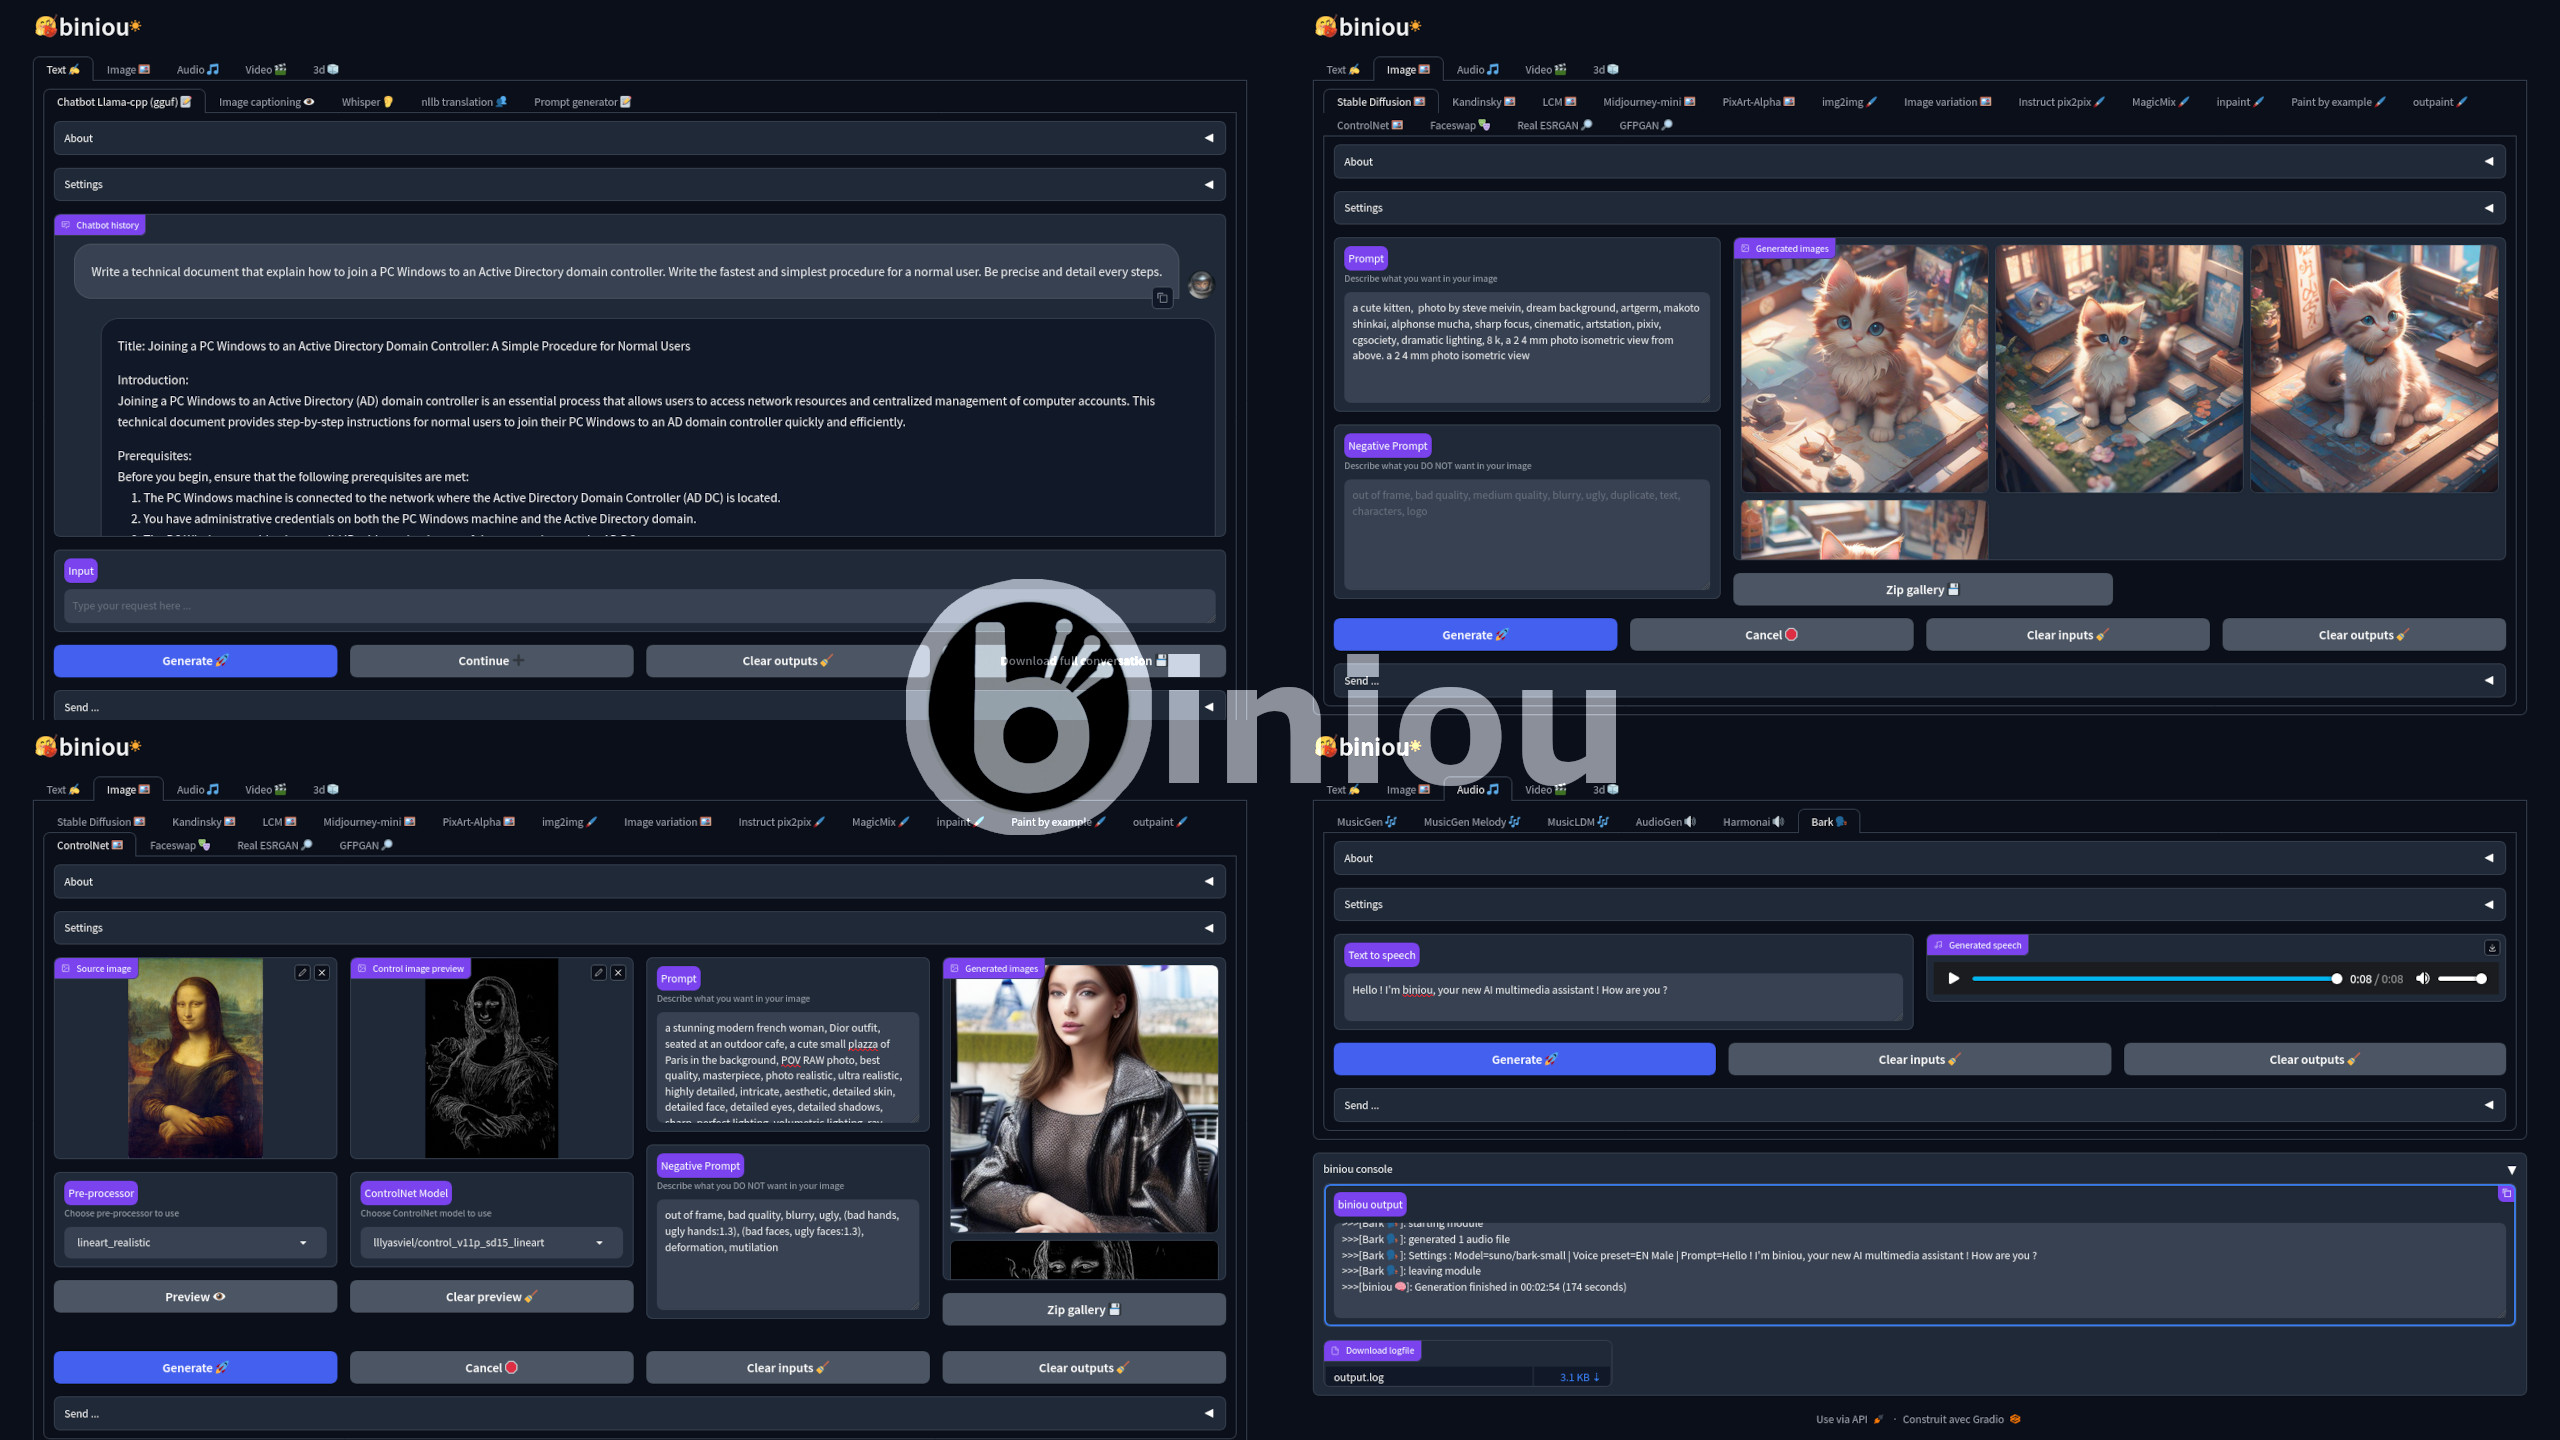
自托管的生成式 AI 网页界面,集成 30 多种模型,覆盖图像、视频、音频生成,用浏览器就能统一调用,省去逐个搭建环境的麻烦。
单模型同时生成画面与声音的基座模型,解决视频和音频分开生成后不同步的问题,适合做带声视频创作。
NVIDIA 开源的扩散模型加速生成方案,用一致性模型、分布匹配蒸馏和流映射等蒸馏技术,把扩散模型的多步采样压缩到极少步数,显著提升出图速度。
汇总文本到图像扩散模型可控生成方向的论文、代码与工具资源,覆盖空间控制、多概念组合和个性化生成,方便快速查找与调研。

腾讯混元开源的多模态扩散模型,根据视频画面和文本描述生成高保真拟音音效,解决视频配音中脚步声、环境声等 Foley 音效制作费时费力的问题。

基于扩散模型的自动驾驶规划器,用扩散生成做轨迹规划,支持灵活引导,是 ICLR 2025 Oral 论文的官方实现。
收录 660+ 个生成式媒体模型和第三方 API 工具的目录,每个条目一个 YAML 文件,按能力分类浏览,方便给 AI Agent 快速找接口。
把在线策略自蒸馏引入扩散模型后训练,用强化学习思路提升文生图和图像编辑的生成质量,省去额外奖励模型。
Reverse-engineered the official API for Jimeng/Dreamina’s text-to-image and image-to-image features. Drew inspiration from several experts’ projects and made some tweaks, which significantly improved stability.
给 DeepSeek Harness 加语音女友的插件:Whisper 听你说话,Qwen3-TTS 克隆音色并逐句流式朗读,配数字人动画窗,支持插话打断。
把自回归扩散模型蒸馏成少步采样,实现高质量实时交互式视频生成,解决扩散模型推理慢、难以实时出片的问题。
基于预训练流模型实现免反演文本编辑,无需先反演再重建,直接按文字指令修改图像,简化流程并提升编辑效果。
无需训练的长篇故事可视化迭代框架,通过多轮迭代生成保持角色与情节一致的故事配图,解决长文本生成图像时前后不一致的问题。
汇总扩散模型在图像处理中的应用,涵盖图像修复、增强、编码与质量评估等方向,方便快速查找相关论文和资源。
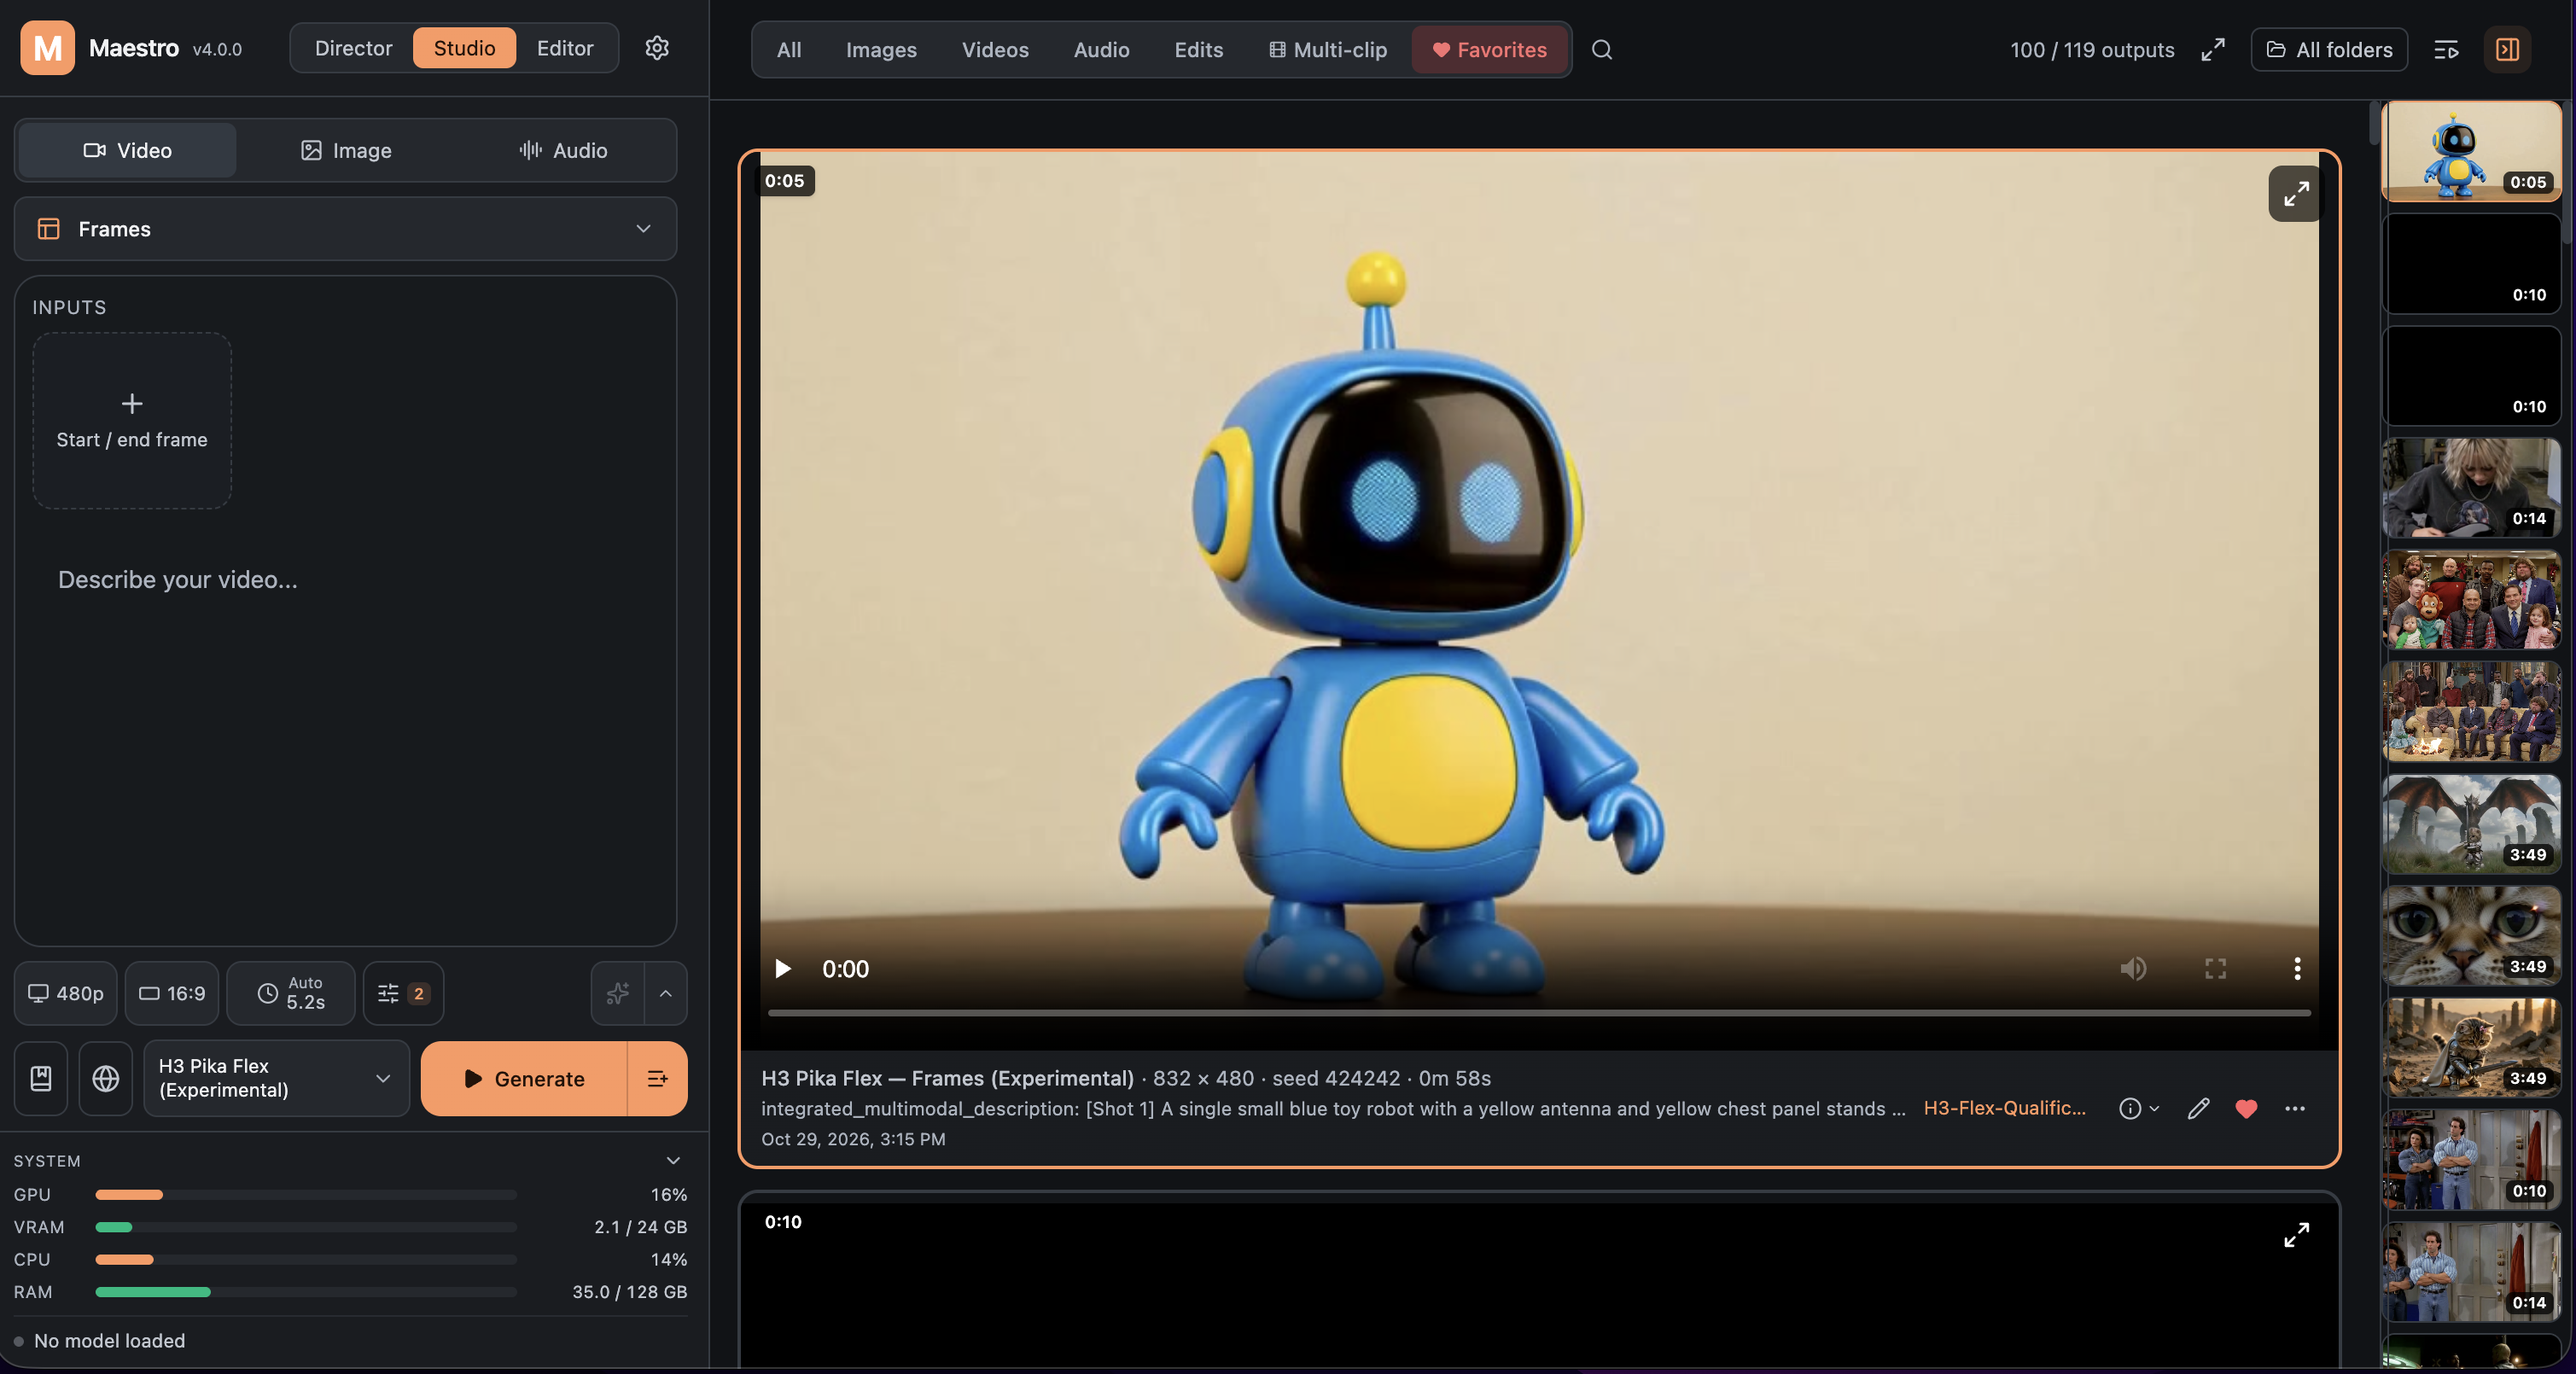
一站式本地 AI 影音工作室,输入一句提示词就能规划完整音乐视频和短片,涵盖视频、图像与音乐生成,基于 WanGP 流水线并通过 Pinokio 安装。
在浏览器里直接修复 AI 生成的像素画和矢量图,不用装软件或上传服务器,适合处理文生图常见的锯齿、模糊和边缘失真问题。
从零训练原生视觉语言模型的开源系列,去掉独立视觉编码器,让多模态理解与生成在统一架构里完成。
汇总扩散模型在机器人领域的关键论文与博客,覆盖抓取、运动规划、模仿学习和离线强化学习,方便快速入门和追踪进展。
让 HuggingFace 上的 Transformers 和 Diffusers 模型无缝跑在昇腾 MindSpore 上,省去手动迁移适配的麻烦,并支持加速。
微软出品的 5 周 RAG 学习路线,用 Jupyter Notebook 带你从索引、混合检索到量化压缩,系统掌握检索增强生成。
面向长时程视频世界模型的开源数据集与可扩展训练方案,支持扩散模型和图像到视频生成,可用于实时交互式游戏引擎等场景。
基于 Diffusers 的实时扩散模型演示应用,用潜在一致性模型把文生图做到近乎即时的出图,并通过 MJPEG 推流展示生成过程。