多模态生成
共 434 个仓库
开箱即用的高质量语音转换工具,基于 PyTorch 和 RVC 实现变声与声音克隆,兼顾易用性和推理性能。

用低秩分支吸收离群值的 4-bit 扩散模型量化方案,让 FLUX 等大模型在低显存下也能高速出图,并已集成 ComfyUI。
把视频扩散模型的推理速度提升 100–200 倍,靠一致性蒸馏、稀疏线性注意力和 SageAttention 等系统级优化,让视频生成真正跑得动。

Eagle 是一系列前沿视觉语言模型,主打以数据为中心的训练策略,能看图理解并回答多模态问题,适合做图文问答和视觉理解研究。
MAGI-1 是一个大规模自回归视频生成模型,把视频拆成片段逐段预测生成,适合需要长时序连贯性的视频创作场景。
逆向 Google Gemini 网页版得到的 Python 异步接口,能直接调用对话、图像生成等能力,省去官方 API 的申请和限制。
把随手写的提示词改写成更清晰、结构化的版本,让文生图和图像编辑模型生成效果更稳定。
MiniMax 官方开源的文本大模型 MiniMax-Text-01 和视觉语言模型 MiniMax-VL-01,基于线性注意力架构,可用于长上下文理解与多模态推理。
收录可直接复制的 AI 图像与视频提示词,每条都附真实生成效果和来源,还提供用 agent 编辑视频的配方。
整理扩散模型相关论文、综述与分类体系的资源库,覆盖文生图、文生视频、文生 3D 等方向,方便快速定位和梳理生成式扩散模型的研究脉络。
一套可扩展的列柱式压缩框架,也是目前最快的开源列柱式文件格式,面向多模态和 Arrow 数据的高效存储与读取。
一个基于 Gradio + React 的 WebUI,把 GPT-SoVITS、CosyVoice、XTTSv2、Bark、MusicGen、RVC 等二十多种语音合成、音频生成与音乐生成模型整合到同一界面,省去逐个部署的麻烦。
输入任意主题,自动生成带 TTS 旁白、字幕和章节进度条的黑底动态图形讲解视频,支持中英文,每帧都用 Remotion 代码绘制。
用 Rust 写的轻量布局引擎,直接解析 JSX、HTML 和 CSS,把页面渲染成图片、SVG、PDF 或绘制树,不需要无头浏览器,适合生成 OG 图、发票和动态图像。
面向越南语的本地语音合成工具,支持即时声音克隆,在 CPU 上实时推理并输出 48kHz 音频,适合做越南语 TTS 应用。
Skywork-R1V 是昆仑万维开源的多模态视觉语言推理模型系列,基于强化学习训练,擅长图像理解与复杂推理任务。
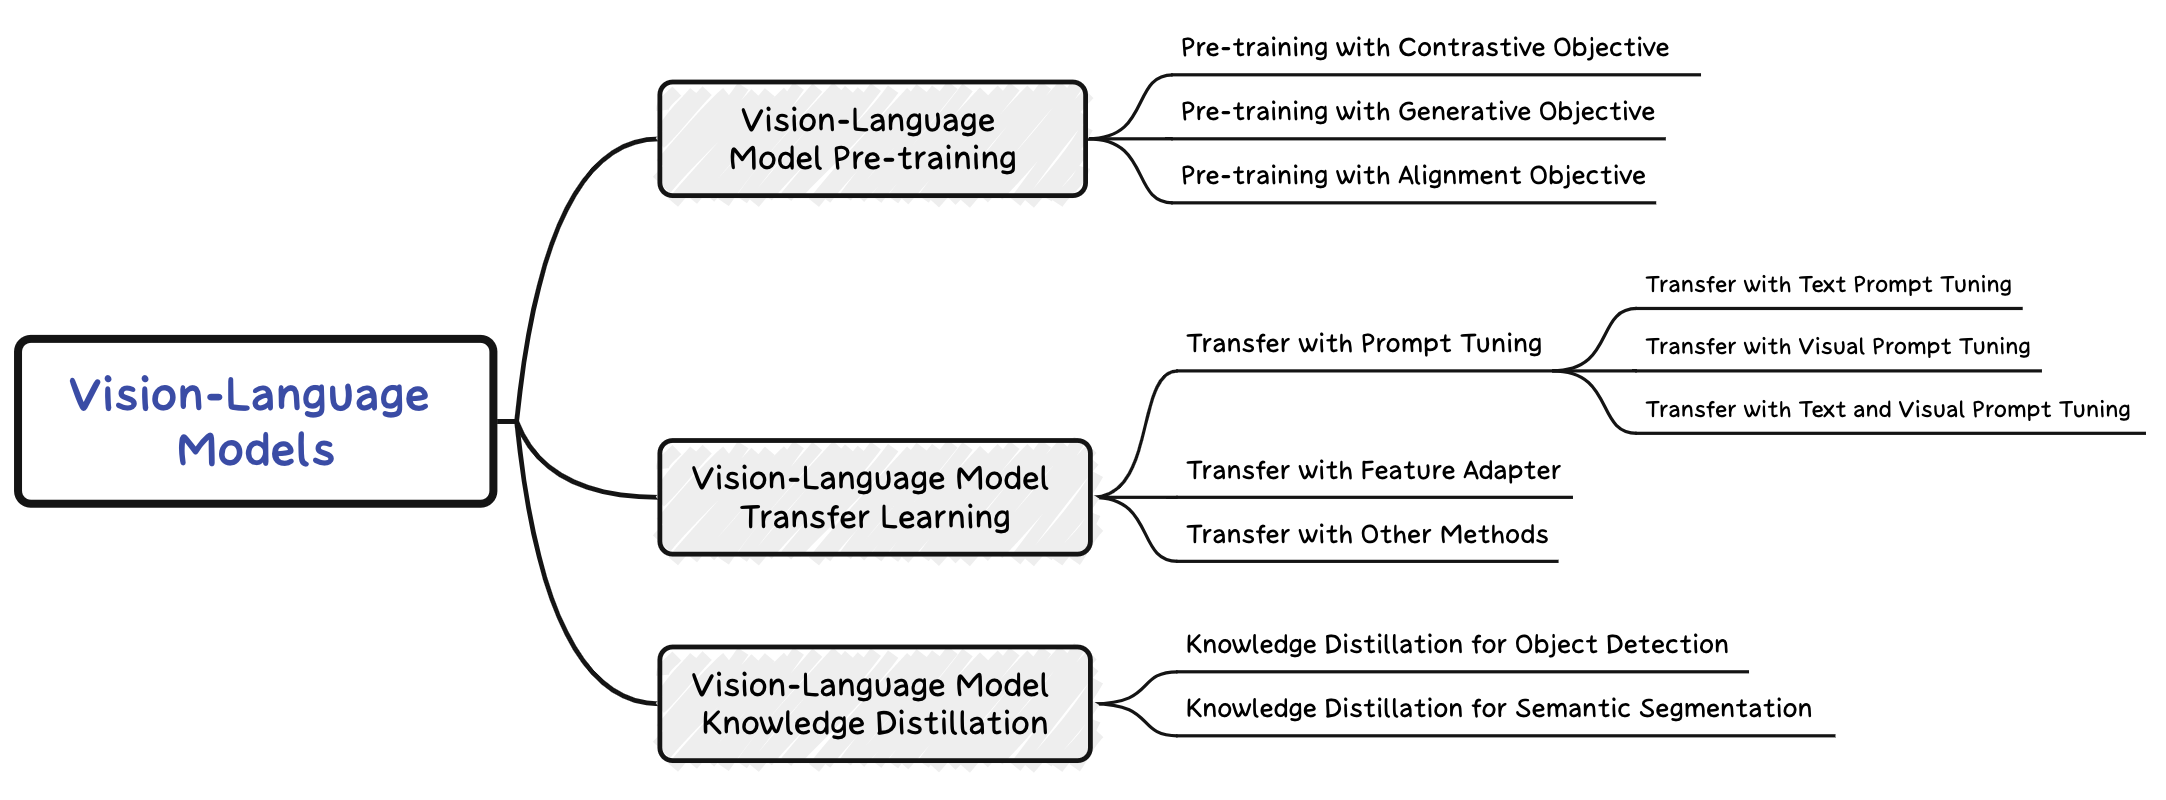
汇总视觉语言模型在视觉任务上的论文与资源清单,方便研究者快速跟进多模态预训练、迁移学习和知识蒸馏等方向的最新进展。
轻量级图像与视频生成推理框架,支持 Wan、Hunyuan、LTX 等主流视频模型及自回归扩散模型,降低多模态生成模型的部署与推理门槛。
提供 CTPAPI 兼容接口,让 CTP 程序无缝对接 XTP、TORA、EMT、TWS 等各券商柜台,并附带 7x24 可用的期货、期权、股票模拟交易环境,可替代 Simnow。
面向图像、视频、音频扩散模型的通用微调工具箱,支持 Stable Diffusion、Flux 等模型,帮你在自有数据上快速训练出定制生成模型。
在普通电脑上跑 MiniMax H3 视频生成,最低 8GB 显存加 16GB 内存就能用,还会根据硬件自动选择加速方案。
面向 Blackwell 架构 GPU 的高速 LLM 推理引擎,支持 DeepSeek、Kimi、GLM 等模型,主打极致推理吞吐与低延迟。
用 100 行 Python 代码复现各类深度学习论文,涵盖扩散模型、GAN、元学习、逆渲染等,适合通过精简代码快速理解论文核心思想。
用 Python/C 实现的强制对齐工具,能把音频和对应文本自动对齐到词或音素级别,适合做语音数据集标注和字幕时间轴生成。