检索与 RAG
共 321 个仓库 · 近 4 个月有推送

Redis 在 AI 生态中的社区资源合集,收录集成方案、示例项目和最佳实践,方便用 Redis 做向量检索和特征存储。

Qdrant 向量数据库的 JavaScript/TypeScript 官方 SDK,让 Node.js 和前端项目能方便地接入向量检索,用于构建 RAG 和相似度搜索应用。
Pinecone 向量数据库的官方 Python SDK,方便在 Python 项目里直接接入向量存储和相似度检索,搭建 RAG 应用时不用自己封装 API。
自托管的 DeepSeek-OCR-2 网页界面与 API,支持在 NVIDIA、Apple Silicon 和 CPU 上通过 vLLM 或 transformers 运行,提供逐页质量检查、PDF 流式处理和 MCP 接入。
基于 Rust 和 ONNXRuntime 的计算机视觉与视觉语言模型库,集成 YOLO、FastVLM、OCR、SAM 等模型,方便在 Rust 项目中直接做目标检测、分割和图文理解。
面向开发者的本地优先 RAG 服务器,对代码和技术文档做语义加关键词混合检索,支持 MCP 与 CLI,数据不出本机、零配置即可用。
《AI-Powered Search》一书配套代码库,演示混合检索、学习排序、点击模型和生成式搜索等现代搜索技术,基于 OpenSearch 实现。
用 Markdown 文件搭建个人 Wiki,支持知识图谱、LaTeX 公式和 Pandoc 转换,可 Docker 部署,适合替代 Obsidian 做自托管文档库。
无需人工标注标准答案就能评估 RAG 系统,通过自动生成问题和判断相关性来量化检索与生成质量。
整理 Azure OpenAI 与大模型(含 RAG、Agent)的学习资源和实践笔记,按月更新,适合想系统上手云上 LLM 应用开发的人查阅。
面向 OCR 流程的文档版面分析工具,能自动切分页面区域、检测文本行并做二值化,为后续文字识别和 RAG 检索提供干净的结构化输入。

一款 Android 端 AI 聊天客户端,基于 Rikkahub 重做界面并增强功能,支持自带 API Key 接入大模型,适合角色扮演和日常对话。
用生成模型合成带标注的肝脏肿瘤 CT 图像,无需人工标注即可训练分割模型,缓解医学影像标注成本高的问题。
整理高维向量检索与向量数据库相关的优质资源清单,涵盖近似最近邻搜索、相似度检索和向量搜索引擎,方便快速选型与调研。
用 Rust 写的高性能本地 AI 记忆检索引擎,带桌面 GUI,能对 agent 历史做关键词加可选语义的混合召回,解决本地对话记录难找的问题。
基于 DuckDB 的 TypeScript 数据分析库,能快速处理表格、地理空间、图网络和向量相似度检索,还支持 AI 与 Google Sheets 集成。
在 AWS 上快速搭建、试验和部署生成式 AI 应用的低代码方案,内置 Amazon Bedrock 模型接入和第三方 LLM 连接器,无需深厚 AI 经验即可上手。
ColPali 的实战教程合集,手把手教你在多模态 RAG 场景里训练、微调和改造 ColPali 视觉检索模型。
用消费级硬件在本地搭建并运行大语言模型和聊天机器人,支持 llama-cpp-python、vLLM 和 RAG 检索增强。
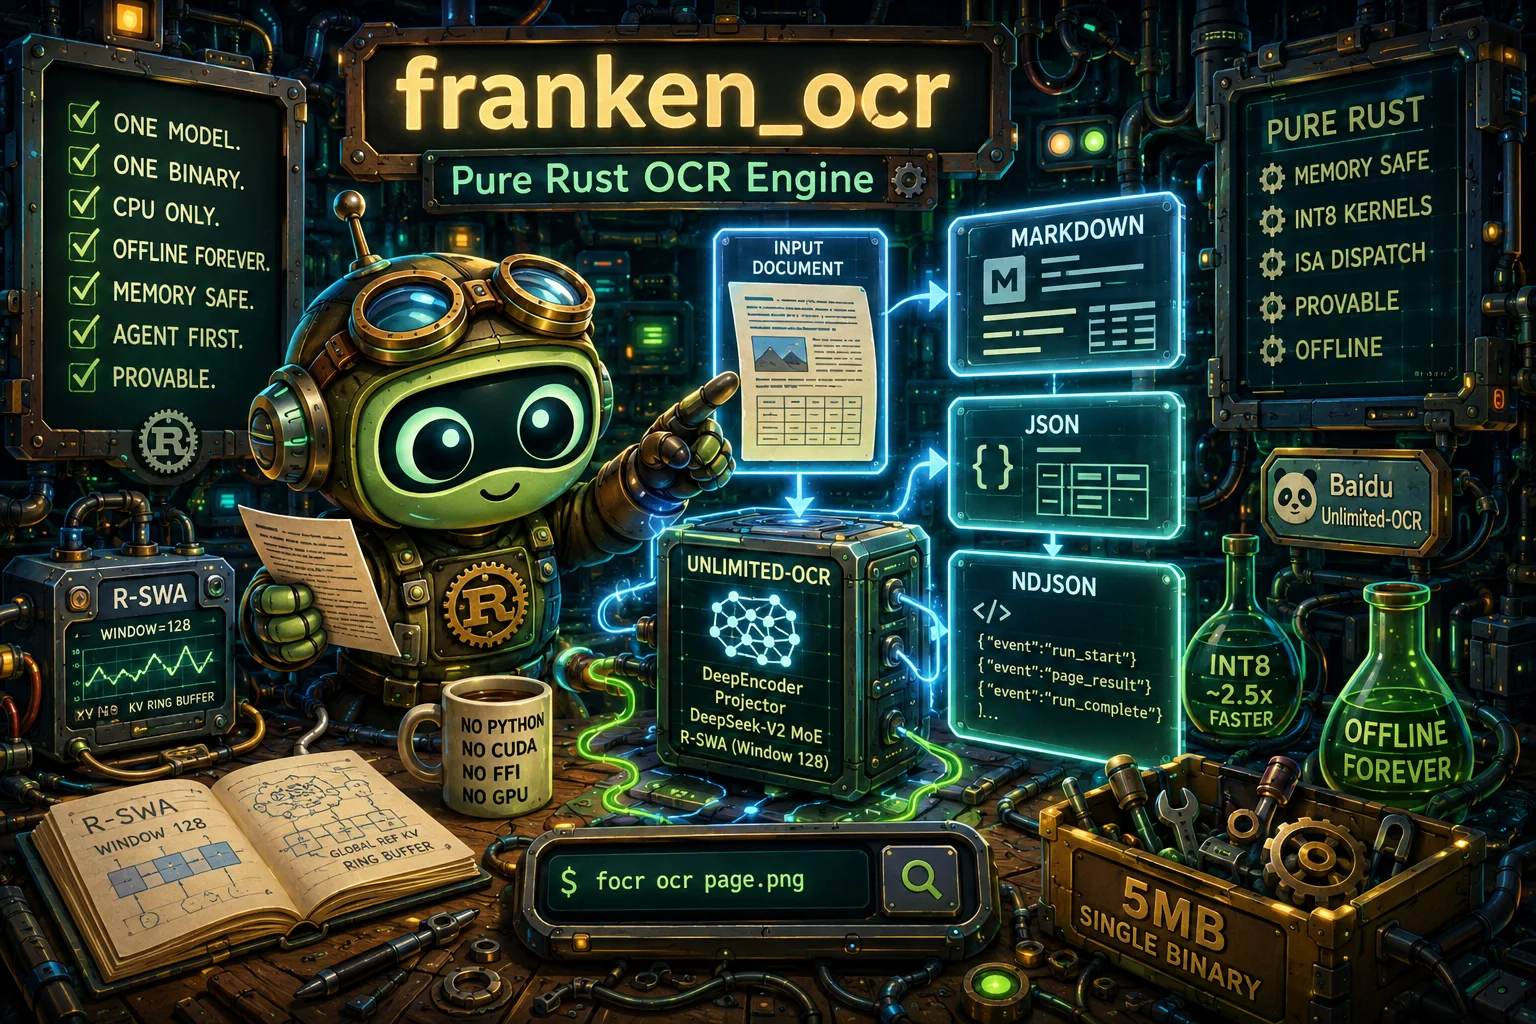
纯 Rust 实现的 CPU 端 OCR 引擎,跑百度 Unlimited-OCR 这个 3B MoE 视觉语言模型,自带 int8 定制算子,不依赖 ML 框架、Python 或 GPU。
把网页转成适合大模型阅读的纯文本,类似 Firecrawl 和 Jina Reader,方便做 RAG、网页抓取和图片链接提取。
在自己 GPU 上自托管的一体化 AI 工作室,集文件 RAG 对话、屏幕与浏览器代理、编码集群、LoRA 训练、MCP 服务及本地音视频图像生成于一身,无遥测。
VLM Run API 的示例与指南合集,用 Jupyter Notebook 演示如何调用视觉语言模型完成 OCR、文档解析和 ETL 等任务,方便快速上手多模态推理。

本地部署的多模态 RAG 工具,能对各类技术文档做检索和问答交互,文档不出本机。