检索与 RAG
共 419 个仓库
为 Schema.org 词汇表生成 JSON-LD 的 TypeScript 类型定义,让结构化数据在 TS 项目里获得类型检查和自动补全,避免手写字段出错。
纯网页的所见即所得笔记应用,笔记以 Markdown 格式保存在本地,支持知识图谱与离线 PWA 使用。
基于知识图谱为 LLM 微调合成高质量问答数据,把结构化知识转成训练语料,缓解监督微调数据稀缺。
轻量级 Python RAG 工具包,用 DuckDB 或 PostgreSQL 就能搭起检索增强生成,省去部署向量数据库的麻烦。
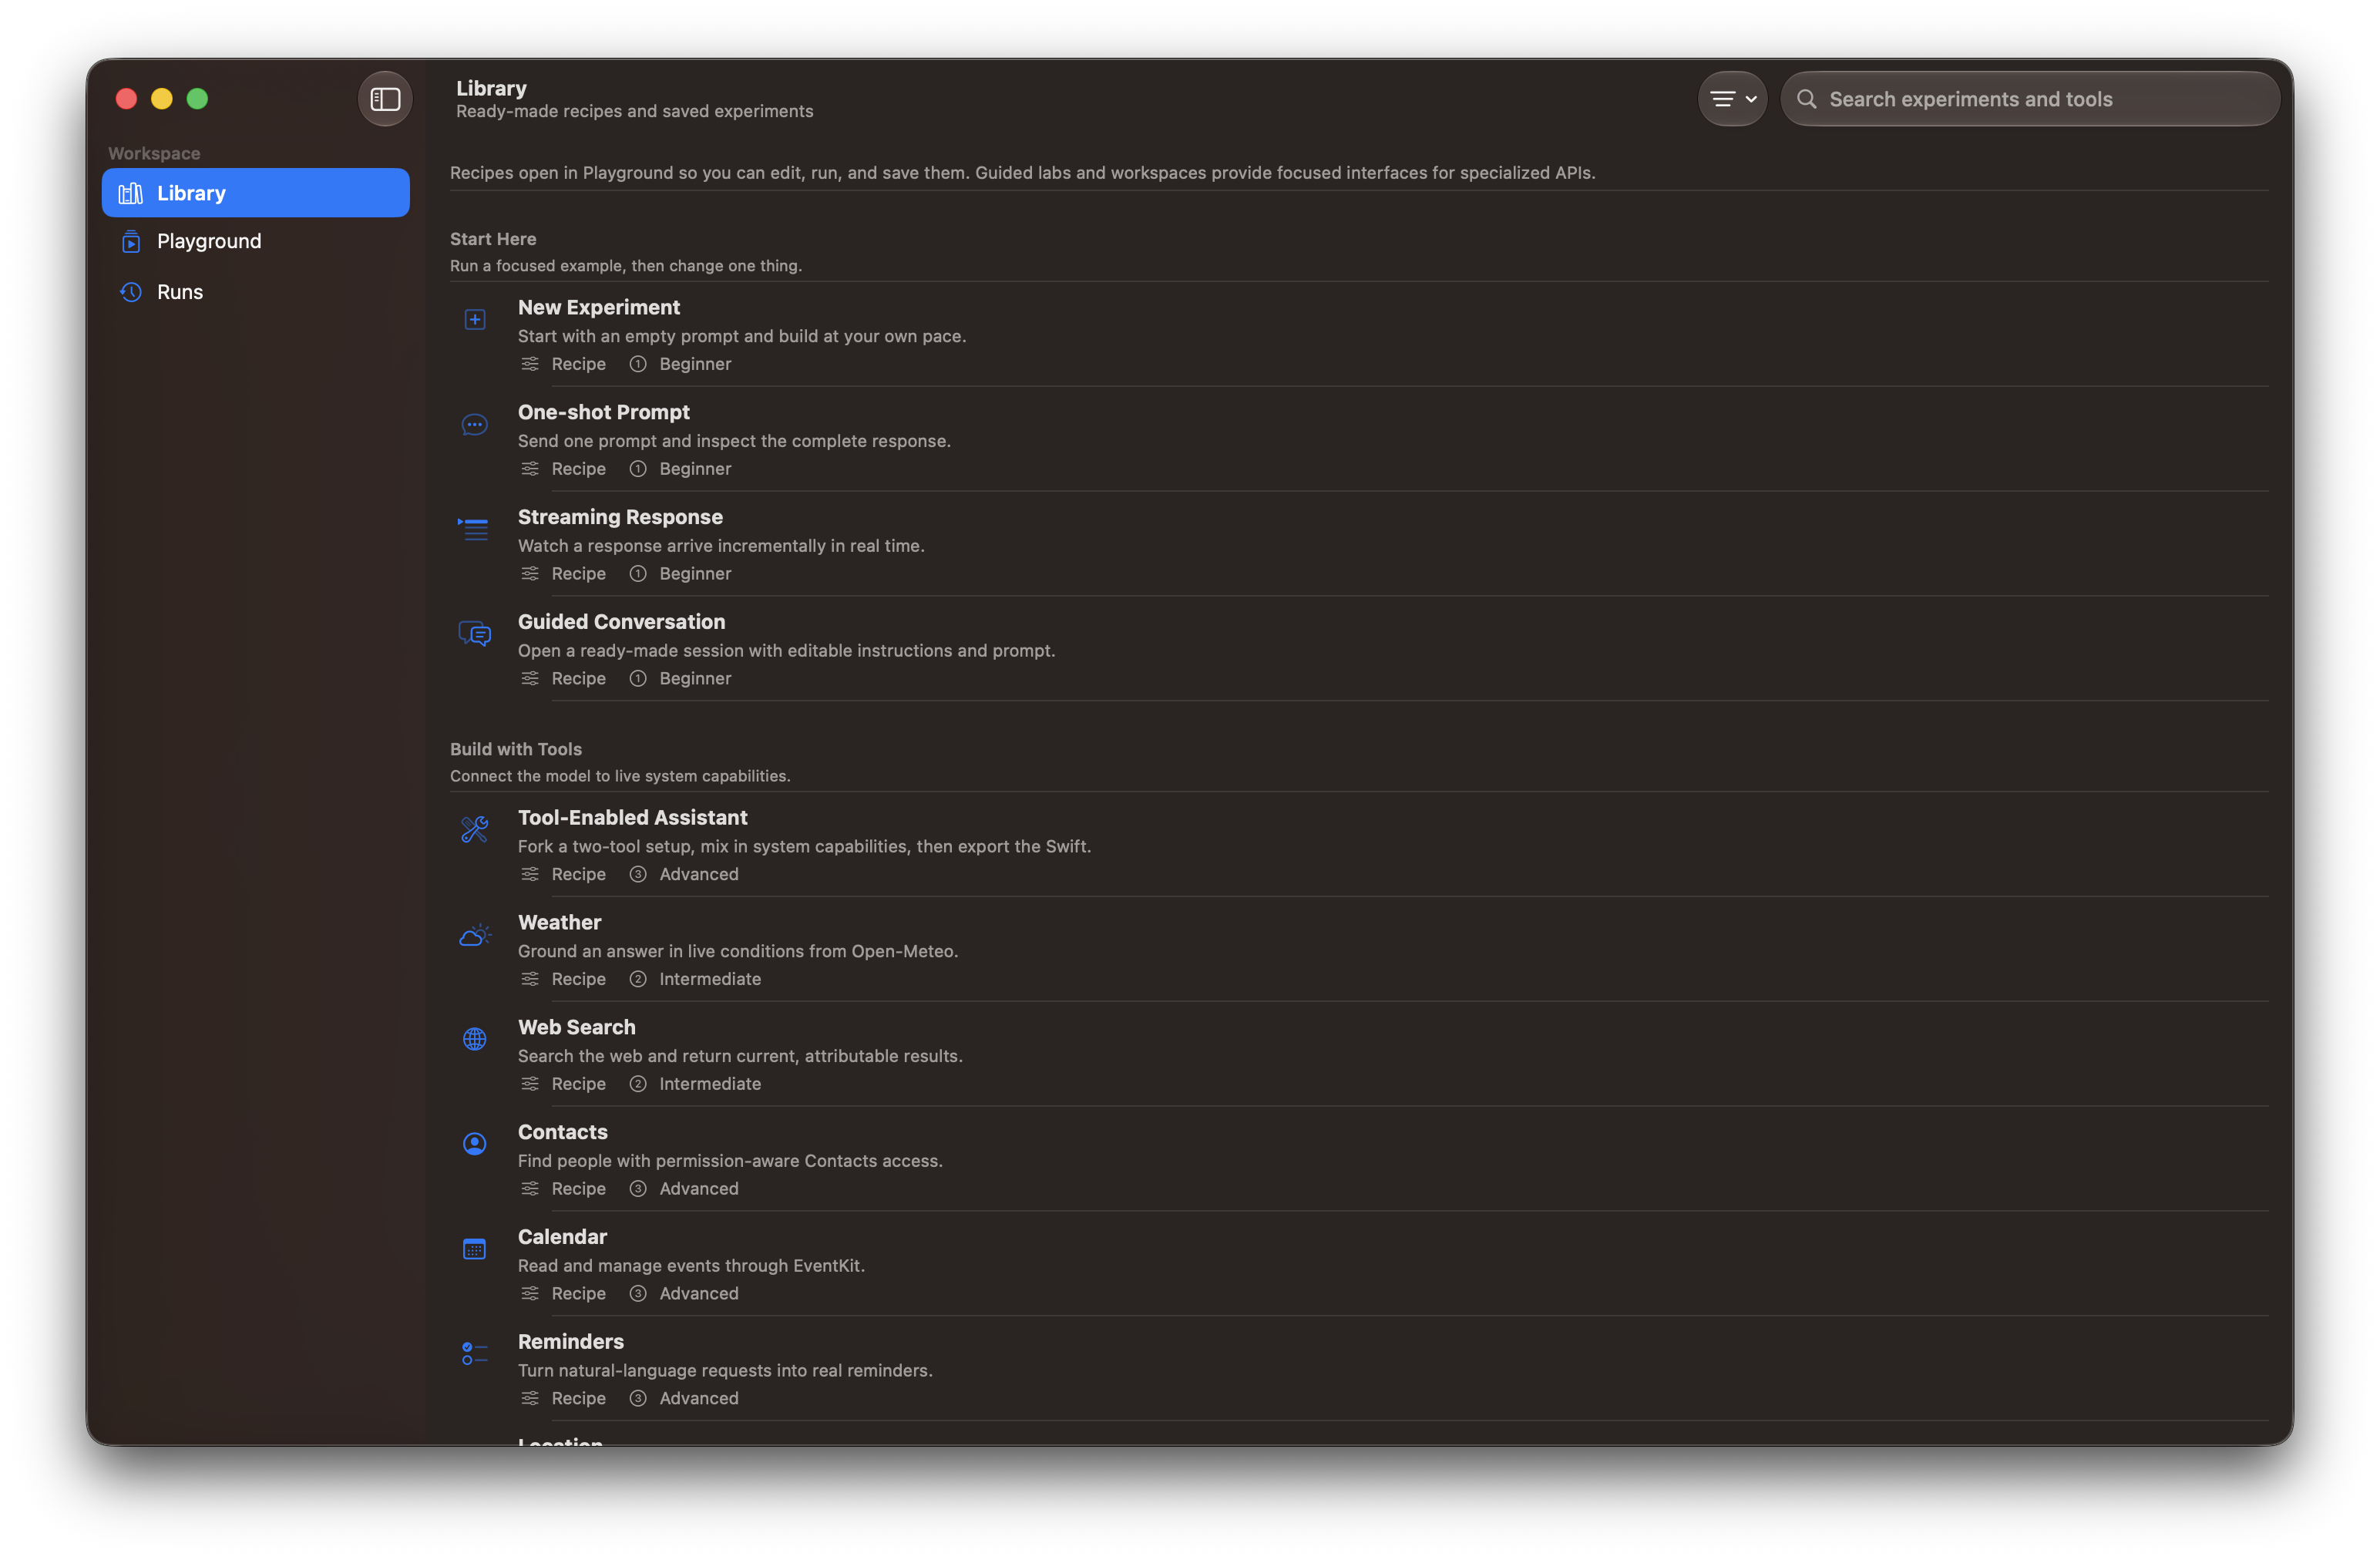
面向 Apple Foundation Models 框架的实战实验场,帮你在 iOS 和 macOS 上动手搭建、测试并评估端侧大模型应用。
开源地理空间处理引擎,提供栅格、矢量、影像分析与建模能力,适合做 GIS 数据处理和遥感影像分析。
截屏后调用大模型识别并解答屏幕内容,代码报错、题目图表、外文资料框选即得答案,常驻后台可当面试或刷题助手。

面向企业审计场景的可审计 AI 智能体平台,让智能体基于证据工作、工具调用受管控,并内置评测、人工复核与整改交付流程。
一套用于构建 Web 医学影像应用的 JavaScript 库,提供渲染、分割等基础能力,方便开发放射科阅片类应用。
基于 TensorRT FP16 加速的 PP-OCRv6 推理服务,在 OmnidocBench 上跑出 200+ img/s,提供 HTTP 和 gRPC 接口,适合高吞吐文档解析与 RAG 场景。
把学习材料自动转成知识图谱和闪卡,用费曼技巧帮你检验是否真懂了,适合自学和教学场景。
30 个可直接运行的 Jupyter Notebook,系统演示 LLM Agent 的记忆方案,涵盖对话缓冲、向量库、知识图谱、情景与语义记忆,以及 MemGPT、Mem0、Letta、Zep 等主流实现和 LoCoMo 基准测试。
统一 RAG 检索环节的微调工具,覆盖 Embedding、ColBERT 和 ReRanker 三类模型,省去分别搭训练流程的麻烦。
用 Python 和 SQLite 搭建的个人知识图谱工具,把零散、异构的资料整理成带语义关联的主题网络,适合信息密集的研究和调查项目。
基于 G6 的 React 图可视化工具包,提供开箱即用的组件,帮你在前端快速搭建关系图、知识图谱等交互式图分析界面。

基于 WebGL 的 React 图可视化组件,能流畅渲染大规模网络图和知识图谱,解决普通 SVG 方案在节点边数多时卡顿的问题。
跨平台截图与录屏工具,按一次快捷键即可截取屏幕任意区域并上传到多个图床或存储服务,支持图片、视频、文本和 OCR。
给 Claude Code 加持久记忆:用 Obsidian 和 Graphify 建代码库知识图谱,把每轮对话 token 消耗最多降 71.5 倍。
用 Rust 写的高性能多线程 Redis/Valkey 替代品,可直接替换现有部署,并内置全文检索和向量搜索,适合做缓存和 RAG 检索后端。

提供 CUDA 加速的机器学习与信息检索基础算法和原语,方便快速搭建高性能应用,涵盖最近邻搜索、聚类、线性代数等常用模块。
基于 FalkorDB 图数据库构建 GraphRAG 应用的 Python SDK,把知识图谱和向量检索结合起来,让大模型问答更准确、可规模化。
轻量极速的重排序库,为搜索和 RAG 检索管线提供基于 LLM 与 cross-encoder 的 listwise/pairwise 精排,几乎不增加延迟。
基于视觉语言模型的无解析 RAG 方案,直接把文档当图片做检索和生成,省去 OCR 和版面解析环节,减少信息损失。
LanceDB 官方的示例与教程合集,用向量检索搭配大模型,演示多模态 RAG、Agent 和微调等场景的落地写法。