探索全部
共 1,808 个仓库 · 一年内有推送 · Python
基于 Python 的桌面语音助手,把语音识别和语音合成串起来,让你用说话的方式执行系统级命令、异步处理交互。
统一多模态模型的强化学习训练框架,打通 SGLang、vLLM 推理后端,方便把多模态大模型跑通 RL 训练流程。
一条命令就能把 Reddit 的帖子、评论和用户数据批量抓取下来,导出成 CSV 或 JSON,方便做数据分析和存档。
基于 YOLO 系列模型和 TensorRT 加速的 FPS 游戏自动瞄准工具,用 GPU 实时检测画面中的目标并驱动准星移动。

用 Python 快速搭建复杂视频分析应用的多进程框架,把检测、跟踪等环节串成流水线,解决视频流处理中并行调度和模块编排的问题。

把 Kaldi 语音识别工具包封装成 Python 接口,让你能在 Python 里直接调用 Kaldi 的特征提取、声学模型和语言模型,省去写 C++ 胶水代码的麻烦。
用卫星影像合成可沉浸漫游的 3D 城市场景,结合 3DGS 与扩散模型补全视角,解决大范围城市三维重建数据不足的问题。
基于 FalkorDB 图数据库构建 GraphRAG 应用的 Python SDK,把知识图谱和向量检索结合起来,让大模型问答更准确、可规模化。
企业级 AI 资源纳管平台,用统一网关接入 OpenAI、Claude、DeepSeek 等主流模型,做 Token 调度、成本归因和安全审计,帮企业管住 AI 开销、算清 ROI。
Windows 上的笔记导出与迁移工具,适配七个平台、支持四种导出格式,还能离线阅读,并明确标注验证范围和失败状态,方便把笔记从旧平台搬走。
把自回归扩散模型蒸馏成少步采样,实现高质量实时交互式视频生成,解决扩散模型推理慢、难以实时出片的问题。
基于预训练流模型实现免反演文本编辑,无需先反演再重建,直接按文字指令修改图像,简化流程并提升编辑效果。
基于 TensorFlow 2 的端到端语音识别框架,支持 Conformer、ContextNet、DeepSpeech2 等模型,可做字符或子词级多语言识别与流式推理。
轻量极速的重排序库,为搜索和 RAG 检索管线提供基于 LLM 与 cross-encoder 的 listwise/pairwise 精排,几乎不增加延迟。
让大模型直接操控 Mac 的最薄封装层,通过辅助功能接口和 CDP 把桌面操作交给 Agent,省去复杂中间层。
Linux 上的离线语音听写工具,基于 whisper.cpp、Whisper 和 VOSK 引擎,支持 GPU 加速,在 X11 和 Wayland 下都能把说的话直接输入到任意应用。
终端里的开源编码智能体,能读懂仓库、规划多步改动、写改文件、跑命令和测试,并循环迭代直到任务完成。
MIT 协议的开源计算机视觉库,支持目标检测、实例分割和姿态估计,兼容 ONNX 与 PyTorch,方便在边缘设备上训练和部署模型。

自托管的浏览器多开管理面板,为每个账号创建独立指纹的隔离浏览器环境,可一键启动并配合 Playwright 做自动化,是 Multilogin 的免费替代。

基于 OpenAI Whisper 的实时语音转写框架,接收连续音频流分块并即时输出增量转写结果,不用等整段音频上传完再处理。
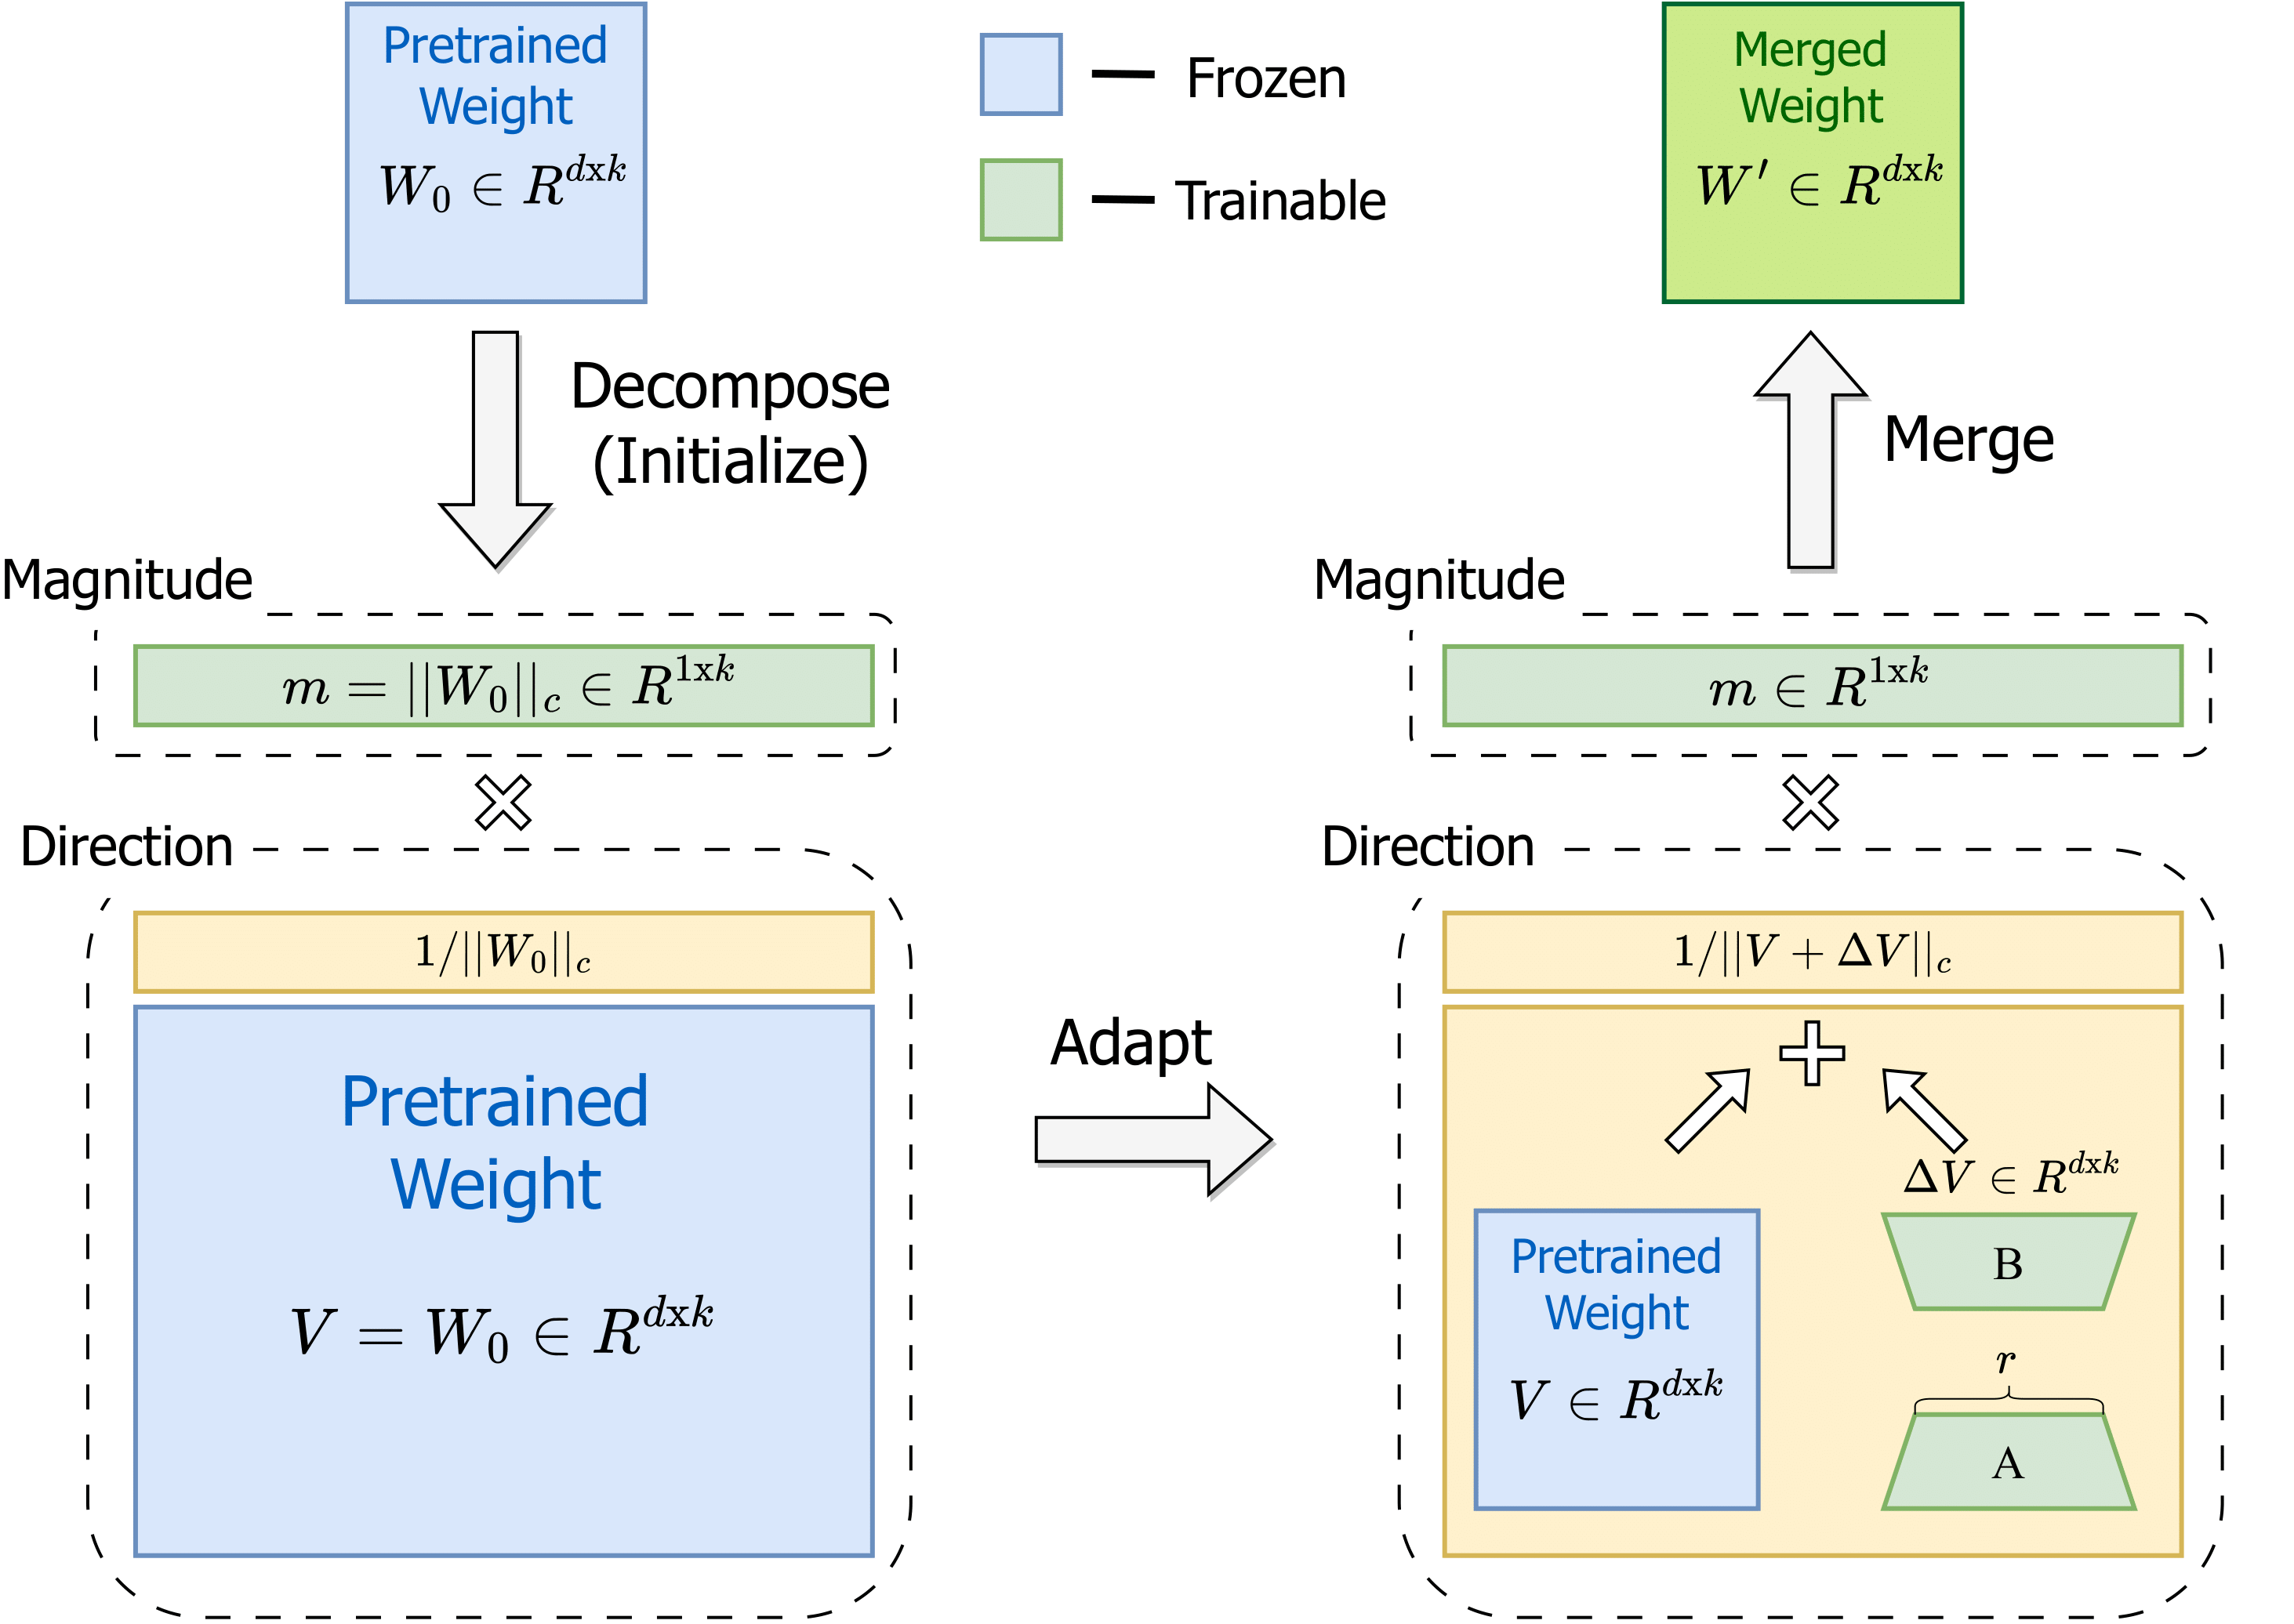
DoRA 是一种把权重分解为幅度和方向两部分再做低秩适配的微调方法,用更少的可训练参数逼近全量微调效果,适合大模型和视觉语言模型的高效微调。

用游戏当测试场来评估 LLM/VLM 智能体的框架,提供可复现的游戏环境和评测流程,方便对比不同模型在交互决策上的表现。
无需登录或 API Key 就能抓取 X/Twitter 的推文、回复、时间线和长文,给 AI Agent 和自动化流程提供数据来源。
把 ONNX 模型一键转成 TFLite、TensorFlow、PyTorch 原生代码或 TorchScript,省去跨框架部署时手写转换脚本的麻烦。