探索全部
共 1,808 个仓库 · 一年内有推送 · Python
基于 PaddlePaddle 的端到端中文语音识别项目,提供 DeepSpeech2、Conformer、Squeezeformer 等主流模型,既有入门案例也有企业级实战方案。

把 3D 高斯泼溅烘焙进扩散去噪器,单阶段从单张图快速生成和重建可扩展的 3D 场景与网格,免去多阶段流程。
基于 Python 的视频分析与计算机视觉框架,内置 NVIDIA DeepStream 和 CUDA 支持,可在边缘设备上快速搭建目标检测、实例分割等推理流水线。
把任意网站抓取打包成 ZIM 离线文件,配合 Kiwix 就能在无网络环境下浏览完整站点。

基于扩散模型的身份保持文本到视频生成方案,通过频域分解在生成视频中稳定保持人物面部身份,适合做可控人物视频生成。
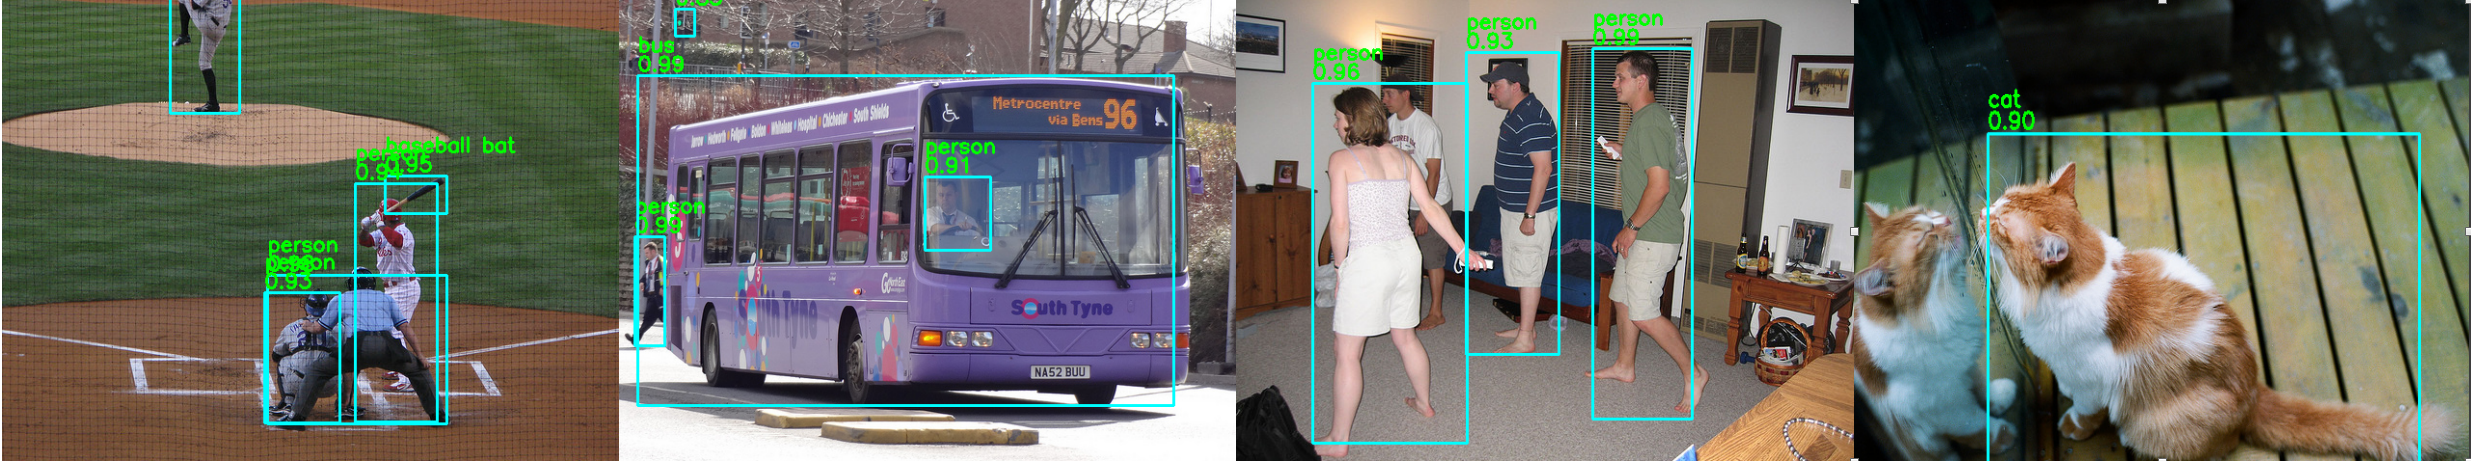
超轻量无锚框目标检测算法,权重仅 250K 参数,比 yolo-fastest 快 10%,后处理更简单,适合边缘设备部署。
在浏览器里跑安卓模拟器,为移动 GUI 智能体提供可验证、高并发的评测与在线强化学习训练环境。
给 Django 项目加一套多用户、多分组的待办与工单系统,支持 CSV 导入和邮件跟踪,省去自己搭任务管理模块的功夫。
Halo 是 White Circle 开源的大模型与多模态模型训练框架,支持分布式训练、LoRA 微调、MoE 和异步强化学习,方便搭建和扩展训练流程。
DIPY 是 Python 的 3D/4D 医学影像处理库,覆盖扩散、灌注与结构成像,提供配准、去噪、机器学习和可视化等通用方法。
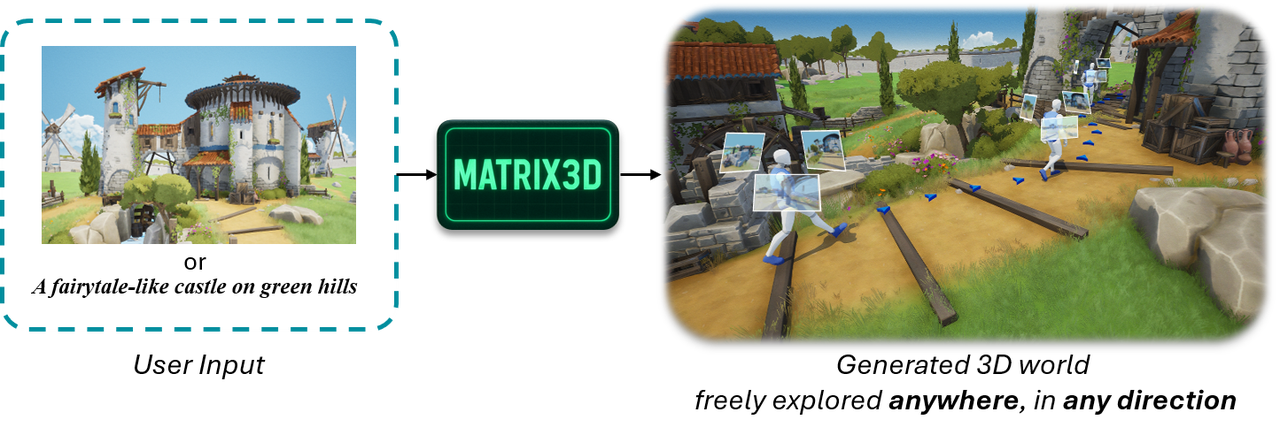
从单张图片或一句文本提示生成大范围可漫游的 3D 场景,先产出高质量全景视频再重建三维空间,适合做可探索虚拟场景。
把 Markdown 笔记丢进去,本地 Ollama 模型自动抽取概念并生成双向链接,让 Obsidian 知识库自己长起来,全程不联网、笔记不外传。
基于 PyTorch 的成像逆问题求解库,把去噪、去模糊、MRI 重建等任务统一到深度学习框架下,内置扩散模型和即插即用先验。
一个可审计的 AI 数据分析工作台,能查看结果背后的代码和证据、回放验证计算过程,并支持本地开源模型等多种模型选择。
Kandinsky 5.0 是一套文生视频与文生图的扩散模型家族,支持视频和图像生成,并带有蒸馏加速能力。
一款去谷歌化的 Android Chromium 浏览器,剥离追踪、遥测和 AI 集成,保留扩展与 uBlock Origin,并支持后台播放和媒体下载。
对 ONNX 模型做图级优化的 Python 工具,通过算子融合、常量折叠等变换精简计算图,让推理更快、模型更小。
用超网络直接生成 LoRA 权重,让大模型把事实性知识记进参数里,不用微调也能更新模型记忆。
用 Python 实现的 CTC 解码算法集合,包含最优路径、束搜索、词典搜索、前缀搜索和 token passing,用于语音识别和手写识别等序列模型的推理解码。
把 Discord 变成大模型聊天前端,接入 OpenAI、Gemini、Ollama 等多种 LLM,在服务器频道里直接对话。
面向 NVIDIA GPU 和昆仑 XPU 的大模型训练框架,覆盖 LLM、VLM、扩散模型和具身模型,支持 LoRA、预训练、SFT 与中期训练,开箱即用适配 DeepSeek、GLM、Kimi 等主流模型。
几分钟内就能在本地或远程部署任意 AI 模型、智能体、数据库、RAG 和流水线,省去繁琐的环境配置和运维工作。
让视频扩散 Transformer 无需重新训练就能生成远超训练时长的长视频,通过改进位置编码实现长度外推,兼容 CogVideoX、HunyuanVideo 等模型。
用向量嵌入找出大型或混乱代码库中重复的逻辑,帮维护困难的项目定位可合并的冗余代码。