探索全部
共 172 个仓库 · Jupyter Notebook
一套面向音频处理的深度学习实战代码集,覆盖语音识别、说话人验证、关键词唤醒、语音合成与音色转换等任务,可直接参考实现来训练和微调模型。
微软 Foundry 的示例、文档与加速器合集,用 Jupyter Notebook 演示 Azure OpenAI、ChatGPT、DALL·E、嵌入模型等服务的调用方式。
把 Segment Anything 模型适配到显微图像上的分割工具,支持细胞、细胞核、线粒体等结构的自动与交互式分割,并集成 napari 做可视化标注。
一套不依赖框架的 Colab 实战笔记本,覆盖模型 API、结构化输出、工具调用、RAG、评测、Agent 循环、LoRA 微调与提示注入防护,帮 AI 工程师和 FDE 快速上手真实技能。
汇集大语言模型自定义训练与推理的教程、最佳实践和可直接运行的代码,基于 HuggingFace 和 Transformers,帮开发者快速上手 BERT 等模型的微调与部署。

一套 Colab 笔记本,手把手演示蛋白质与 RNA 结构预测、设计、对接等深度学习工具的用法,适合边跑边学。
提供在 Google Cloud Vertex AI 上搭建端到端 MLOps 工作流的模板与示例,覆盖训练、部署到监控的完整流程,方便快速落地机器学习运维。
把 SAM3 通过渐进式知识蒸馏压缩成轻量边缘模型,实现快速的可提示概念分割与跟踪,适合端侧部署。
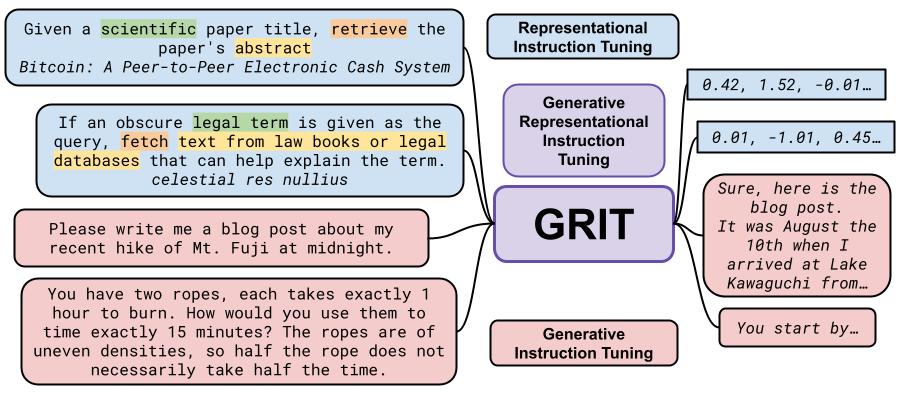
把大模型同时训练成嵌入模型和生成模型,一个模型既能做文本向量化检索,又能直接生成答案,省去部署两套模型的麻烦。

面向融合位姿估计与建图算法开发验证的开放驾驶数据集,提供真实道路采集的传感器数据,适合做 SLAM 和定位研究。
用大模型对本地文档做检索问答,集成 HyDE、SPLADE、重排序和 Chroma 向量库,适合快速搭建 RAG 应用。
只用 ViT 编码器做图像分割的官方实现,省去解码器和额外适配模块,在实例、全景分割任务上兼顾精度与推理速度。

把 Hugging Face 的 Transformers、Diffusers 等模型接到 Intel 的 OpenVINO 等优化工具上,加速 CPU/GPU 推理,覆盖 LLM、语音识别、语音合成和多模态模型。
用 TensorFlow/Keras 串联从文本预处理到 BERT、GPT、LLM 下游任务的实战教程,覆盖 NER、LoRA、DPO 等,适合系统学习 NLP 建模流程。
一堆可直接在 Google Colab 上跑的生成式 AI 笔记本,覆盖 ComfyUI 工作流、Flux Kontext、混元、LTX 视频等图生图与图生视频玩法,省去自己配环境。
RectLabel 是一款离线图像标注工具,用于给目标检测和分割任务画框、打标签、生成掩码,支持 Faster R-CNN、Mask R-CNN、Detectron 等格式。

Cleora 是面向异构关系数据的通用嵌入学习模型,能高效、可扩展地生成稳定且支持归纳的实体嵌入,适合图与超图场景。
已归档的历史仓库,原用于向量检索与向量数据库的教程和工具集;团队现已转向自托管推理引擎 SIE,覆盖嵌入、重排、OCR 与文档处理。
输入一段文字就能自动生成视频脚本、AI 配音和会说话的人脸,快速产出无真人出镜的短视频,适合做 Shorts 类内容。

基于 GTSAM 的端到端运动恢复结构(SfM)框架,从多视角图像中重建三维场景与相机位姿。

《Transformers for NLP and Computer Vision》第三版配套代码,用 Jupyter Notebook 演示 BERT、CLIP、DALL·E 3、GPT-4o、Gemini 等模型在 NLP、视觉和 RAG 任务中的实战用法。

Redis 在 AI 生态中的社区资源合集,收录集成方案、示例项目和最佳实践,方便用 Redis 做向量检索和特征存储。
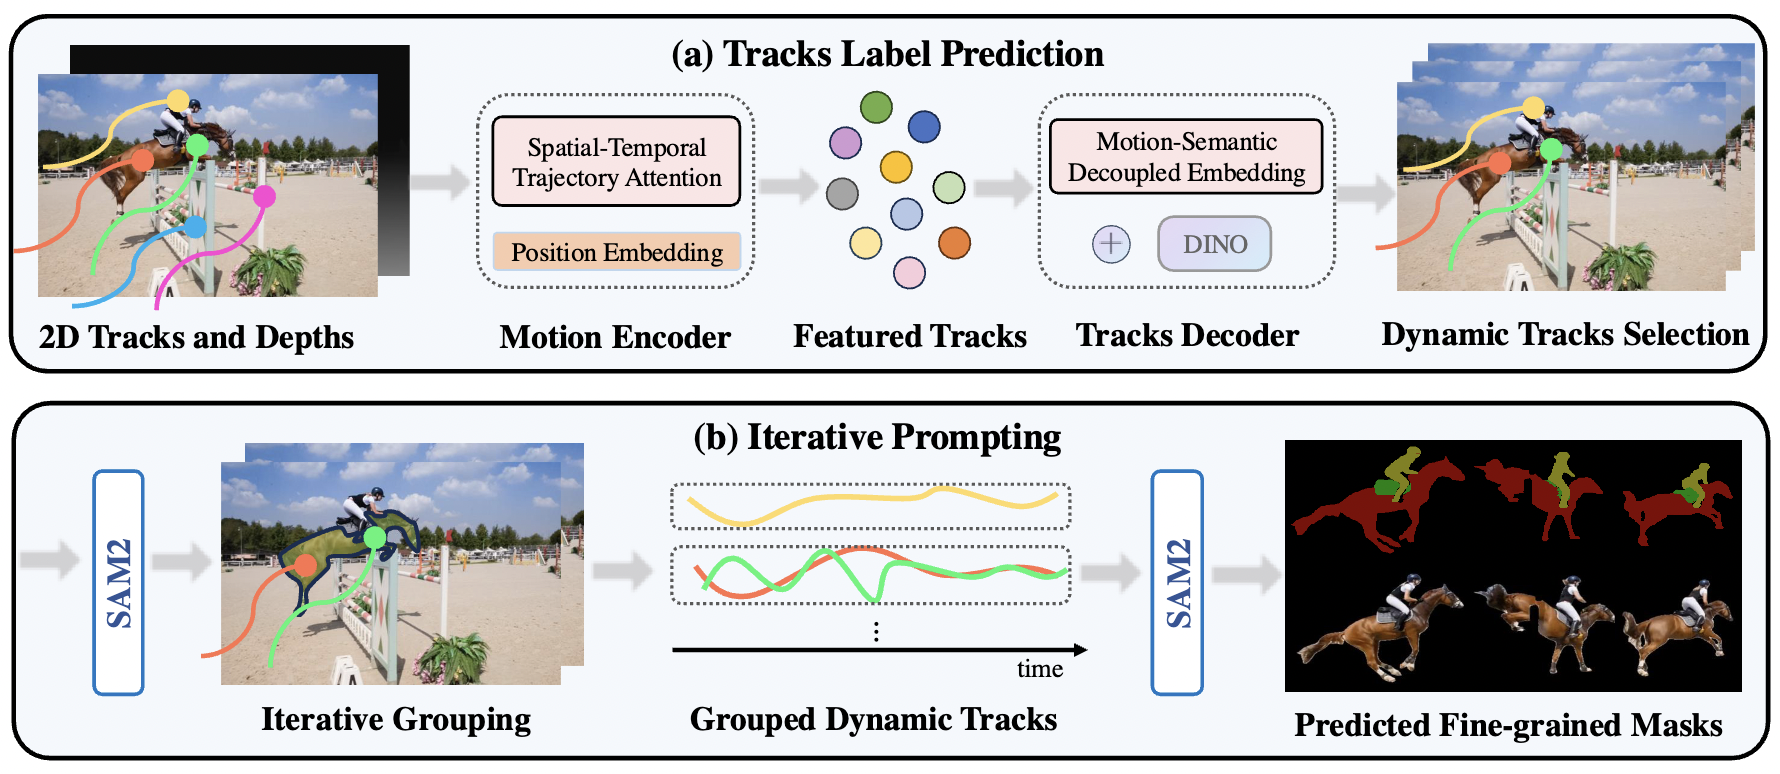
基于 SAM2 的视频运动目标分割与跟踪代码,能自动识别并分割视频中运动的物体,适合做视频编辑和运动分析。
MindSpore 官方的大模型实战课程,带你从 BERT、GPT 一路动手实现到 ChatGLM、LLaMA2,适合系统学习大模型原理与训练推理。