Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 32 / 43 页Shell and coding agent on mcp clients
用「思维模板」库增强大模型推理:把可复用的推理思路存成元缓冲区,遇到新问题时检索并套用,提升复杂任务准确率并降低成本。

把 Telegram 里的文件变成 Stremio 可播放的流媒体库,自动索引并串流,省去手动整理和下载。
腾讯混元开源的 2K 高分辨率文生图扩散模型,能根据文字直接生成高清图像,兼顾生成效率与画质。
用 pyannote 做说话人分离、Whisper 做语音识别,把会议录音转成带说话人标记的文字,再交给 ChatGPT 生成会议纪要。
开源自托管的 AI 视频生成器,在网页界面里输入文字就能生成带旁白、字幕和数字主播的多场景视频,完全免费。
按成熟度和开发生命周期整理的 AI 辅助开发模式合集,涵盖基础、开发、运维三类模式,配有实例和反模式,帮团队规范落地 AI 编码。
用 RANSAC 从点云中拟合平面、球、圆柱、长方体、圆和直线等 3D 基元,适合 LiDAR 与三维重建场景做形状检测和分割。
模块化 RAG 框架,能自由替换 LLM、嵌入模型和向量库,还支持 MCP 接入外部工具与数据源,省去重复搭建检索增强流程的功夫。
收录计算机使用智能体(CUA)的开放资源清单,整理经过审阅的论文、GUI 模型、数据集、基准测试和工具,并提供可直接复用的 JSONL/SQLite 数据。
面向 LLM 和扩散 Transformer 的无损压缩方案,在 GPU 推理时压缩模型权重、降低显存占用,同时保持输出完全一致。
给无声视频自动配上生动且与画面同步的音效,基于扩散模型实现视频到音频的拟音合成。
从 Moodle 教学平台批量抓取并下载课程资料(讲义 PDF 等),支持同步更新,省去逐页手动点击的麻烦。
用生成模型提升多视角 3D 物体重建精度,从多张图片还原准确的三维形状与位姿,适合做图像到 3D 的研究与落地。
开源的扩散式语言模型,专攻代码生成,一并放出预训练、评测、推理代码和模型权重,方便直接复现和二次开发。
给 LLM 维护的知识库定治理规范,并提供参考工具链,让 AI 代理改文档时有确定性校验和人工审核,避免知识库越改越乱。

把 B 站、YouTube 和本地视频自动转成 AI 摘要与可检索知识库,基于 Whisper 转写和 RAG,适合做视频笔记和 Obsidian 归档。
基于 llama.cpp 的 LLM 智能体框架,支持对话、结构化函数调用和结构化输出,即使模型未针对 JSON 或函数调用微调也能用。
NOVA 是一种无需向量量化的自回归视频生成方法,用扩散式连续表示替代离散 token,绕开 VQ 编解码器直接生成视频。
面向 LLM 与 Agent 场景的开源强化学习训练库,集成 GRPO、PPO、熵方法等算法,支持编码、GUI、多智能体等任务。
围绕预训练权重做黑盒优化与神经进化,用 LoRA 集成多个任务专家,提升大模型后训练与推理表现。

用稀疏控制点驱动 3D 高斯泼溅,从视频重建可编辑的动态场景,支持对运动轨迹做编辑和操控。
面向本地和自托管文档搜索的 Agentic RAG 方案,基于嵌入式 LanceDB 实现混合检索、重排序和多模态 RAG,并自带 Docling 解析与 MCP 服务。
把手机拍摄的视频重建为可被 AI 查询的 3D 场景,内置 MCP 工具让 Claude、Cursor 等直接调用,并提供可自托管的 broker 与 VGGT-SLAM 库。

用 Python 实现语义超图的基础库,把知识表示成可计算的超图结构,适合做知识库、认知建模和自然语言理解等需要表达多元关系的场景。
让 LLM 智能体自主操作电脑的框架,靠视觉感知的分层记忆和自写技能实现自我进化,解决智能体长期记忆与能力积累问题。
面向 AI 秋招的中英双语面试速查表,覆盖机器学习、大模型、扩散模型与智能体,可生成单文件 HTML 随时翻阅,另附学术主页生成器。
基于认知强化学习、用推理链引导的文本指代图像分割方案,让多模态大模型先推理再分割,提升复杂场景下的分割精度。
基于 Agently 框架搭建的每日新闻自动采集工作流示例,用 LLM Agent 完成搜索与汇总,适合参考如何编排多步 Agent 应用。
基于扩散 Transformer 的开源文本生成音乐模型,输入文字描述即可合成音乐片段,适合做 AI 音乐生成的研究与二次开发。
xLAM 是一系列专为 AI Agent 系统设计的大动作模型,能把自然语言指令转成可执行的动作调用,帮开发者搭建和驱动智能体。
把语言模型直接当作统一的多模态生成器,用自回归方式同时做文本到图像生成,省去额外扩散模型。
用 Cython 加速 fastText 和 gensim 模型计算句向量,比原生 Python 实现快一个数量级,适合需要批量生成句向量做相似度检索的场景。

全自动短视频搬运流水线,自动下载视频、去重处理、AI 生成标题标签并上传,支持 TikTok 与抖音、视频号、小红书等平台互搬,可二次开发扩展。
SINQ 是一种即插即用的 LLM 量化方法,能把任意大模型压小并尽量保住精度,适合显存吃紧时部署 DeepSeek、Qwen 等模型。
把 scikit-learn 训练好的模型和 Pipeline 转成 ONNX 格式,方便跨框架部署和推理加速。
基于扩散模型的指令式视频编辑方案,配套高质量合成数据集,解决视频编辑训练数据稀缺、难以规模化的问题。
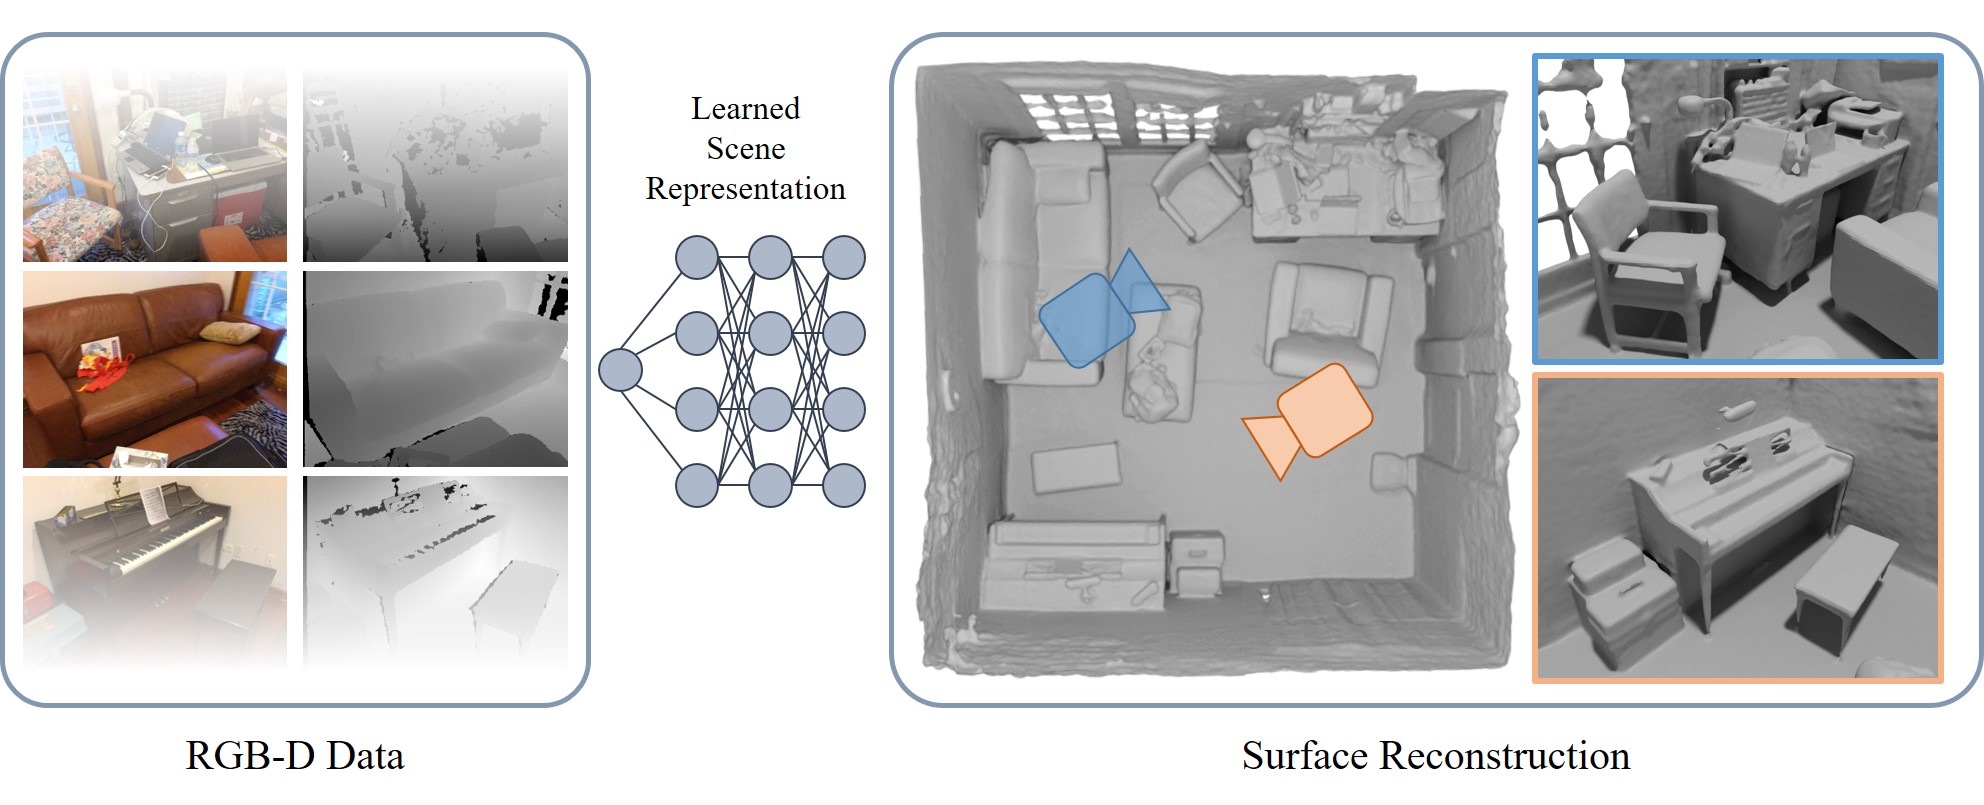
用神经网络从 RGB-D 序列重建高质量三维表面,是 CVPR 2022 论文的官方实现,适合做室内场景的稠密重建。
用点式隐式神经表示做 LiDAR SLAM,在保持全局地图一致性的同时完成定位与建图,适合机器人和 3D 建图场景。
面向 AI Agent 的文档解析评测基准,覆盖 OCR、PDF 解析和表格抽取,用统一指标对比不同模型与工具在真实文档上的解析效果。
用 LLM 智能体做加密货币量化交易的开源对冲基金系统,支持多时间框架分析、策略回测和自动决策。
开源的地球观测基础模型,能把 Sentinel-1/2 卫星影像和数字高程数据转成向量嵌入,方便做地表特征检索与下游分析。

在瑞芯微 NPU 上跑大模型的推理服务,类似 Ollama 的替代方案,通过优化 rkllm 让 Orange Pi 等设备高效离线运行 AI 模型。
给 AI Agent 用的本地优先记忆、决策引擎与治理框架,状态存在本地、可跨 IDE 迁移,解决 Agent 长期记忆和可控性问题。
把 GPT Image 2 生成的图片接入 Seedance 2.5 做图生视频的工作流指南,含提示词与 API 调用示例,帮你快速跑通从出图到成片的流程。
把长视频自动切成镜头、用多模态模型看画面写解说词、再配音合成成片,还能一键导出可编辑的剪映/CapCut 草稿,全程不用 GPU。
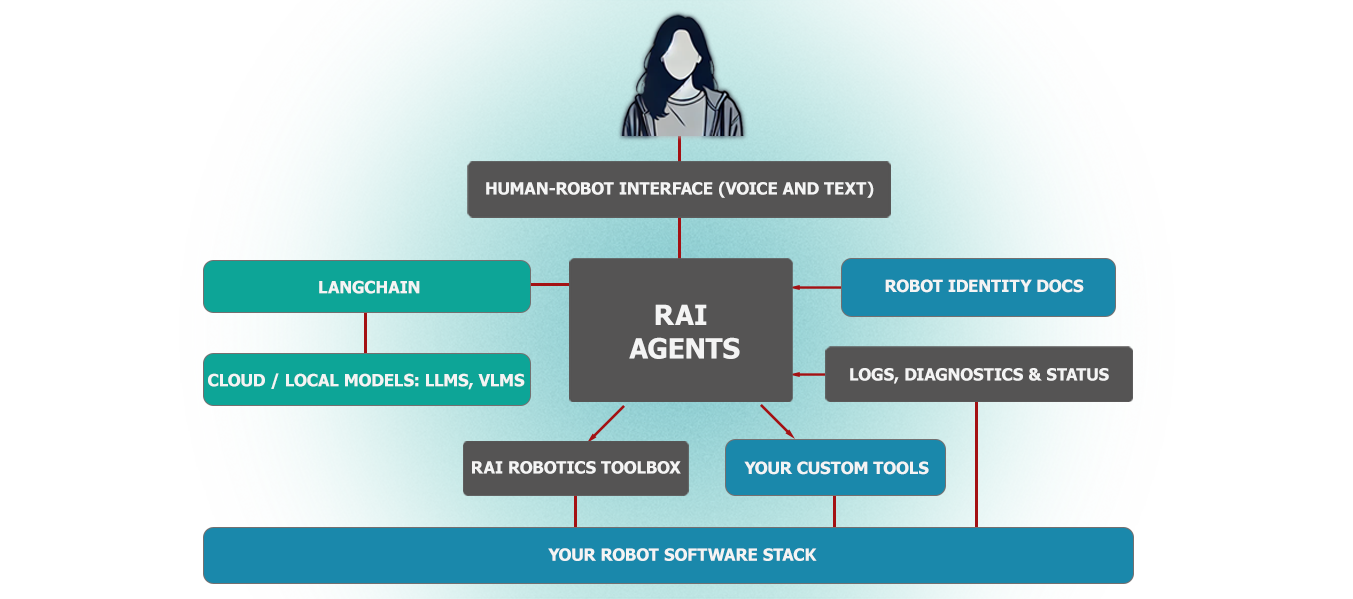
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。
一个通用的 Reddit 爬虫,能抓取任意子版块或用户的内容,适合做数据采集和舆情分析。