多模态生成

434 个仓库

图像、视频、语音与视觉语言模型。

AI-Faceless-Video-Generator
SamurAIGPT·Jupyter Notebook

输入一段文字就能自动生成视频脚本、AI 配音和会说话的人脸,快速产出无真人出镜的短视频,适合做 Shorts 类内容。

视频生成+4图像生成
5331102026-09-17 15:37 UTC
ai-shortfilm-prompts
jnMetaCode·Python

把一句想法扩写成可直接投喂 Sora、可灵、Veo、Seedance 的电影级视频提示词,内置 21 种类型模板和五段式结构,省去反复调 prompt 的功夫。

视频提示词+4视频生成
528+1099v0.4.02026-11-09 07:49 UTC
ai-agent-tools
cporter202

汇集 AI 工具、实用程序和资源的精选清单,帮开发者和创作者快速找到智能体框架、提示工程、文生视频等方向的现成方案。

AI 工具目录+4视频生成
5261392026-10-20 04:13 UTC
awesome-vla-for-ad
worldbench·HTML

汇总自动驾驶领域的视觉-语言-动作(VLA)模型资源,梳理其发展脉络与未来方向,方便快速了解该方向的研究与落地进展。

自动驾驶+4自动驾驶
524602026-11-06 04:53 UTC
GameScaling
THUSI-Lab·Python

在多种虚拟游戏世界中继续预训练视觉语言模型,打造能跨游戏泛化的具身智能体,并公开模型权重。

具身智能体+4视觉语言模型
510+10292026-10-29 07:15 UTC
comfyui-AICG3D
JGRFW·Python

ComfyUI 的本地短剧与长视频生成插件,基于 MiniMax H3 工作流实现无限时长视频,支持文生视频和图生视频。

视频生成+4视频生成
507+2971v1.1.132026-11-04 17:24 UTC
Awesome-Controllable-Diffusion
atfortes

收集扩散模型可控生成相关论文与资源,涵盖 ControlNet、DreamBooth、IP-Adapter 等方案,方便快速查找图像生成控制与定制化的资料。

可控生成+4图像生成
503292025-06-24 07:38 UTC
vla0
NVlabs·Python

把视觉语言模型直接改造成机器人操作策略,无需改动架构就能训练出顶尖的视觉-语言-动作模型。

视觉语言动作模型+3ROS / 机器人框架
498332026-02-21 19:18 UTC
frametell
sitor-ai·JavaScript

把想法和素材交给 AI 导演智能体,自动生成生动的讲解视频,支持本地优先运行并自由接入任意模型。
讲解视频生成+4视频生成
492+1097v0.7.42026-11-10 12:39 UTC
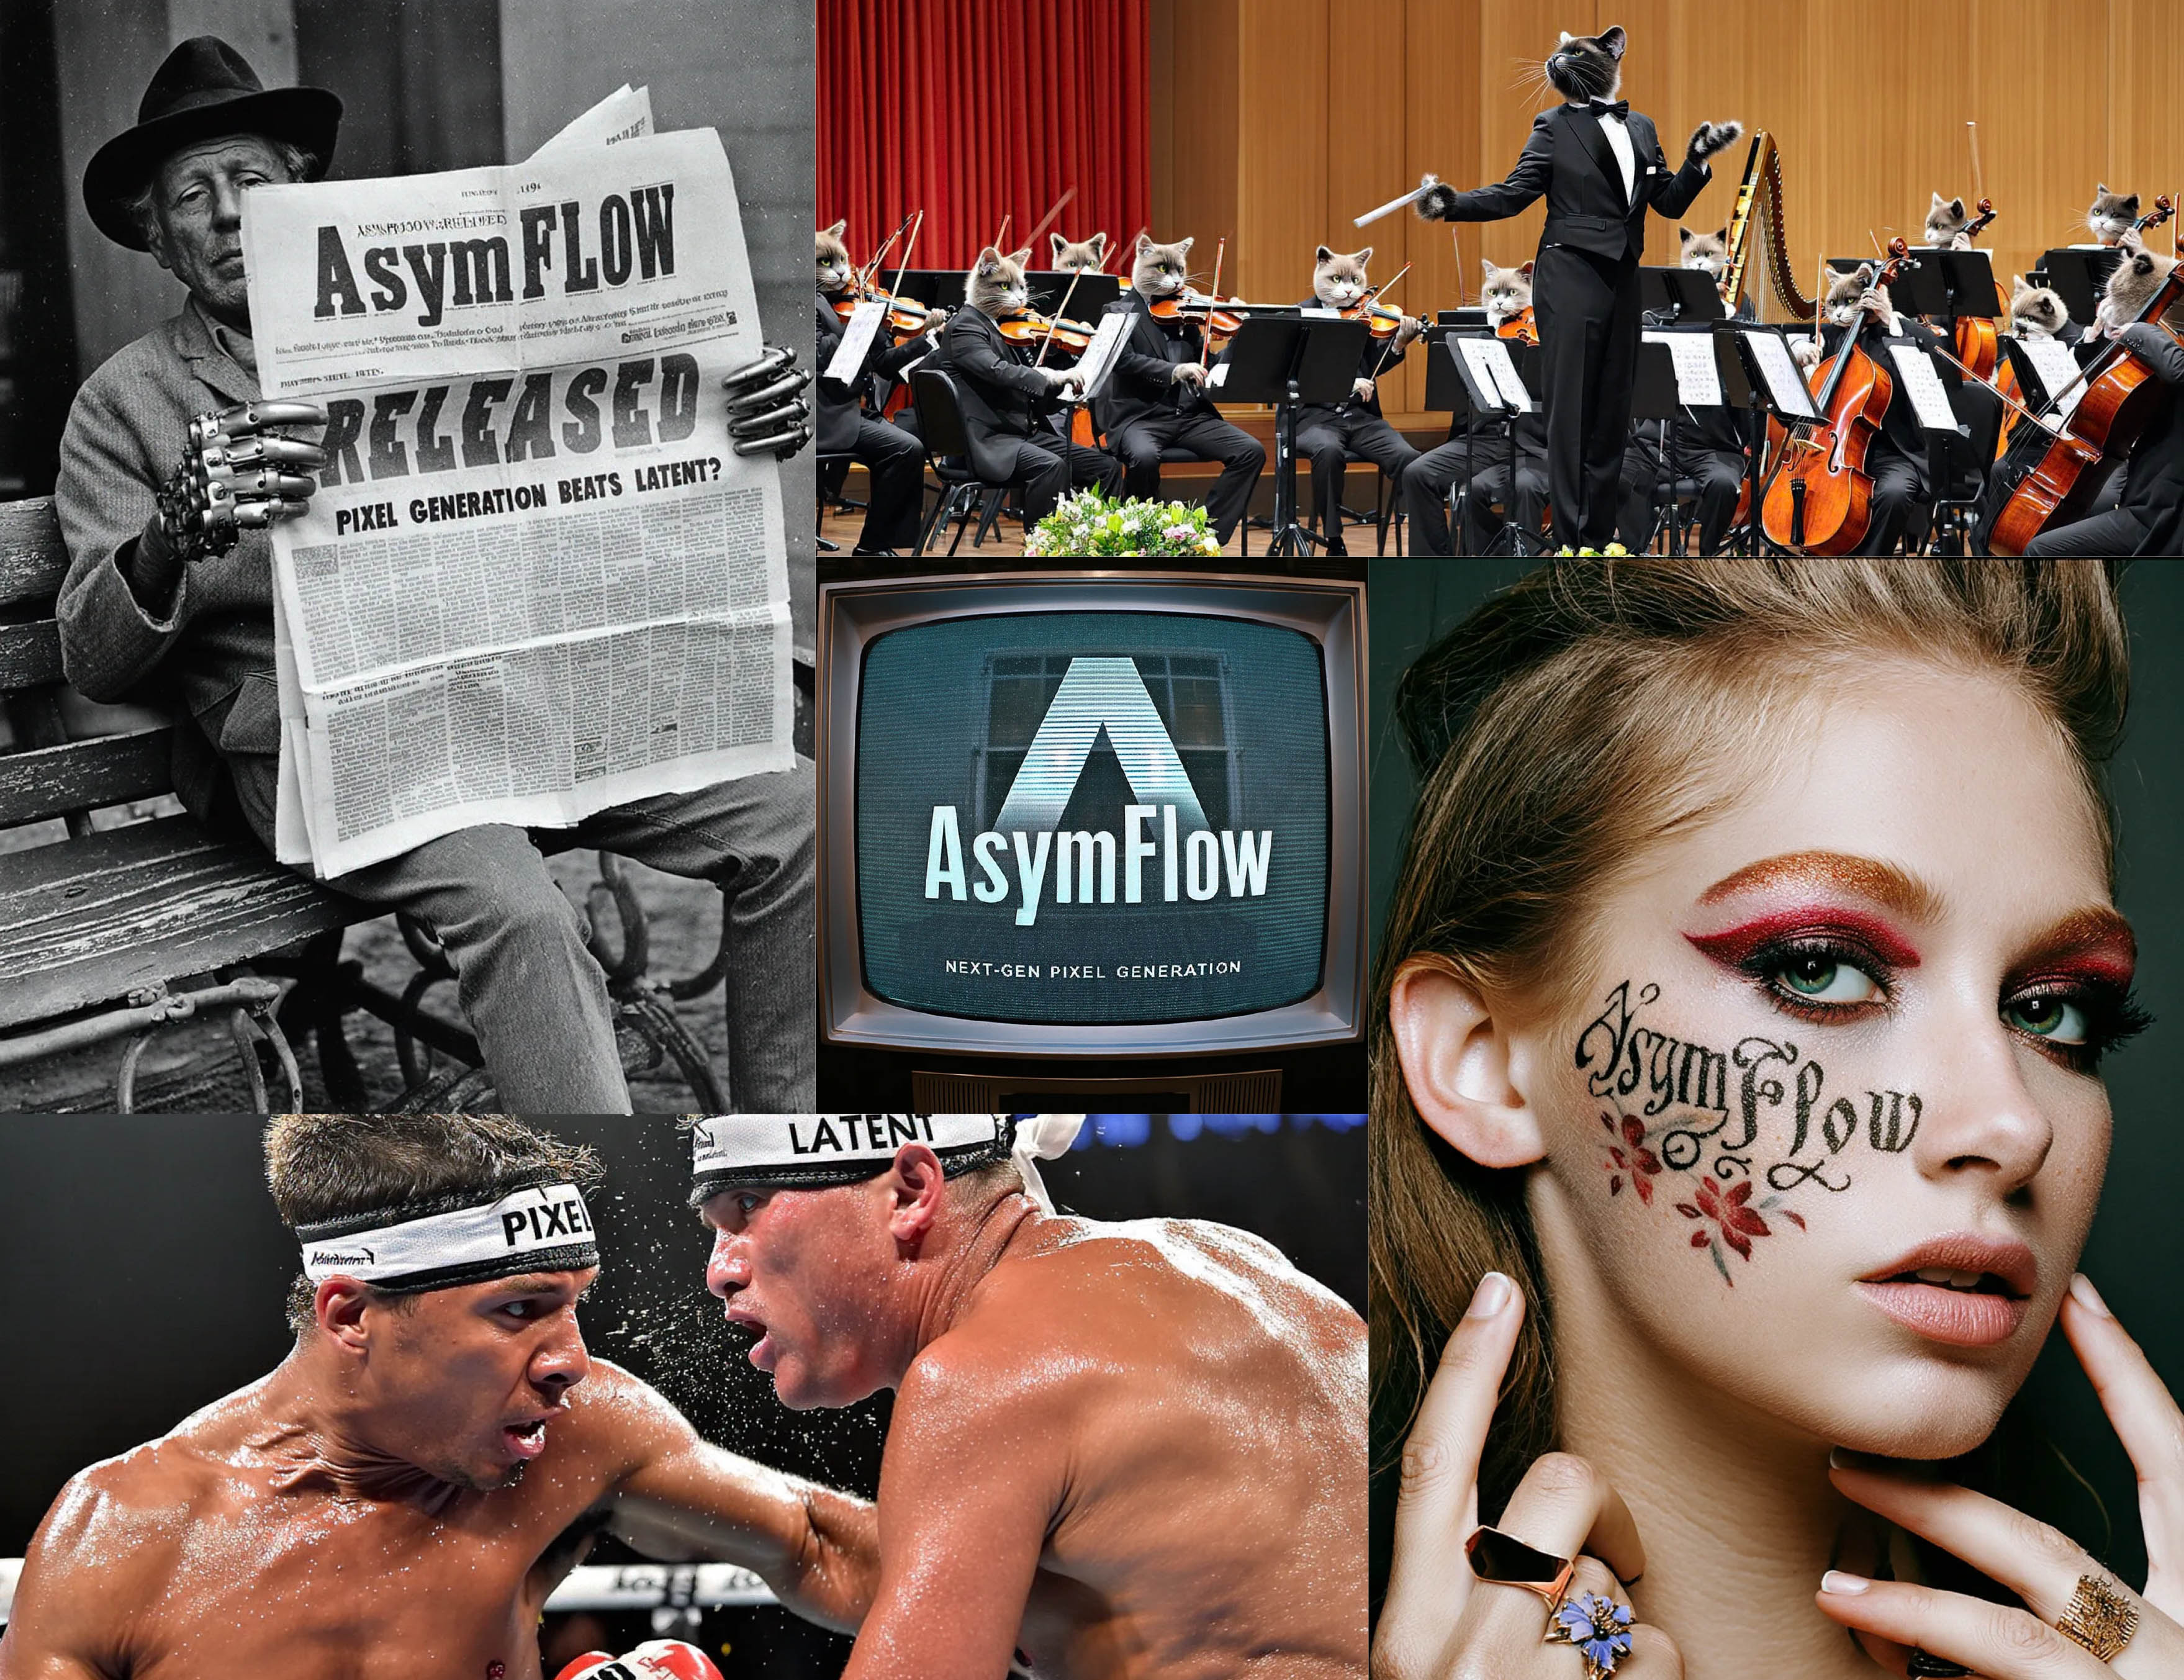
LakonLab
Lakonik·Python

提供 AsymFlow、pi-Flow、GMFlow 等流匹配与扩散蒸馏算法的官方 PyTorch 实现,用于加速文本到图像生成模型的训练与推理。
流匹配+4图像生成
479+228v0.2.22026-10-29 11:58 UTC
StyleShot
open-mmlab·Python

无需微调即可把任意参考图的风格迁移到任意内容上,生成高质量个性化风格化图片的风格迁移模型。

风格迁移+4图像生成
474412025-06-30 02:10 UTC
Awesome-Spatial-VLMs
vulab-AI·Python

汇总视觉语言模型空间智能方向论文与资源的 awesome 清单,配套综述《Spatial Intelligence in Vision-Language Models》,方便快速跟进空间推理研究进展。

空间智能+4视觉语言模型
473+162026-10-14 12:53 UTC
simlingo
RenzKa·Python

仅靠视觉输入就能完成闭环自动驾驶的视觉-语言-动作模型,把语言理解和驾驶动作对齐,在 CARLA 里做端到端评测。

自动驾驶+4自动驾驶
473732025-08-25 13:17 UTC
VisionZip
JIA-Lab-research·Python

VisionZip 是 CVPR 2025 提出的视觉语言模型加速方案,通过压缩视觉 token 减少冗余计算,在保持多模态任务精度的同时显著提升推理效率。

视觉语言模型+4视觉语言模型
46229v0.1.32025-07-21 05:44 UTC
clip-guided-diffusion
afiaka87·Python

用 OpenAI 的 CLIP 引导扩散模型,把文字描述直接生成图片,提供命令行工具和 Python 模块两种用法。

文本生成图像+4图像生成
459+161v0.2.52026-11-03 07:32 UTC
Montscan
sh4den·Rust

自托管的扫描件处理工具,通过 FTP、SMB 或监听文件夹接收扫描文件,用本地 Ollama 视觉模型识别内容并自动生成带日期的描述性文件名,再投递到 WebDAV 或本地目录。

扫描件处理+4视觉语言模型
457+132v2.0.02026-11-05 14:04 UTC
ltx-video-mac
james-see·Swift

在 Apple Silicon Mac 上本地跑 LTX-2 系列和 MiniMax H3 模型的视频生成应用,支持文生视频和图生视频,不用云端 GPU。

视频生成+4视频生成
455+460v2.3.872026-10-11 06:03 UTC
Ovis-U1
ATH-MaaS·Python

统一多模态模型,把图文理解、文生图和图像编辑整合进同一套框架,省去为不同任务分别部署模型的麻烦。

多模态理解+4图像生成
454152025-12-02 07:27 UTC
awesome-qwen-prompt-insight
XiaomingX

收集整理 Qwen 系列模型的优质提示词大全,覆盖文生图、文生视频等场景,可直接参考或贡献自己的提示词。

提示词大全+4图像生成
441482026-02-01 07:46 UTC
InternVLA-M1
InternRobotics·Python

面向通用机器人策略的空间引导视觉-语言-动作框架,把视觉语言模型和动作输出打通,让机器人能按空间指令执行操作任务。

视觉语言动作模型+4ROS / 机器人框架
438262026-10-09 08:35 UTC
uncensored-nsfw-ai-video-api
wideeyededi

提供成人向 AI 视频生成 API,支持 Seedance Spicy 与 Wan NSFW 模型的文生视频、图生视频,带异步任务、Webhook 回调和积分计费。
视频生成API+4视频生成
428+4652026-11-05 12:05 UTC
VEGA-3D
H-EmbodVis·Python

把生成模型里隐含的 3D 先验知识迁移到场景理解任务上,让视觉语言模型在空间推理时更懂三维结构。
空间推理+4视觉语言模型
428232026-06-18 14:20 UTC
Olympus
yuanze-lin·Python

把多模态大模型变成能调度各类计算机视觉任务的通用路由器,用指令调优统一处理检测、分割等任务,免去为每个任务单独建模。
多模态大模型+4视觉语言模型
427732026-08-05 01:11 UTC
reconstruction-alignment
HorizonWind2004·Python

RecA 用自监督学习让多模态模型在生成图像时借助自身的视觉理解能力,提升文生图和图像编辑的效果,可接入 ComfyUI 使用。

多模态生成+4图像生成
419192026-09-11 03:10 UTC