视觉语言模型
看图说话与文档理解。

MiniCPM-V 是面壁智能开源的多模态视觉语言模型,能在手机、PC 等本地设备上完成看图、听音和对话交互,无需依赖云端。

开源的多模态视觉指令微调模型,让 LLaMA 类大模型能看图对话,效果对标 GPT-4V,适合做图文问答和视觉助手。
持续录制电脑屏幕和音频,把日常工作流整理成可检索的记录,帮你找出值得自动化的环节,并为 AI 智能体提供上下文。

阿里云通义团队开源的多模态大模型系列,能同时理解图像和文本,用于视觉问答、图文推理等视觉语言任务。
把网页直接当像素图像来检索的 RAG 引擎,跳过 HTML 解析,靠视觉语言模型做原生搜索,适合构建多模态 Agent 的长期记忆。
开源多模态大模型家族,视觉语言能力接近 GPT-4o,支持图像分类、图文检索、语义分割和视频理解等任务。
一份持续更新的异常检测资源大全,汇总书籍、论文、视频和工具箱,覆盖传统方法与最新的 LLM、VLM 工作,适合快速入门和跟进前沿。
基于多模态大模型的 GUI 智能体家族,能看懂手机和电脑界面并自动点击操作,帮你完成跨 App 的自动化任务。

用两小时从零训练一个 65M 参数的多模态视觉语言模型,代码和流程完整,适合低成本复现 VLM 训练与对话实验。
在骁龙设备的 NPU、GPU 和 CPU 上本地跑大模型和多模态模型,几行代码就能接入,省去自己适配硬件的麻烦。
基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。
ERNIE 4.5 系列大模型与配套的工业级开发工具包 ERNIEKit,基于 PaddlePaddle,支持大语言模型和多模态模型的训练、微调与推理部署。
Google 开源的智能体应用开发框架,支持 JavaScript、Go、Dart 和 Python,内置 LLM 调用、多模态、RAG 与向量检索能力,帮开发者快速搭建生产级 AI 应用。
用强化学习(GRPO)训练视觉语言模型做视觉理解,把 DeepSeek-R1 那套推理强化思路搬到多模态场景,适合研究 VLM 推理能力。
在 Mac 上基于 Apple Silicon 用 MLX 跑视觉语言模型的推理与微调工具包,支持 LLaVA、Pixtral、Florence2 等多种 VLM,本地即可完成多模态任务。
用 100 多张原创原理图把 LLM 和强化学习的关键算法讲清楚,适合想系统理解大模型训练与 RL 机制的人对照学习。
给 DeepSeek、GLM 等纯文本编码助手外挂视觉能力的插件,粘贴图片即可输出包含 OCR、版面和语义的结构化 JSON 证据。
一个用人类反馈对齐任意模态大模型的开源训练框架,支持文本、视觉语言等多模态模型的 DPO 和 RLHF 微调。
把位图转成 SVG 的视觉语言基础模型,将矢量化当作代码生成任务,输出高精度、可直接使用的 SVG 代码。
开源语音合成模型家族,支持长语音、对话合成、音色设计、音效生成和实时流式 TTS,适合搭建多语言语音生成服务。
封神榜大模型是 IDEA 研究院开源的中文大模型体系,提供预训练模型、分布式训练和多模态能力,为中文 AIGC 与认知智能应用提供基础模型支撑。

Eagle 是一系列前沿视觉语言模型,主打以数据为中心的训练策略,能看图理解并回答多模态问题,适合做图文问答和视觉理解研究。
MiniMax 官方开源的文本大模型 MiniMax-Text-01 和视觉语言模型 MiniMax-VL-01,基于线性注意力架构,可用于长上下文理解与多模态推理。
一套可扩展的列柱式压缩框架,也是目前最快的开源列柱式文件格式,面向多模态和 Arrow 数据的高效存储与读取。
Skywork-R1V 是昆仑万维开源的多模态视觉语言推理模型系列,基于强化学习训练,擅长图像理解与复杂推理任务。
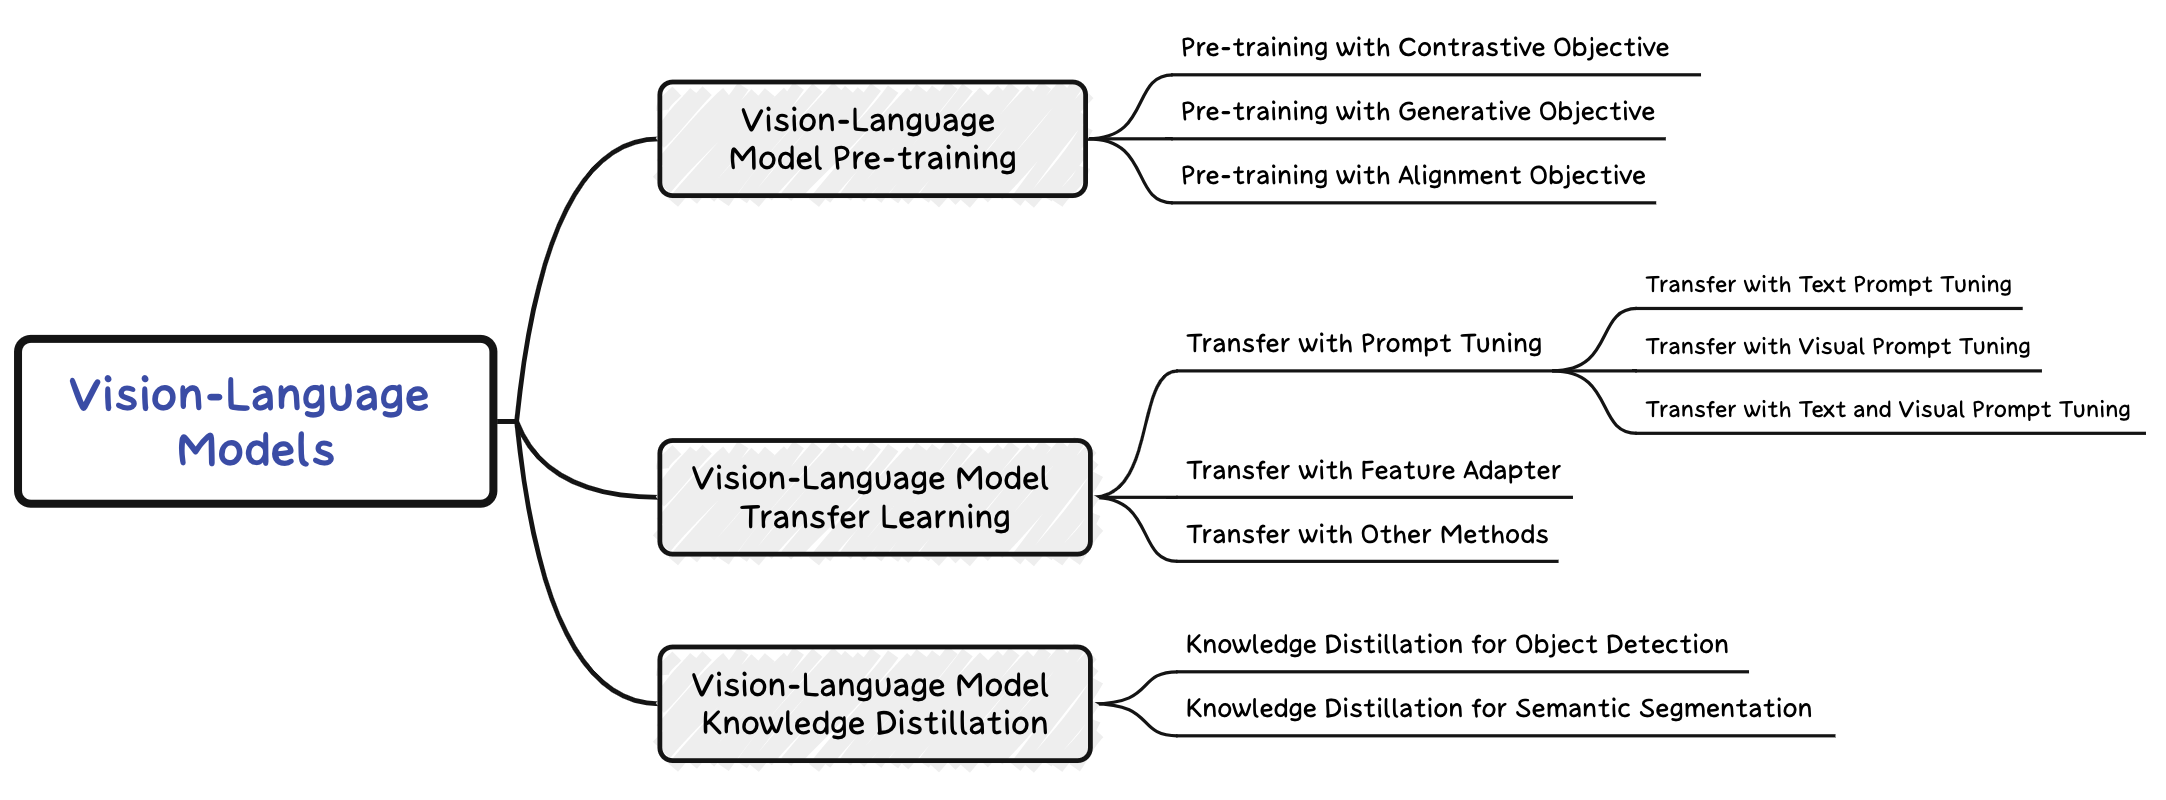
汇总视觉语言模型在视觉任务上的论文与资源清单,方便研究者快速跟进多模态预训练、迁移学习和知识蒸馏等方向的最新进展。
面向 Blackwell 架构 GPU 的高速 LLM 推理引擎,支持 DeepSeek、Kimi、GLM 等模型,主打极致推理吞吐与低延迟。
一个多模态语言 Agent 开发框架,把视觉模型和 LLM 编排在一起,帮你快速搭出能看能听的原型并推向生产。
GLM-4.6V/4.5V/4.1V-Thinking 系列视觉语言模型,通过可扩展强化学习提升多模态推理能力,支持图像理解、视频理解和图文问答。
端到端重放 ChatGPT Plus/Team/Pro 订阅协议的逆向工具集,自带从零实现的 hCaptcha 视觉求解器,用于反欺诈机制实证研究。

把视频按场景切分、去重抽帧并配上字幕文本,让 Claude 等大模型真正「看懂」视频内容,支持 URL 或本地文件,全程本地运行。
在本地设备上跑实时多模态 AI 的 Python 项目,整合语音识别、语音合成和本地大模型,实现类似 GPT-Live 的实时对话体验,支持 Apple Silicon 和 MLX。
面向视频分析与端侧 VLM 的 C++ 边缘推理引擎,支持算能、瑞芯微 RKNN 和 x86 平台,自带可视化编排、实时 OSD、事件与可复现基准。
开源微调 Qwen-VL 系列多模态大模型的实现,支持 Qwen2-VL、Qwen2.5-VL、Qwen3-VL 等版本,方便按自己的数据定制视觉语言模型。
汇总大语言模型、视觉语言模型、视觉-语言-动作模型和世界模型在自动驾驶领域的研究资源清单,持续更新,方便快速找到相关论文与项目。
阿里通义实验室 OCR 团队维护的文档智能算法集合,涵盖端到端 OCR、文档理解与多模态文档分析,帮开发者处理复杂文档识别任务。
把草图或科学图表图片自动转成可编辑的 TikZ/LaTeX 绘图代码,省去手写矢量图代码的麻烦。
收集大模型越狱攻击的前沿论文、代码、数据集与评测分析,帮安全研究者快速跟进 LLM 与多模态模型的攻防进展。
在手机等移动设备上高效运行多模态大模型的 C++ 推理引擎,让视觉语言模型能在端侧低资源环境下完成推理。
字节跳动开源的视觉语言基础模型,主打通用多模态理解与推理,在 60 个公开基准中有 38 项达到 SOTA,配套 Notebook 教程方便上手。
Ovis 是一种多模态大语言模型架构,通过结构对齐视觉与文本嵌入,让模型能同时理解图像和文字,适合做视觉问答、图文对话等任务。
用视觉语言模型从 PDF、Word、PPT 和扫描件等难搞文档里提取干净结构化数据,省去手工清洗的麻烦。
给图像和视频的指定区域生成详细描述的多模态模型,支持局部定位的细粒度 captioning,适合需要精确区域理解与描述的场景。

用视觉语言模型做摄像头监控,能理解画面内容而不只是检测移动,适合替代传统 NVR 的简单告警。

把大语言模型和适配时空视频表示的视觉编码器结合,让模型能围绕视频内容展开有意义的对话,并提供视频对话模型的量化评测基准。
汇总日语大语言模型资源的清单,涵盖基础模型与生成式模型,方便快速查找和对比日语 LLM 生态。
用计算图变换(如自动微分)加速飞行器设计优化,提供气动、推进、结构、轨迹设计等可组合分析工具,适合多学科设计优化场景。
汇总统一多模态模型的开源资源清单,涵盖图文生成、视觉语言模型等方向,方便快速查找和对比各类多模态大模型。
从零构建的免费开源、无审查图像描述视觉语言模型,专为扩散模型训练生成高质量图片说明。

轻量级多模态模型库,能同时理解多语言文本和图像,速度比 OpenAI CLIP 和 LLaVA 快 5 倍,适合做图文检索和内容生成。

开源多模态训练框架,基于 Qwen3 等底座训练视觉语言模型,降低多模态模型训练门槛。
面向机器人导航的开源平台,用多模态大模型和视觉语言动作模型构建通用导航基础模型,解决跨场景视觉导航与空间智能问题。
从零训练原生视觉语言模型的开源系列,去掉独立视觉编码器,让多模态理解与生成在统一架构里完成。
微软出品的 5 周 RAG 学习路线,用 Jupyter Notebook 带你从索引、混合检索到量化压缩,系统掌握检索增强生成。
用高分辨率语义编码器把视觉理解与图像生成统一到一个模型里,既能读懂图片,也能做文生图和图像编辑。

Alpha-CLIP 是 CVPR 2024 提出的 CLIP 改进模型,通过引入 alpha 通道掩码让视觉语言模型能聚焦图像中指定区域,解决传统 CLIP 无法控制关注位置的问题。
整理大模型训练数据全流程的精选资源库,覆盖数据获取、去重、过滤、配比、合成与溯源,配套「LLM × DATA」综述论文。
开源 11B 参数的多模态视觉语言模型,专攻长视频和实时流式视频理解,可用于视频问答等场景。
多模态指令驱动的矢量动画生成器,输入文字或图片即可输出可直接使用的 Lottie JSON 动画文件,省去手工制作矢量动画的繁琐流程。
整理 CLIP 等视觉语言模型上 prompt learning 与 adapter learning 方法的论文清单,方便做少样本、零样本分类的研究者快速找到相关工作和基线。