语音
TTS / ASR / 声音克隆。
OpenAI 开源的通用语音识别模型,基于大规模弱监督训练,支持多语言转写、翻译和语种识别,开箱即用。

本地运行的 ElevenLabs 开源替代品,支持声音克隆、语音设计、视频配音、听写、转写和有声书制作,覆盖 646 种语言。
只需 1 分钟语音数据就能训练出高质量 TTS 模型,支持少样本音色克隆,适合快速定制个性化语音合成。
用 5 秒语音样本克隆音色,实时合成任意文本的语音,基于 PyTorch/TensorFlow 的说话人编码与声码器流水线。

无需分词器的多语言语音合成模型,支持创意音色设计和逼真声音克隆,可直接从文本生成自然语音。
输入一段文本就能生成带笑声、叹息等非语言声音和背景音乐的语音,效果自然,适合做创意配音和音频内容原型。
5 秒克隆任意人声,实时合成任意语音,基于 PyTorch 的语音克隆与文本转语音工具。
开源的高质量语音合成模型,基于 VQGAN 和 Llama 架构,支持多语言文本转语音,效果达到 SOTA 水平。
用 TypeScript 快速搭建 AI 应用和智能体的现代框架,内置工作流、对话机器人和评测能力,省去自己拼装 LLM 调用链的麻烦。
工业级零样本语音合成系统,只需几秒参考音频就能克隆音色并跨语种合成,兼顾可控性与推理效率。
多语言大语音生成模型,覆盖推理、训练到部署全流程,支持中英日粤语及跨语种合成,适合做语音克隆和对话机器人。
把电子书(EPUB 等)一键转成有声书,内置 50 多种 TTS 引擎,支持声音克隆和 1696 种语言,适合批量制作多语言音频书。
把视频从一种语言翻译成另一种语言,自动生成配音和字幕并嵌入视频,适合做视频本地化和跨语言内容分发。
基于流匹配的语音合成模型官方实现,只需一段参考音频就能克隆音色并生成流畅自然的语音,适合做零样本 TTS 和语音克隆。
开源音乐生成基础模型,用符号规划、零样本翻唱和智能体编辑从歌词生成完整歌曲,适合研究音乐生成与风格迁移。
用 Python 直接调用微软 Edge 的在线语音合成服务,无需安装 Edge 浏览器或密钥,即可把文本转成自然语音。
超低延迟的语音转文字、意图识别和语音合成工具,用来搭建语音助手和语音交互界面,响应快、适合实时对话场景。
A fast, local neural text to speech system

基于 PyTorch 的说话人日志神经网络组件库,提供语音活动检测、说话人变化检测、重叠语音检测和说话人嵌入等预训练模块,方便搭建说话人分离与识别流程。
基于 so-vits-svc 改进的歌声与语音转换工具,支持实时变声、更友好的操作界面和更多功能,适合做 AI 翻唱和音色克隆。
A sound cloning tool with a web interface, using your voice or any sound to record audio / 一个带web界面的声音克隆工具,使用你的音色或任意声音来录制音频
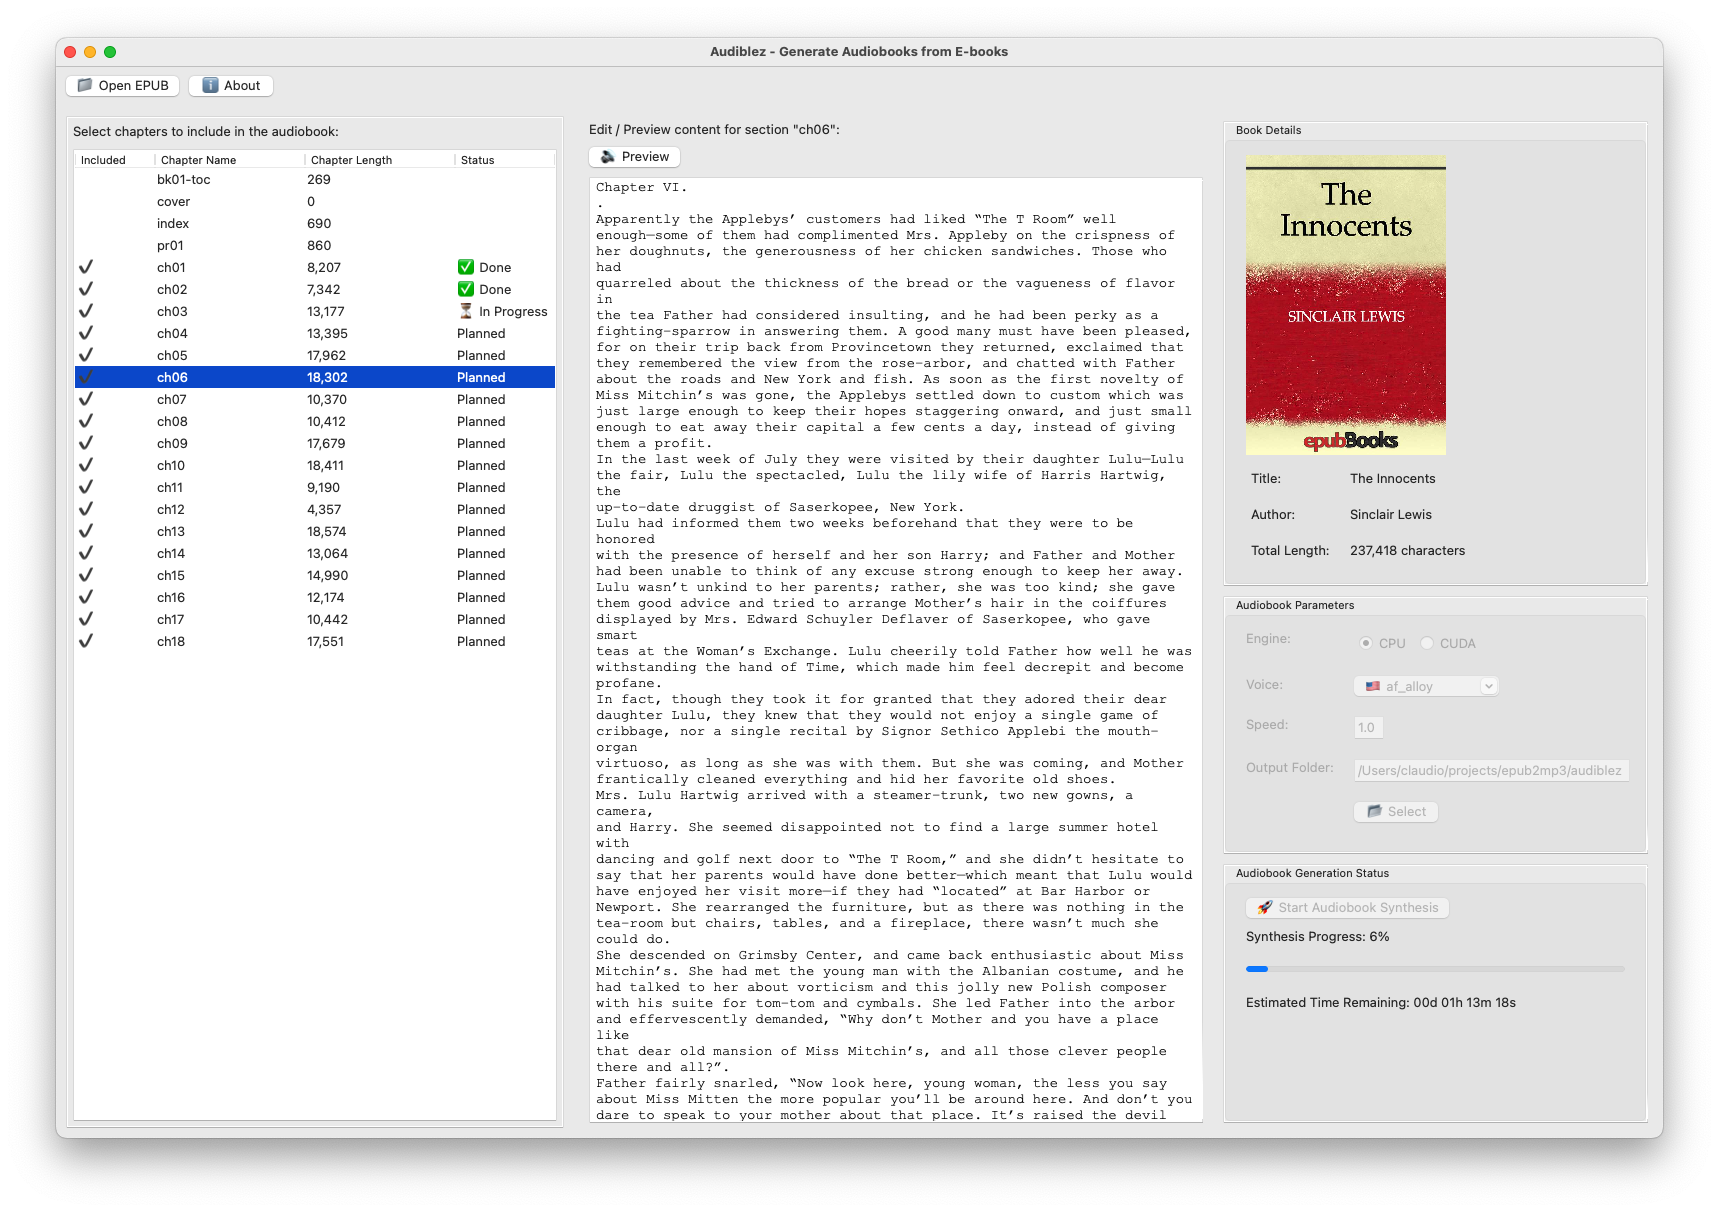
把 EPUB 电子书转成有声书的 Python 工具,基于 Kokoro 语音合成模型,适合想批量制作个人音频书的人。
基于 VITS2 骨干网络和多语言 BERT 的语音合成模型,能生成自然度较高的多语种语音,适合做 TTS 训练与推理。
多音色、支持提示词控制情感与风格的语音合成引擎,输入文本即可生成带情绪表现力的自然语音,适合做有声内容和虚拟人配音。
支持中英日韩法西六种语言的高质量语音合成库,适合需要多语种 TTS 能力的应用直接集成。
给 ChatTTS 套了个本地网页界面,输入文字就能合成语音,还能对外提供 API 接口,省去自己写前端和接口的功夫。
基于大语言模型的语音合成系统,能生成接近真人音色的自然语音,并支持实时流式输出,适合搭建低延迟的 TTS 服务。
预训练语音合成模型集合,支持俄语、亚美尼亚语等多种语言,几行代码就能把文本转成语音,省去自己训练模型的麻烦。
基于微软语音合成接口的桌面工具,用 Electron + Vue 构建,输入文本即可生成语音并导出音频文件。
开源 AI 视频本地化配音工具,把 YouTube/Bilibili 视频自动做语音识别、字幕翻译、声音克隆和混音渲染,一站式生成多语言配音成片。
把 Kokoro-82M 语音合成模型封装成 OpenAI 兼容 API,用 Docker 一键部署,支持多说话人、SSML 和字幕时间戳,CPU、AMD、NVIDIA 都能跑。
基于浅层扩散机制的歌声合成与语音合成模型,AAAI 2022 官方实现,支持 MIDI 输入生成歌声,兼顾合成质量与推理速度。
把 OpenAI Whisper 语音识别模型反过来用做文本转语音的开源 TTS 系统,基于 PyTorch 实现,可直接在真实语音数据上训练出多说话人合成效果。
把安卓手机变成可定制的 TTS 朗读器,内置微软演示接口,支持自定义 HTTP 请求、导入本地引擎,还能按中文引号自动区分旁白和对话。
开源语音合成模型家族,支持长语音、对话合成、音色设计、音效生成和实时流式 TTS,适合搭建多语言语音生成服务。
开箱即用的高质量语音转换工具,基于 PyTorch 和 RVC 实现变声与声音克隆,兼顾易用性和推理性能。
一个基于 Gradio + React 的 WebUI,把 GPT-SoVITS、CosyVoice、XTTSv2、Bark、MusicGen、RVC 等二十多种语音合成、音频生成与音乐生成模型整合到同一界面,省去逐个部署的麻烦。
面向越南语的本地语音合成工具,支持即时声音克隆,在 CPU 上实时推理并输出 48kHz 音频,适合做越南语 TTS 应用。
输入任意主题,自动生成带 TTS 旁白、字幕和章节进度条的黑底动态图形讲解视频,支持中英文,每帧都用 Remotion 代码绘制。
提供 CTPAPI 兼容接口,让 CTP 程序无缝对接 XTP、TORA、EMT、TWS 等各券商柜台,并附带 7x24 可用的期货、期权、股票模拟交易环境,可替代 Simnow。
用 Python/C 实现的强制对齐工具,能把音频和对应文本自动对齐到词或音素级别,适合做语音数据集标注和字幕时间轴生成。
基于 Kokoro 模型和 ONNX Runtime 的轻量级语音合成方案,用 Python 就能在本地跑出高质量 TTS,省去复杂环境配置。
Python 库和命令行工具,调用 Google 翻译的文本转语音接口,把文字快速合成语音并保存为音频文件。
跨平台 AI 语言练习应用,基于 Electron 构建,接入 OpenAI 与 Azure 的对话和语音合成能力,让用户通过对话和朗读练习外语。
开源文本转语音工具,能把超长文本拆成多角色配音,适合做有声书和长内容朗读。
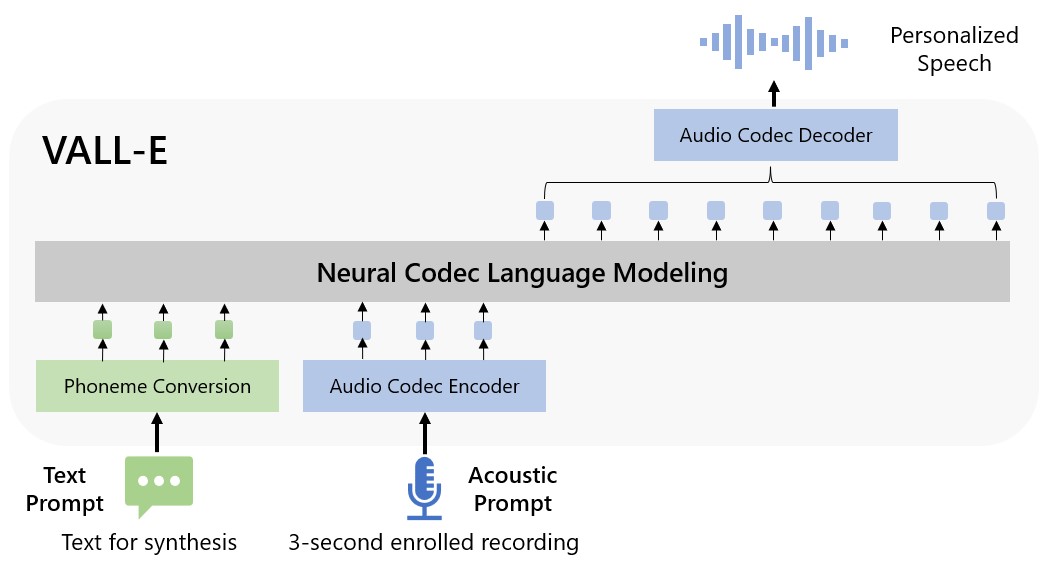
用 PyTorch 复现 VALL-E 零样本语音合成,只需几秒参考音频就能克隆音色朗读任意文本。
基于 PyTorch 的多语言语音合成工具包,支持 7000 多种语言的可控快速 TTS,可训练和微调自己的语音模型。
用微软 Edge 的在线语音合成能力,自建一个免费、高质量的 TTS 接口,直接替换 OpenAI、Azure 或 ElevenLabs 的付费语音服务。
本地离线的 AI 音频与音乐工作站,支持语音合成、声音克隆、带歌词歌曲和多轨乐谱生成,无需联网和 API 费用。
在 Arduino ESP32 硬件上跑实时语音 AI,通过安全 WebSocket 和边缘函数接入 100+ 模型,做 AI 陪伴设备。
把 EPUB 电子书自动转成有声书音频,内置 WebUI,输出格式适配 Audiobookshelf,支持 OpenAI/ChatGPT 语音合成。

把 Yandex Station 等带 Alice 语音助手的智能家居设备接入 Home Assistant,实现语音控制和 TTS 播报。
为 ComfyUI 提供工作流一键转 APP、屏幕共享与悬浮视频、GPT 与 3D 节点、语音识别和 TTS 等扩展节点,方便把生成流程直接做成可交互应用。
免费开源的语音合成引擎,支持俄语、英语、葡萄牙语等多种语言,可在 Android 和 Linux 上离线把文本转成语音。
把 GPT-SoVITS 语音克隆模型转成 ONNX 并做推理的引擎,方便在没有 PyTorch 环境里跑少样本音色克隆和语音合成。
Soprano 是一个超写实、低延迟的文本转语音引擎,能把文字快速合成接近真人音色的语音,适合需要即时发声的场景。
把微软 VibeVoice 语音合成模型接入 ComfyUI 的节点插件,支持单人和多人对话式语音生成,可直接在工作流里出高质量配音。
开源的 Android 语音助手应用,支持离线语音识别、唤醒词检测和语音合成,可替代系统自带助手。
面向双语会议的实时双向语音翻译工具,自动识别说话语言并双向互译,支持云端或完全离线本地运行,覆盖桌面端和浏览器插件。
在 Apple Silicon Mac 上原生微调大模型的工具,基于 MLX 支持 SFT、DPO、GRPO 以及视觉、语音、OCR 等多模态训练,API 兼容 Unsloth。