AI · 算法工程
共 1,645 个仓库 · Python
CodeGeeX2 是多语言代码生成预训练模型,支持多种编程语言的代码补全与生成,可作为编码助手的底层模型。
基于 Megatron 和 DeepSpeed 在 GPU 上训练大规模自回归 Transformer 的模型并行框架,用来复现和扩展 GPT-3 级别的语言模型。
一本从硬件约束和模型架构出发、用定量推导讲透 LLM 推理与训练系统设计的开源书稿,附全书正文、PDF 和配套计算工具,适合想搞懂 AI Infra 底层账怎么算的工程师。
把 PDF、扫描件等非结构化文档通过 LLM 抽取成结构化 JSON,可直接接入 API 和 ETL 流水线,省去手工写解析规则。
把 PDF、Word、PPT 解析成适合喂给大模型的格式,尽量不丢内容,省去自己清洗文档的麻烦。

一站式 WebUI,基于 Diffusers 和 PyTorch 统一完成 AI 图像与视频生成、打标和后期处理,省去在多个工具间切换的麻烦。
开源特征存储,统一管理机器学习特征的注册、存储与在线离线服务,解决训练和推理特征不一致的问题。
覆盖小学到高中数学、三年级到高中英语及初中物理的 K12 知识图谱,含 1644 个知识点、2403 条先修边和 6723 道题,对齐课标并支持自适应前置诊断。
单张图片就能快速重建出 3D 物体模型的前馈生成模型,适合需要批量产出 3D 资产的场景。
像 htop 一样在终端里实时查看 NVIDIA GPU 的进程占用、显存和利用率,还能导出指标接入 Grafana 做监控面板。
面向大模型训练的数据处理流水线,把原始多模态数据清洗、过滤、去重并加工成高质量指令微调语料。
从网页抓取正文和元数据的 Python 库与命令行工具,支持爬取、解析并导出为 CSV、JSON、Markdown 等格式,适合构建语料库和 RAG 数据。
中文 LLaMA-2 与 Alpaca-2 大模型二期项目,提供支持 64K 超长上下文的中文预训练和指令微调模型,可直接用于长文本理解与对话。
Open-source, self-hosted alternative to Grok Bot, Claude Duet, OpenAI Dots, Meta Muse, Instinct, Manus Cue: AI coworkers (named agents) with instructions, memory, routines, their own isolated computer, and your approval before they act.

基于大语言模型的 QQ 聊天机器人,主打拟人化对话风格,追求温暖真实的互动体验而非效率,适合搭建有情感陪伴感的群聊助手。
一站式 MLOps/LLMOps 平台,把实验跟踪、数据管理、流水线编排和模型服务整合在一起,帮团队把 AI 训练与部署流程自动化。
自托管的 AI 数字同事平台,可创建带指令、记忆、例行任务和独立隔离电脑的命名智能体,执行操作前需你批准。
DeepSpeed 官方示例集,提供各类模型接入 DeepSpeed 分布式训练的现成代码,方便照着改自己的训练脚本。
用 Triton 重写 LLM 训练中的 RMSNorm、RoPE、交叉熵等关键算子,减少显存占用并提升微调吞吐,兼容 Llama、Mistral、Gemma、Phi 等主流模型。
基于 Python 的开源离线翻译库,用本地语言模型完成多语种互译,无需联网即可在自有设备上跑机器翻译。
把长期目标拆成可验证结果的本地优先语义控制平面,让多智能体团队跨会话、跨运行时持续协作并追踪研究进展。
Ship AI Agents to Google Cloud in minutes, not months. Production-ready templates with built-in CI/CD, evaluation, and observability.
Open-source context retrieval layer for AI agents
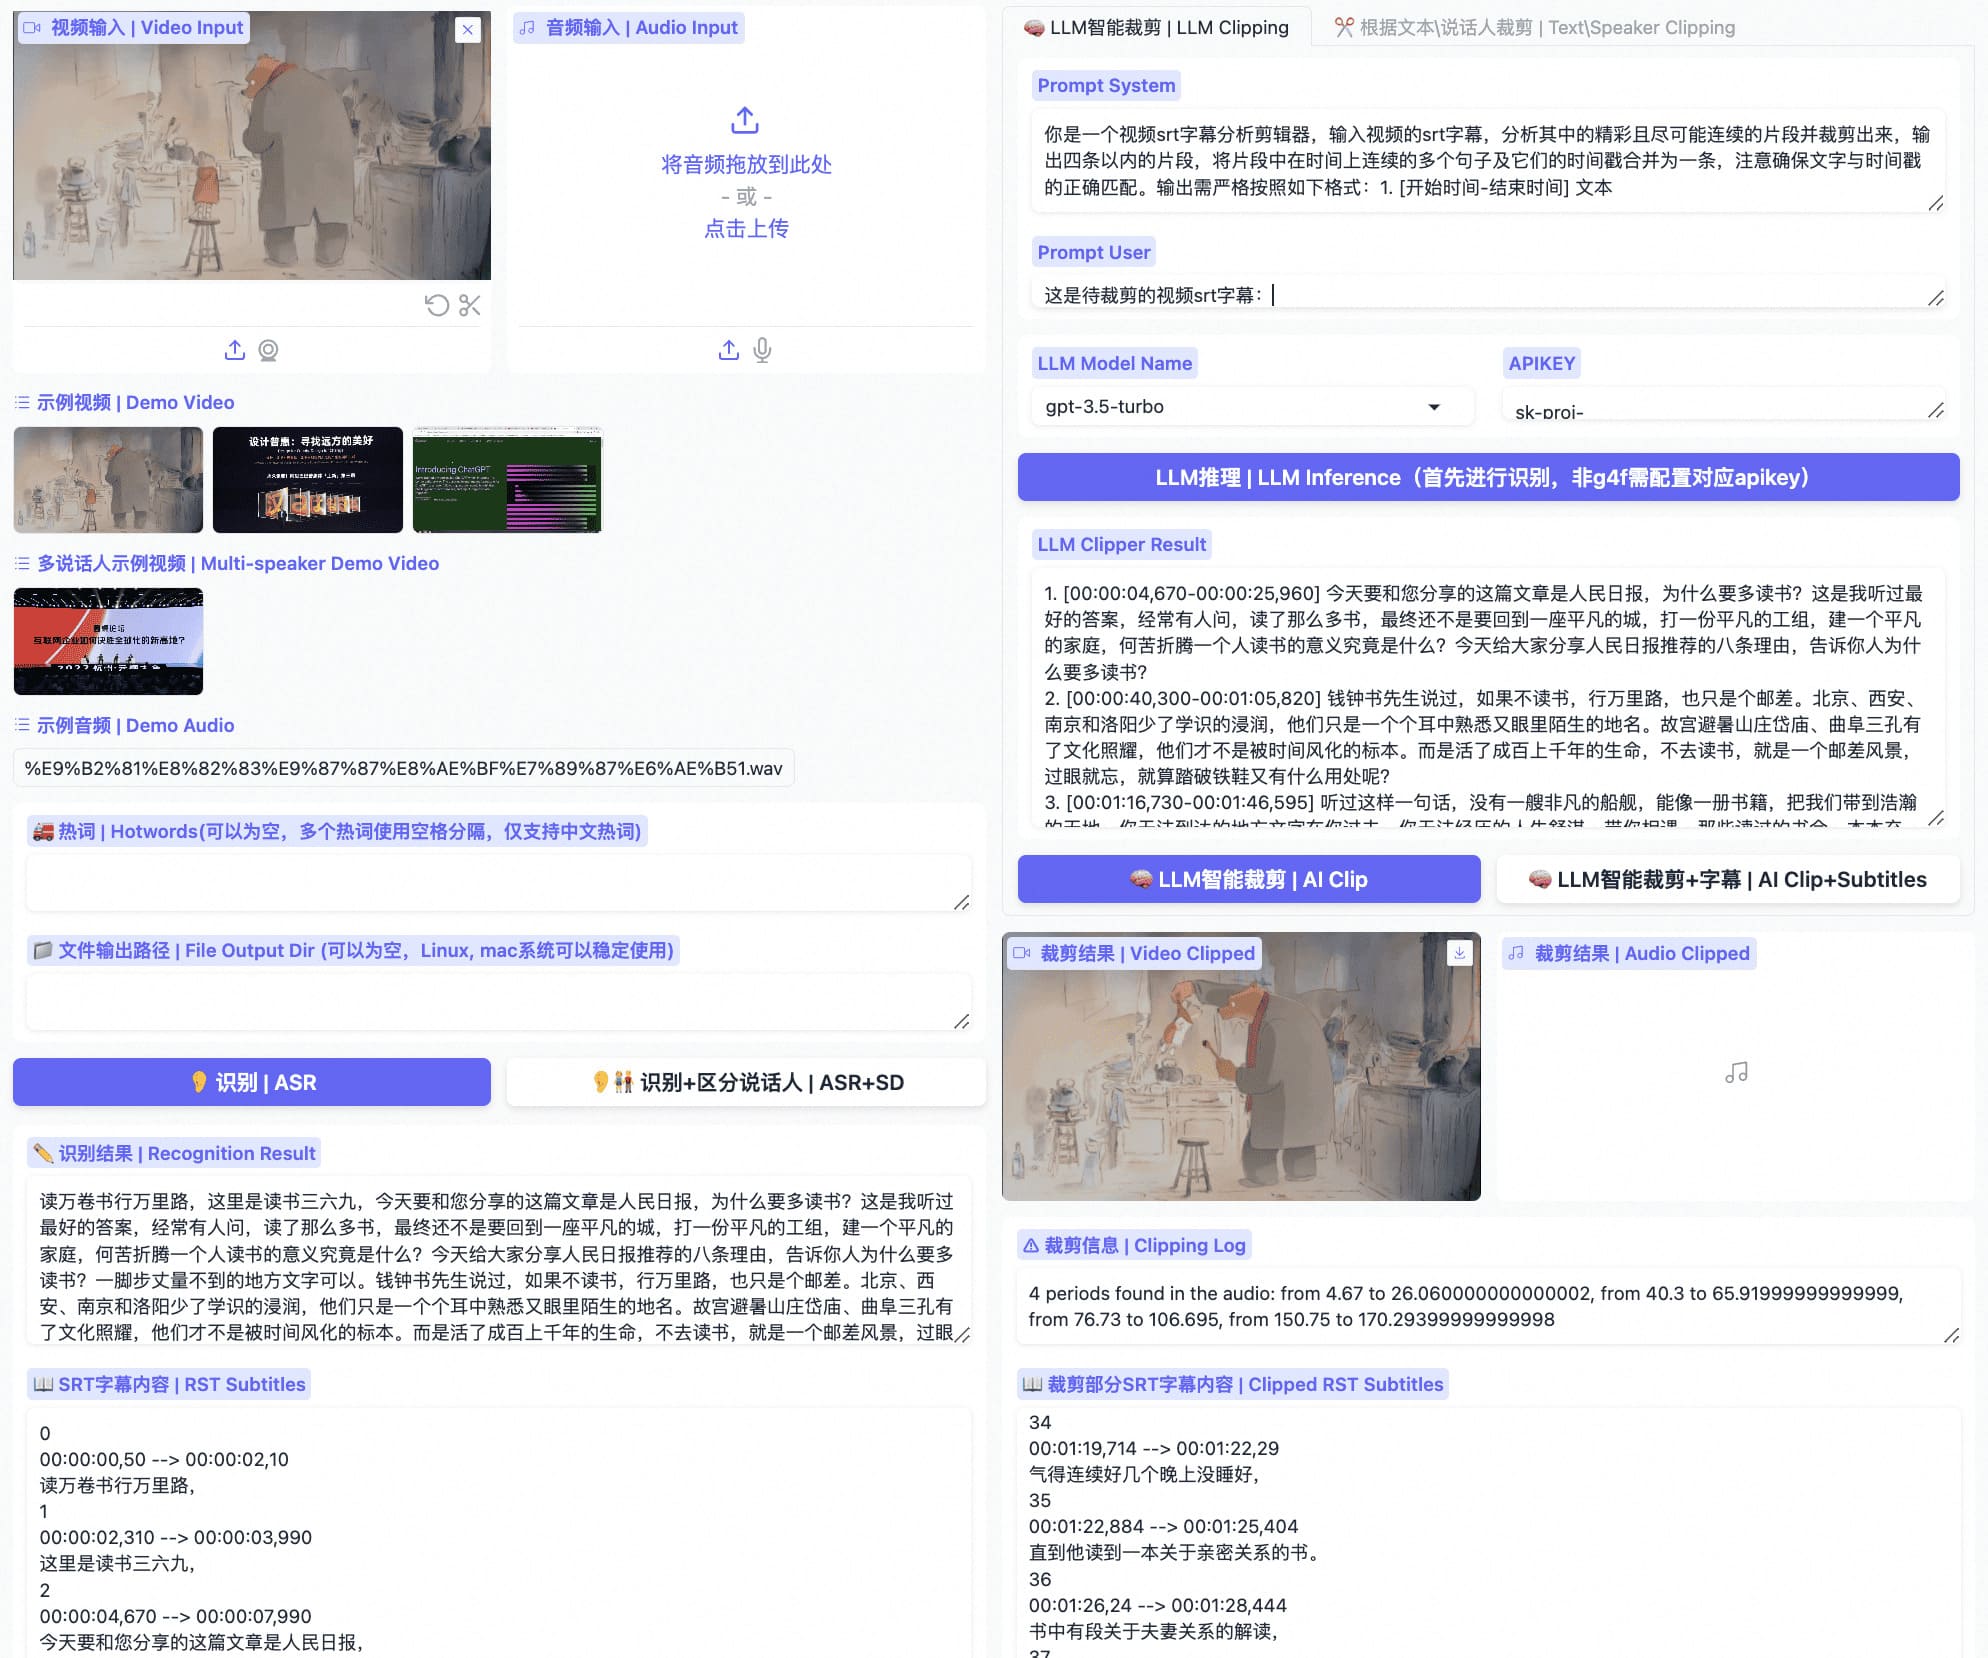
基于 FunASR 的本地视频转写与字幕生成工具,带 Gradio 界面,还能用大模型辅助自动剪辑,适合做中文视频内容创作。