评估 · 实验 · MLOps
共 262 个仓库

面向基础模型训练的多模态数据流水线,把数据清洗、筛选和质量评估串成可扩展流程,解决大规模图文数据难治理的问题。
一套用于压测向量搜索引擎的基准框架,可对比不同向量数据库的检索性能,帮你在选型时拿到实测数据。
一站式 AI 治理与 LLM 评测平台,内置 EU AI Act、ISO 42001、NIST AI RMF 等 20 多个合规框架,帮团队做模型审计、风险评估和合规落地。
一个 OpenAPI 代理,按接口文档实时校验请求和响应,帮你在开发和测试阶段发现契约不一致的问题。
T2I-CompBench 是评估文生图模型组合能力的基准,覆盖属性绑定、物体关系和数量等维度,帮研究者量化模型是否真的画对了提示词。
轻量跨平台的 CPU/GPU 实时监控命令行工具,直接调用厂商 API 获取准确硬件数据,并用 ASCII 图表直观展示。
无需写代码就能浏览和校验表格数据的桌面应用,基于 Frictionless 框架,帮非技术用户快速发现数据质量问题。
用 Python 给 LLM 生成的回答跑评测的 SDK,内置多种评测指标,方便在 LLMOps 流程里量化模型输出质量。
对本地大模型服务做并发压力测试,自动跑多轮请求并生成性能报告,方便对比 Ollama、vLLM 等推理后端的吞吐和延迟表现。
给 SaaS 产品快速嵌入 CSV/Excel 数据导入体验的开源组件,自带字段映射、数据校验和导入前复核,省去从零开发导入流程的几个月工作量。
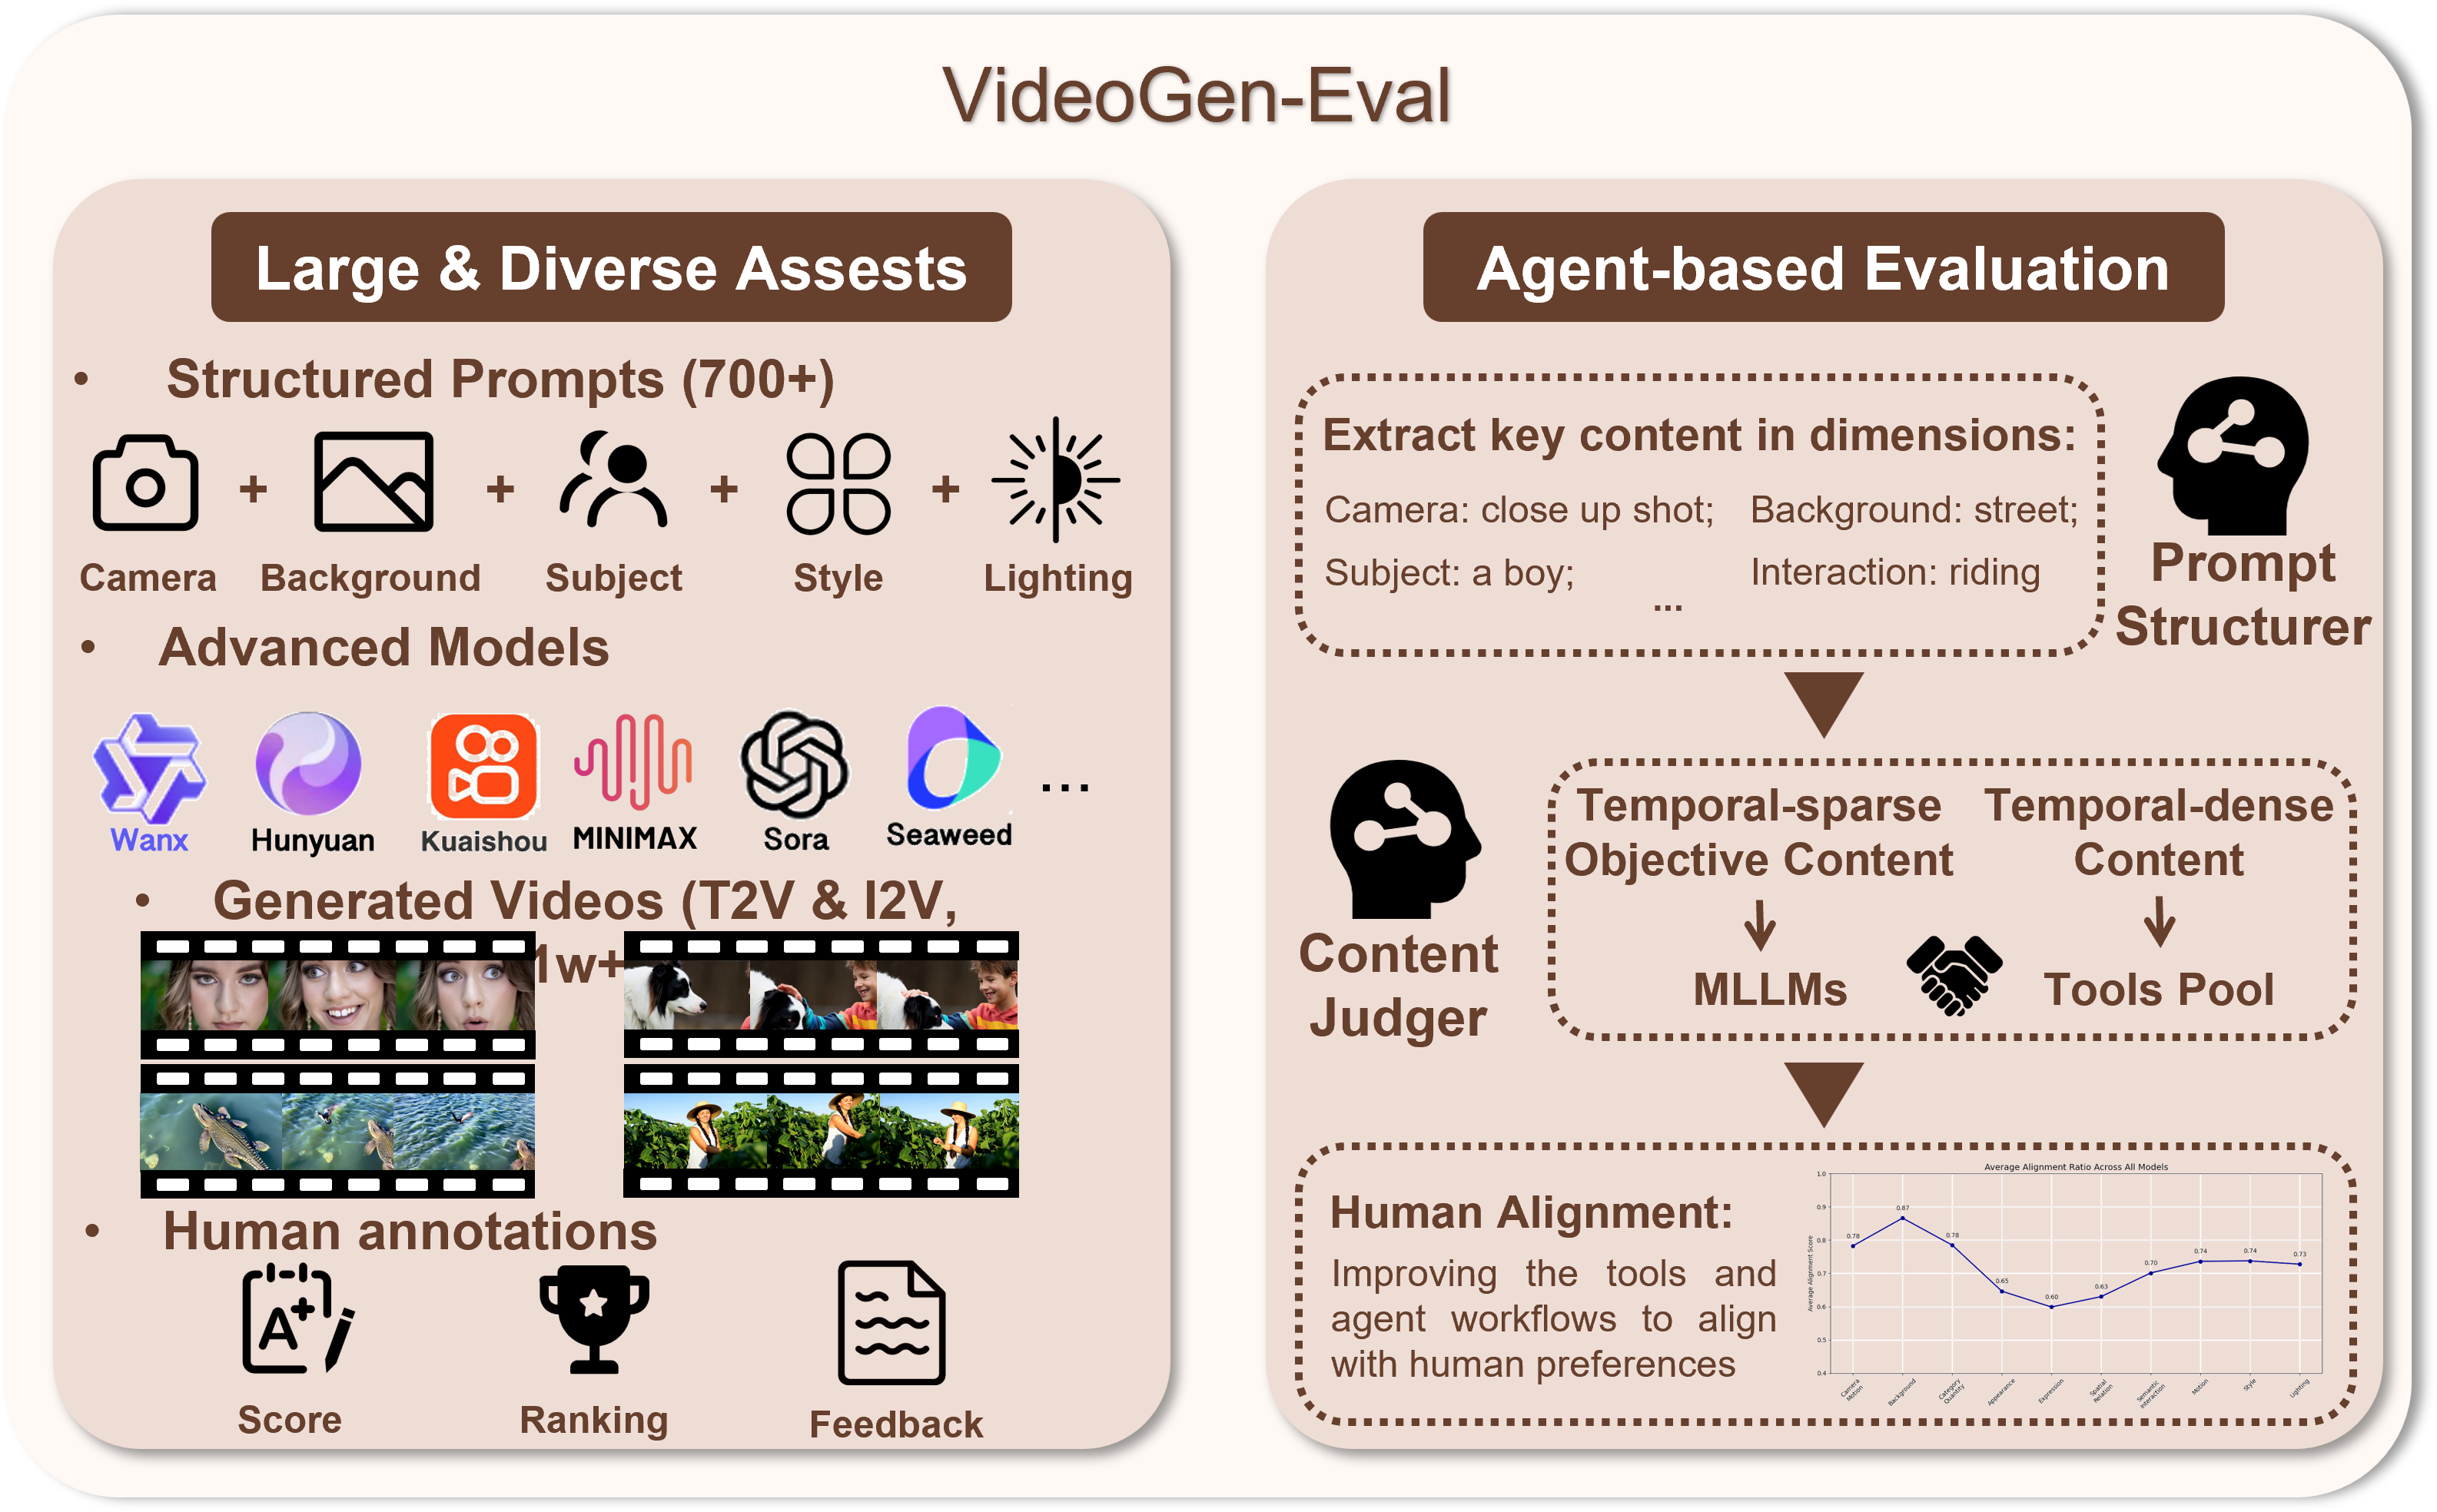
基于智能体的视频生成评测系统,用自动化方式给文生视频、图生视频等模型的生成质量打分,省去人工逐条评估的麻烦。
一套开箱即用的 PyTorch 深度学习项目模板,集成配置管理与实验追踪,支持多 GPU、多节点的大规模分布式训练。
面向多模态游戏智能体的标准化评测基准,提供可验证的评测流程,用来衡量智能体在游戏环境中的真实表现。
面向 ONNX 工作流的无代码命令行工具,能一键完成模型转换、基准测试和本地部署,省去手写脚本的麻烦。
用 Rust 写的 NVIDIA GPU 终端监控面板,能实时查看显存占用和进程,比反复敲 nvidia-smi 更直观高效。
A Clojure machine learning library

OpenS2V-Nexus 是面向主体到视频生成(S2V)的评测基准与百万级数据集,提供评估工具包,用来衡量模型在保持指定主体一致性上的生成效果。
监控机器学习模型上线后的数据漂移,并通过数据校验保障部署安全,自动生成 HTML 报告帮助定位特征分布变化。

轻量级 Web 面板,实时查看多块 GPU 的占用率、显存和温度等状态,方便跑深度学习训练时随时掌握显卡负载。

用 Crystal 写的单二进制 HTTP 压测工具,面向 CI/CD 流水线,提供真实延迟统计、阈值校验和 JSON 输出,方便在流水线里卡性能回归。

ChronoMagic-Bench 是 NeurIPS 2024 提出的文本到延时视频生成评测基准,用变形评估衡量扩散模型生成延时视频的质量。

基于 AtroCore 平台构建的开源 PIM 系统,可灵活配置产品目录、内容与数据校验,适合 B2B 电商和 ERP 集成场景。