推理与服务
共 540 个仓库 · 近 4 个月有推送
微软 Foundry 的示例、文档与加速器合集,用 Jupyter Notebook 演示 Azure OpenAI、ChatGPT、DALL·E、嵌入模型等服务的调用方式。
macOS 上选中文字后弹出操作菜单,可跑自定义脚本、AI 动作和可扩展工作流,把剪贴板与 LLM 调用串起来。
轻量级 AI RSS 阅读器,用大模型自动摘要和筛选订阅内容,可一键部署到 GitHub Pages、Vercel、阿里云 ESA Pages 或 Docker 自托管。
纯 Rust + CUDA 实现的大模型推理引擎,不依赖 PyTorch,兼容 OpenAI 接口,可部署 Qwen3 到 Kimi-K2 等模型。
在 Apple Silicon 上通过 MLX 原生实现 DeepSeek DSpark 与 DFlash 投机解码,让本地大模型推理最高提速 4 倍且无损,兼容 Gemma、Qwen、Nemotron 等模型。
收录围绕 TypeSafe AI 的 System One 模型 Jev 打造的工具清单,方便开发者查找 Jev 的 API、连接器与生产部署方案。
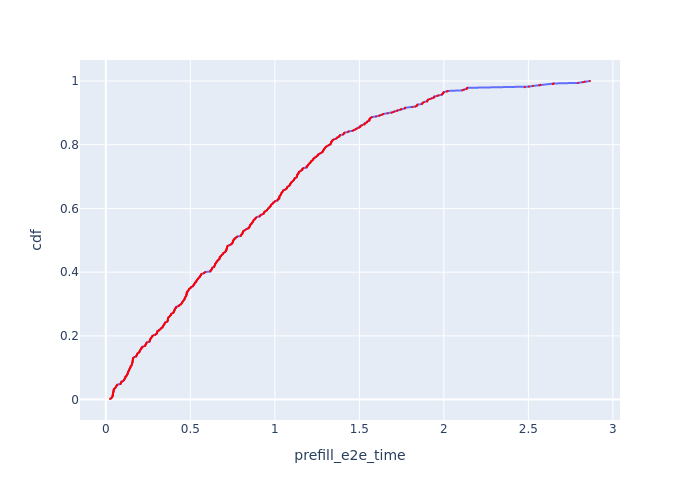
面向 LLM 推理系统的可扩展仿真器,能在不实际部署集群的情况下,大规模、高精度地模拟 Transformer 推理性能,用于容量规划与架构选型。

纯 Rust 实现的大模型推理引擎,支持 Transformer、Mamba/SSM、投机解码和 NVFP4 量化,兼容 OpenAI API,适合在 DGX 等硬件上部署高效推理服务。
用 Rust 写的引擎无关 LLM 网关,统一兼容 OpenAI 与 Anthropic 接口,把 vLLM、SGLang、Gemini 等后端接到同一入口,并支持 KV 缓存感知路由和 gRPC 流水线。
统一序列并行注意力实现,把 Ulysses 和 Ring Attention 混合成 2D 并行,让长上下文 Transformer 训练和推理能扩展到超长序列。
用 Whisper 把音频转成文字,再调用 GPT、Claude 等大模型翻译润色,直接输出 LRC 字幕文件,省去手动打轴和翻译的麻烦。
跨平台开源语音输入工具,按下热键自然说话,就能在任意应用中直接得到润色后的文字,省去手动打字。
开源的自动化代码审查工具,在 Code-Review-Bench 上排名第一,用 LLM 智能体自动审查 Pull Request 并给出评审意见。
在 16–64 GB 内存的 Apple Silicon Mac 上,从 SSD 流式加载 105 GB 的 4-bit 大模型跑推理,纯 Swift + MLX/Metal 实现,离线无需 Python。
围绕预训练权重做黑盒优化与神经进化,用 LoRA 集成多个任务专家,提升大模型后训练与推理表现。
让 Flutter 应用在手机、桌面和 Web 上直接跑 Gemma 等大模型,支持多模态、函数调用、向量嵌入、RAG 和语音,不用依赖云端。
统一接入 44 家模型厂商的 AI 网关,实时监控本机各编码代理的调用行为,并给 API 做 A–F 真实性评级,防止用错或被盗用。
Lynkr 是一个命令行 HTTP 代理,把 Claude Code CLI 包装成统一入口,让编辑器、Agent 等工具更顺畅地调用代码生成能力。
面向 LLM Agent 的推理与服务方案,帮助把大模型智能体能力落地到实际应用流程中。
用 Cython 加速 fastText 和 gensim 模型计算句向量,比原生 Python 实现快一个数量级,适合需要批量生成句向量做相似度检索的场景。

把安卓手机变成兼容 OpenAI 接口的本地大模型推理服务器,数据不出设备,可接入 Home Assistant 等应用。

把 Hugging Face 的 Transformers、Diffusers 等模型接到 Intel 的 OpenVINO 等优化工具上,加速 CPU/GPU 推理,覆盖 LLM、语音识别、语音合成和多模态模型。

在瑞芯微 NPU 上跑大模型的推理服务,类似 Ollama 的替代方案,通过优化 rkllm 让 Orange Pi 等设备高效离线运行 AI 模型。
把长视频自动切成镜头、用多模态模型看画面写解说词、再配音合成成片,还能一键导出可编辑的剪映/CapCut 草稿,全程不用 GPU。