推理与服务
共 540 个仓库 · 近 4 个月有推送
汇总检索增强生成(RAG)方向的资料清单,帮大模型开发者快速找到相关技术与实现方案。

给 AI Agent 加上屏幕录制与记忆检索能力,让它能回看你的历史操作并真正记住个人上下文,从而做出更贴合你的回应。

用大模型批量模拟受访者来做问卷调查和市场研究,设计实验并分析结果,省去招募真实被试的成本。

开源 AIaaS 平台,统一接入 Ollama、vLLM 等本地与公有 LLM,提供嵌入管理、RAG、图像音频生成和可视化编排。
基于深度学习与 NVIDIA GPU 加速的 3D 物体位姿估计 ROS/ROS2 包,可在 Jetson 上通过 TensorRT 推理,为机器人抓取和操作提供实时六自由度位姿。
把视频按场景切成 9-16 格带时间戳和字幕的分镜图,连同音频包络压成一张 384 token 的图片,方便大模型低成本理解长视频。

一款 AI 原生的自托管 RSS 阅读器,用大模型帮你筛选和总结订阅内容,解决信息过载、看不过来的问题。
基于 Claude 的自托管自主 AI 开发团队机器人,接入 Telegram 和 VK,自动完成代码审查与开发任务。
把想法和素材交给 AI 导演智能体,自动生成生动的讲解视频,支持本地优先运行并自由接入任意模型。
基于 Qwen3.6-27B 做去审查与能力增强的 abliteration 模型,配合 NVFP4 量化和 DFlash 投机解码,在 DGX Spark 上优化长上下文草稿接受率,附多种 HF 变体与 Docker 部署。
用 C++ 复刻 vLLM 的推理引擎,支持连续批处理、分页 KV 缓存,并额外提供 GGUF 加载、RadixAttention 和缓存感知调度,适合想在 C++ 环境跑大模型推理的场景。
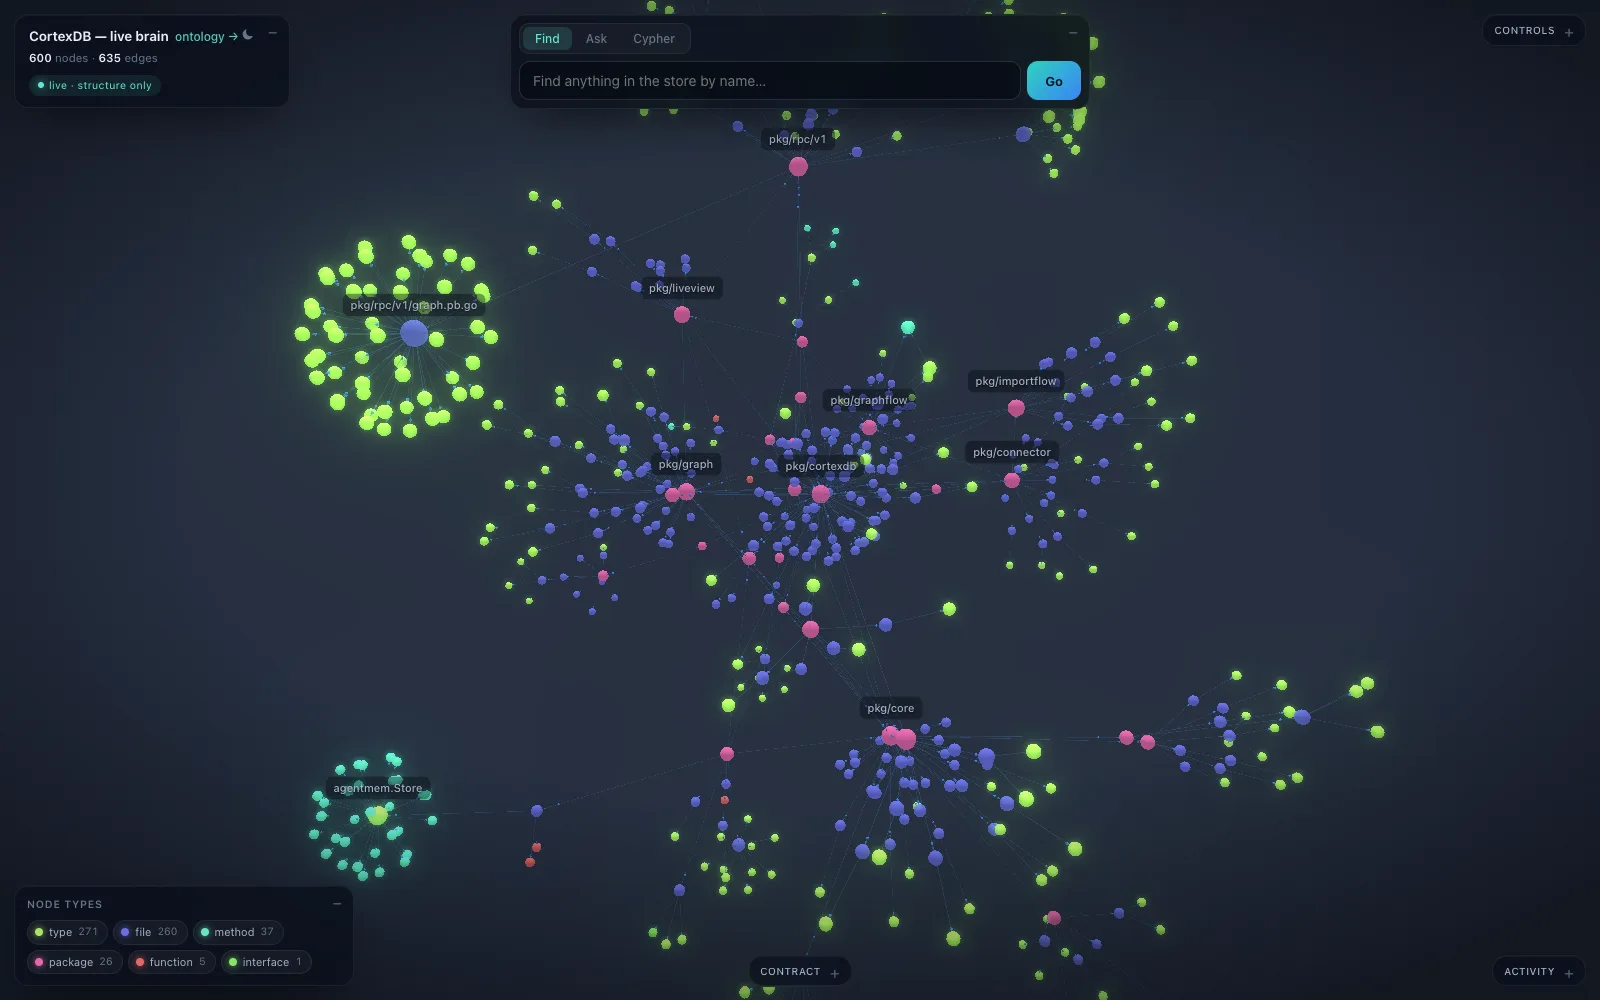
把 AI 智能体的记忆全部存进单个 SQLite 文件,内置知识图谱、本体约束和可追溯推理,让本地优先的记忆管理不再依赖外部服务。
高通 AI Hub 应用集,提供针对高通设备优化过延迟和内存的机器学习模型,可直接部署到骁龙等终端上跑推理。
基于 vLLM 的 NUMA 扩展推理引擎,充分利用 CPU 和内存资源降低显存占用,支持 MOE 大模型混合推理与 GPU/NUMA 并行。
基于 vLLM 的 Runpod 无服务器 worker 模板,用于快速部署大语言模型推理端点,省去自己搭建服务的工作。
用嵌入向量做 GitHub 仓库推荐,并生成更清晰的 Star 历史图表,帮开发者发现值得关注的项目。

用 Rust 写的开源 AI 网关,单二进制自带控制台,统一路由、鉴权、预算和观测 OpenAI、Anthropic、Gemini、Bedrock 等各家 LLM 调用。
面向 iPad 和 iPhone 的开源端侧 AI 智能体工作台,在设备本地跑 Linux、终端、Python/Node.js、Git 和 3D/CAD 编辑,支持自带密钥接入大模型。
给 OpenAI 请求加一层隐私代理,自动检测并脱敏提示词中的 PII 等敏感信息,让调用大模型时不泄露用户数据。
面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。

自托管的 AI 网关与推理防火墙,为 Agent 提供身份与访问管理,拦截提示注入并审计调用,防止 LLM 被滥用。

自托管的 AI API 网关,把 Claude Code、Codex、Gemini 的 API Key 和订阅账号汇到一个端点,统一做故障转移、协议转换和成本统计。
面向 Redis 的 AI 原生 Python 客户端,把向量检索、缓存和 RAG 所需的数据操作封装成简单接口,省去自己拼装底层命令。
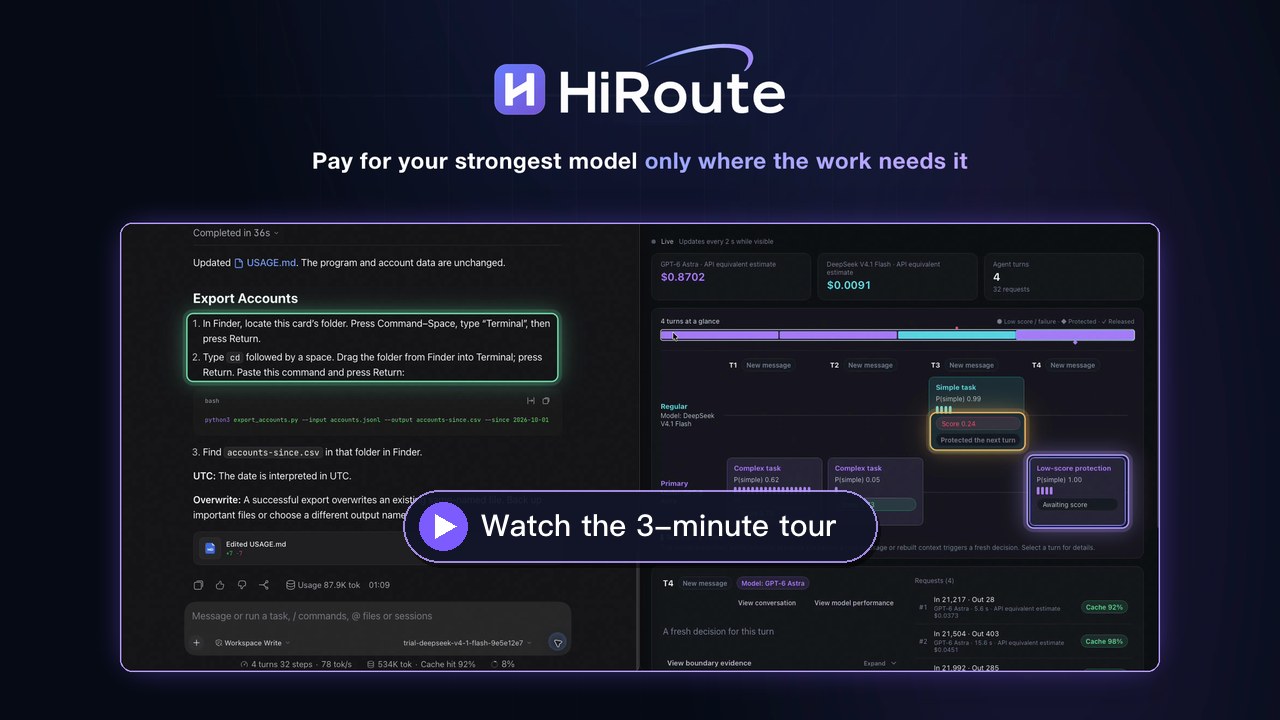
本地模型路由器,把日常 agent 任务分给便宜模型,难题留给最强模型,让 Codex 和 Claude Code 订阅更耐用、更省钱。