推理与服务
共 679 个仓库 · 一年内有推送
汇总 Prompt 与 LLM 相关论文、开源数据和模型,并整理 AIGC 应用案例,方便快速跟进提示工程与大模型研究进展。
系统梳理 GPU 架构、CUDA 编程、大模型基础与 AI Agent 的入门知识库,帮开发者补齐 AI 基础设施底层原理。
面向大型代码库的本地私有智能分析引擎,支持混合语义搜索、多语言依赖图、符号级影响分析和调用链追踪,可作为 MCP 或编辑器插件零配置接入,帮 AI 编程助手大幅减少 token 消耗和调用次数。
把 OpenAI Whisper 封装成开箱即用的 Docker 语音识别 Web 服务,上传音频即可通过 API 拿到转写文本,省去自己搭推理服务的麻烦。
用 LLM 驱动的网页抓取工具,支持 OpenAI、Gemini 和 Ollama,能按自然语言指令从网页中提取结构化数据,省去手写解析规则。
轻量级 Python 向量化库,无需 API 调用即可在本地快速生成高质量文本嵌入,适合 RAG 和向量检索场景。

面向开发者的开源 LLMOps 平台,把提示词设计、版本管理、即时下发、团队协作和可观测性串成一条流水线,省去自己拼凑工具的成本。
用 Rust 写的高性能 AI 模型推理引擎,支持 LLM 和语音合成,并针对 Metal 做加速,适合在本地或服务端跑模型推理。

本地运行的开源 AI 会议助手与面试副驾,提供实时转写、会议笔记、讲座录音和本地 RAG,支持自带密钥,无需订阅。

Ruby 生态里调用 OpenAI API 的客户端库,封装 GPT-5、Realtime WebRTC、Whisper、DALL·E 等接口,让 Rails 项目直接接入对话、语音和图像能力。
把 PDF、Word、PPTX 等文档和图片通过 OCR 加 Ollama 模型解析成结构化 JSON 或 Markdown,还能自动匿名化、清除 PII 敏感信息。
Skywork-R1V 是昆仑万维开源的多模态视觉语言推理模型系列,基于强化学习训练,擅长图像理解与复杂推理任务。
用 Rust 写的便携式 SQL 查询、搜索与 LLM 推理引擎,给业务数据库加一个实时分析节点,让 AI 应用和智能体直接基于数据做推理。

macOS 上的本地语音听写应用,基于 Whisper 和 Parakeet 模型把语音实时转成文字,适合想要离线、隐私友好的语音输入用户。
自托管的本地语音助手,对标 Amazon Echo 和 Google Home,用 ESP32 硬件加语音识别在本地完成唤醒与语音转文字,数据不出户,适合注重隐私的智能家居场景。

把家里的多台设备连成集群来跑 LLM 推理,设备越多推理越快,用 C++ 实现分布式加速。
用容器方式在本地跑 AI 模型推理的开发工具,屏蔽不同模型来源和硬件差异,一条命令就能起服务并用于生产。
本地运行的语音转文字工具,带网页界面,用 Whisper 模型把任意音频转成文本,还能翻译和编辑字幕,全程数据不出本机。
面向大模型推理与 GPU 训练的高性能存储引擎,用 Rust 编写,通过 RDMA 等技术提升模型加载和服务吞吐。
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
一套用来测试和实验提示词的开源工具,支持 OpenAI、LLaMA 等大模型以及 Chroma、Weaviate 等向量数据库,方便对比不同提示词的效果。
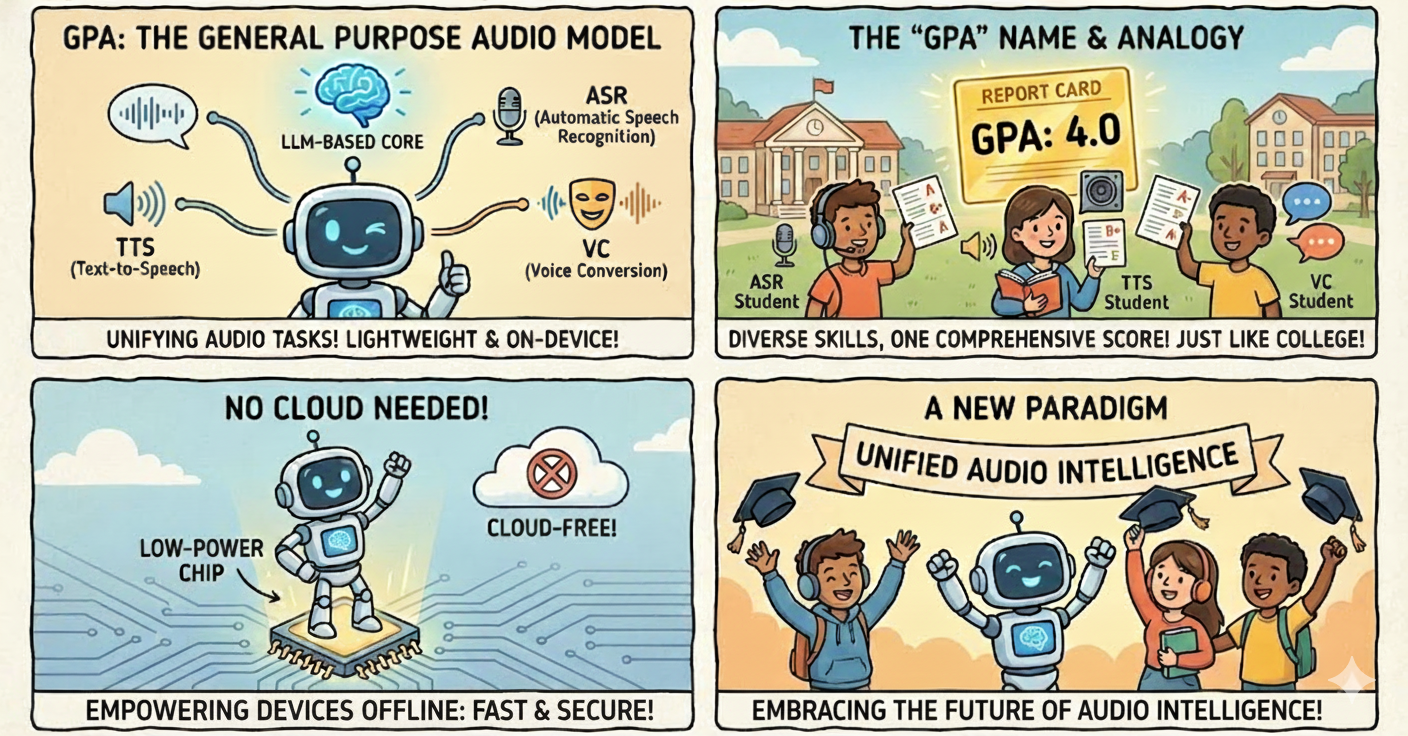
一个超小型的通用音频模型,用同一套权重同时完成语音识别、语音合成和音色转换,省去为每种任务单独部署模型。

Pinecone 官方示例仓库,用 Jupyter Notebook 演示向量数据库的建库、检索和 RAG 语义搜索流程,适合快速上手实践。
PyTorch 官方的量化与稀疏化工具库,支持训练和推理阶段的低精度计算,覆盖 float8、MX 等数据类型,可加速 Transformer 和 Llama 等大模型。