推理与服务
共 679 个仓库 · 一年内有推送
一个语音聊天应用,把语音识别、大模型对话和语音合成串成完整链路,跑在 Modal 无服务器平台上,适合快速搭建可对话的语音助手原型。
轻量级 Python RAG 工具包,用 DuckDB 或 PostgreSQL 就能搭起检索增强生成,省去部署向量数据库的麻烦。
用 C++ 和 CUDA 手写一个高性能 LLM 推理引擎的教学项目,是 vLLM 的精简版,涵盖 PagedAttention 和连续批处理等核心机制。
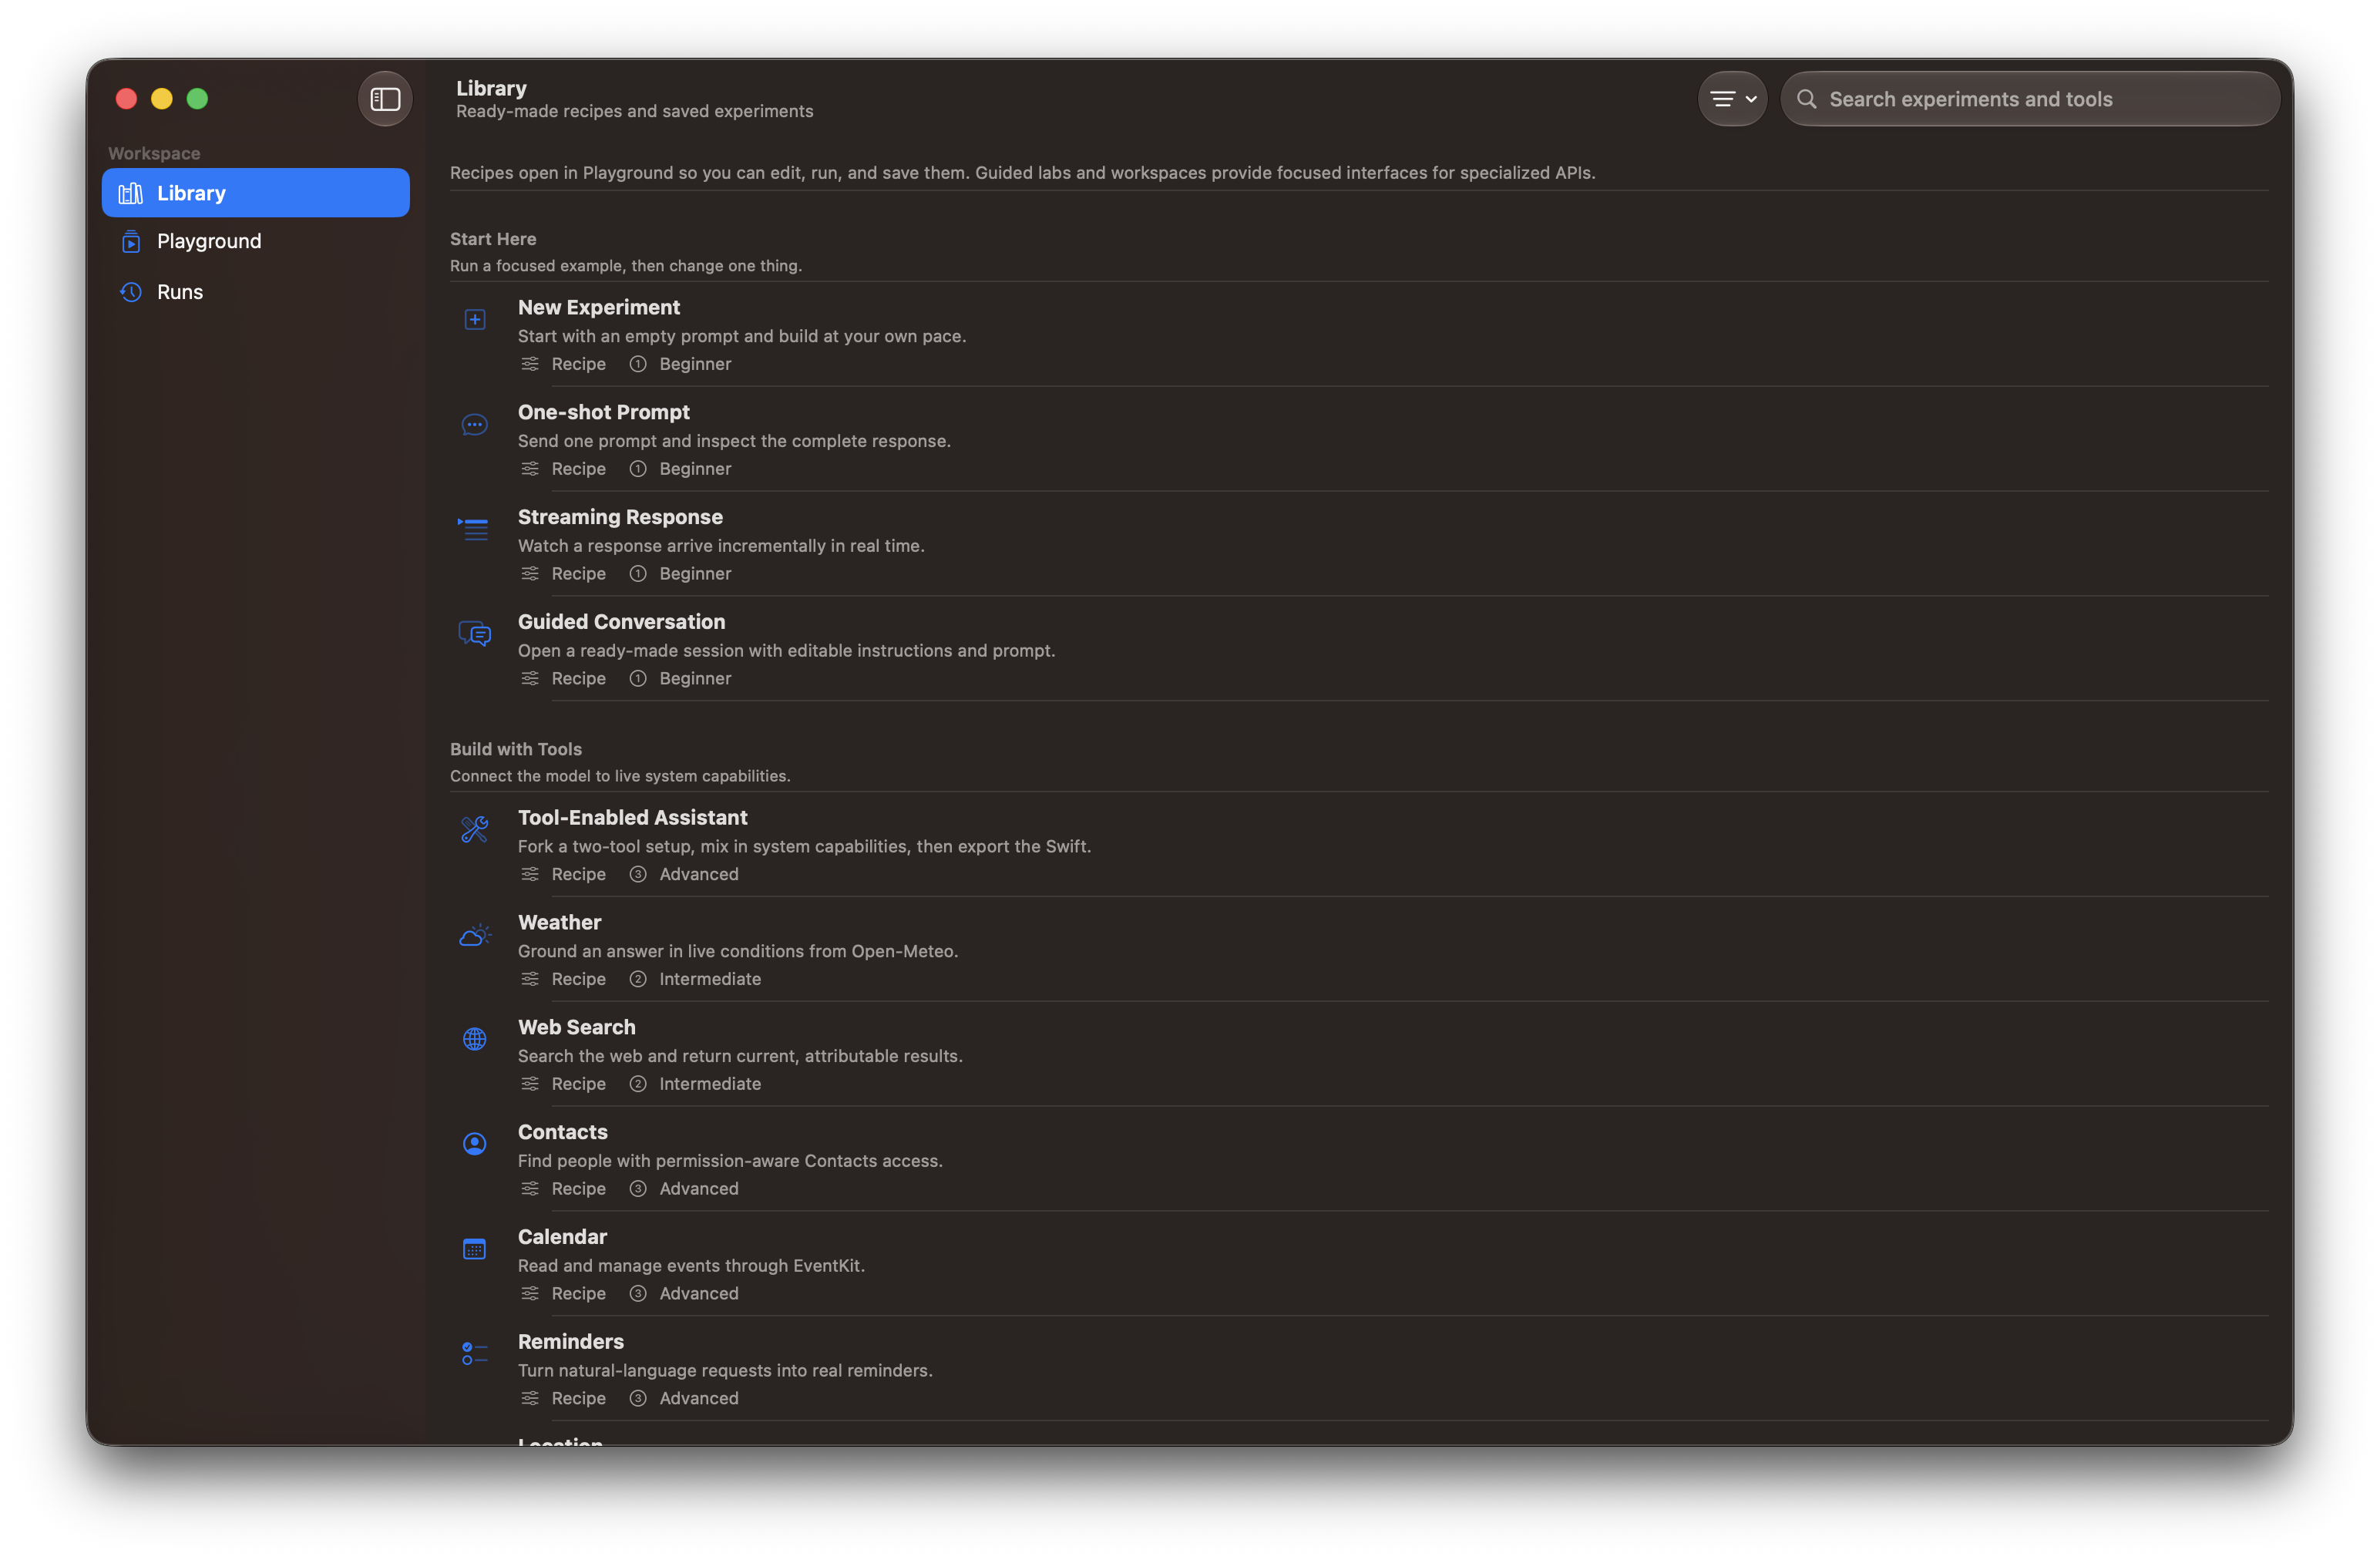
面向 Apple Foundation Models 框架的实战实验场,帮你在 iOS 和 macOS 上动手搭建、测试并评估端侧大模型应用。
截屏后调用大模型识别并解答屏幕内容,代码报错、题目图表、外文资料框选即得答案,常驻后台可当面试或刷题助手。
离线运行的俄语语音助手,通过插件机制扩展技能,适合在无网络环境下做语音交互和自定义语音指令开发。
用 USB-C 把 iPhone 接到 Mac 上,让手机参与跑 27B 大模型,加快提示词读取并扩展上下文,适合本地推理场景。
面向技术面试的开源 AI 助手,提供隐形悬浮窗、实时答题辅助和题目截图识别,支持多语言且可完全自定义、注重隐私。
用低代码方式简化和流式化提示词设计,让开发者和非技术用户都能更轻松地编写、调优大模型提示词。
面向语音与多模态机器学习的 Python 数据处理库,提供统一的音频加载、切分、特征提取和数据集管理接口,方便搭建语音识别等训练流水线。
给 AI Agent 用的开源语义搜索工具,用 ColBERT 向量嵌入替代关键词匹配,让 Agent 按语义而非字面检索本地内容。
用 Go 实现的远程桌面网关,可在 Linux、BSD 或 Kubernetes 上部署,为 RDP 连接提供统一入口和转发。
一套 Obsidian 笔记库起步模板,预置了 LLM 辅助、网页剪藏和卡片盒笔记法的目录与配置,省去从零搭建个人知识库的麻烦。
统一 RAG 检索环节的微调工具,覆盖 Embedding、ColBERT 和 ReRanker 三类模型,省去分别搭训练流程的麻烦。
Conformer 的 PyTorch 非官方实现,把卷积和 Transformer 结合起来做语音识别,适合直接拿来训练或复现 ASR 模型。

用 Python 搭建的 AI 虚拟主播,把语音识别、大模型对话和语音合成串起来,让虚拟形象能在 YouTube 或 Twitch 直播中实时回应观众。

开源的 iOS 语音转文字应用,基于 Whisper 模型在手机本地完成高质量转录,让移动端离线转写更易用。
从基础原理出发系统讲解嵌入(embeddings)的深度教程,用 Jupyter Notebook 带你理解向量表示是怎么算出来、怎么用的。
把电子表格变成 AI 流水线:在单元格里串联提示词和模型,实时对比 LLM 输出,多人协作迭代 AI 应用。
把文本生成 CAD 模型拆成多个智能体协作完成,通过约束式测试时计算提升生成质量,适合机械设计与 3D 打印场景。
Go 语言的可嵌入向量数据库,接口类似 Chroma,零第三方依赖,内存存储并可选持久化,方便在 Go 应用里直接做向量检索和 RAG。

面向智能体和 LLM 应用的编排框架,把 RAG、工具调用和多步推理流程串起来,方便搭建和运维生成式 AI 应用。
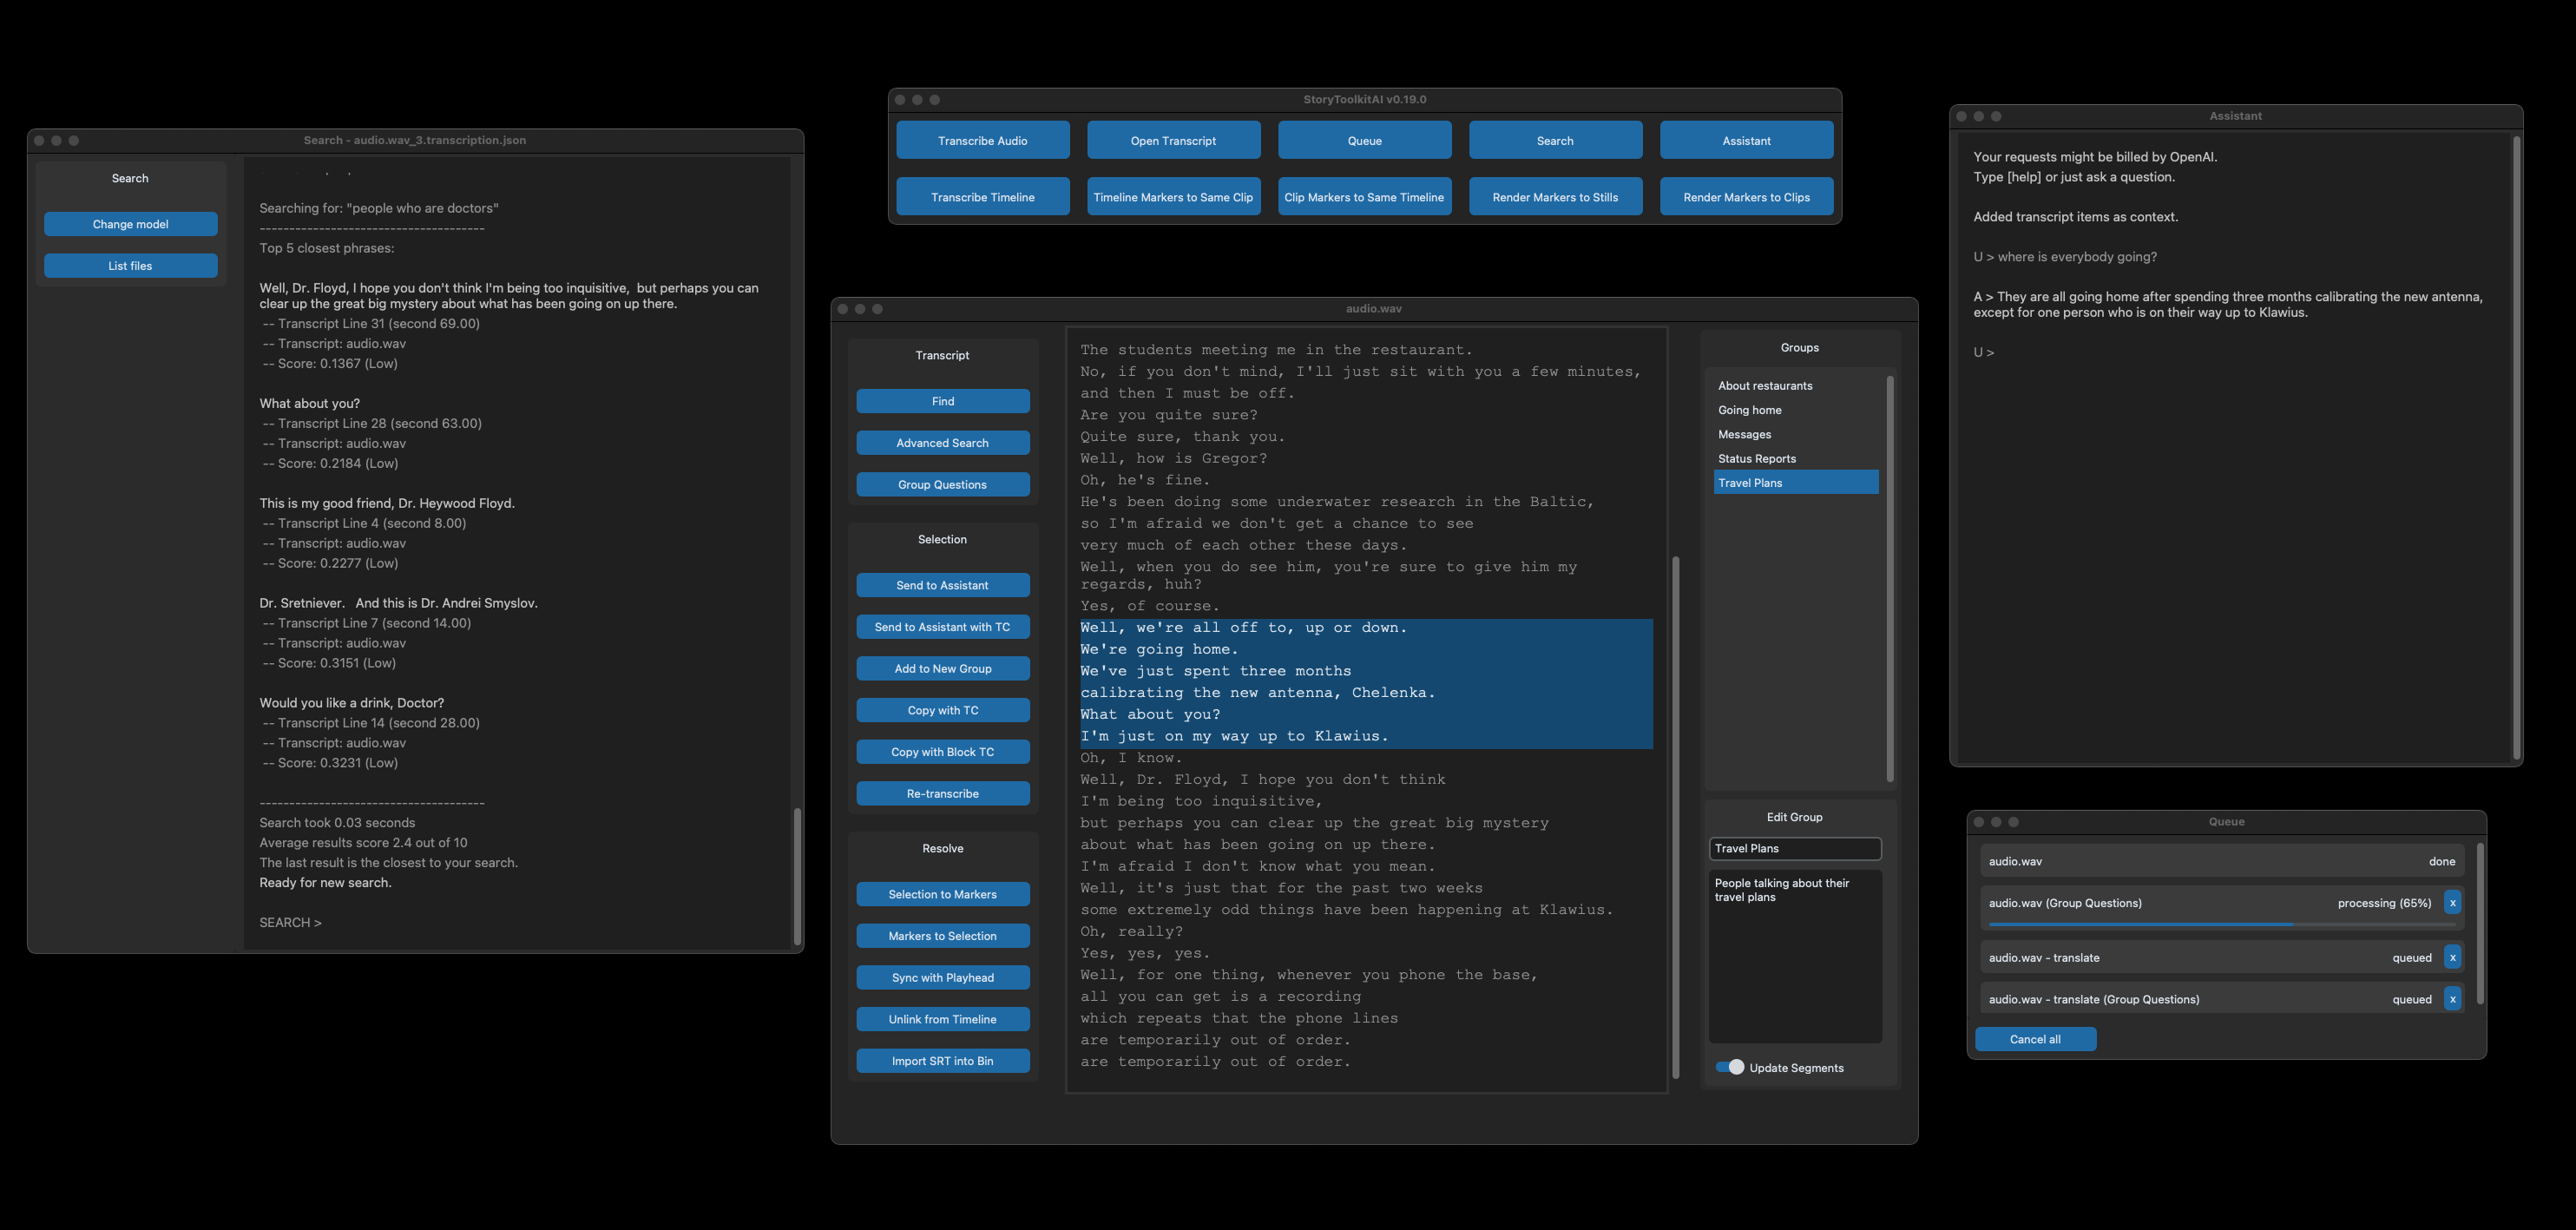
用 AI 给视频素材做转录、内容理解和全文检索的剪辑辅助工具,可接入 ChatGPT 等模型,并与 DaVinci Resolve 集成。
在 Node.js/TypeScript 里通过 ONNX Runtime 本地跑 Laya 这个兼容 Jev 的开源 System-1 决策模型,做分类和推理,不用依赖云端。