推理与服务
共 679 个仓库 · 一年内有推送
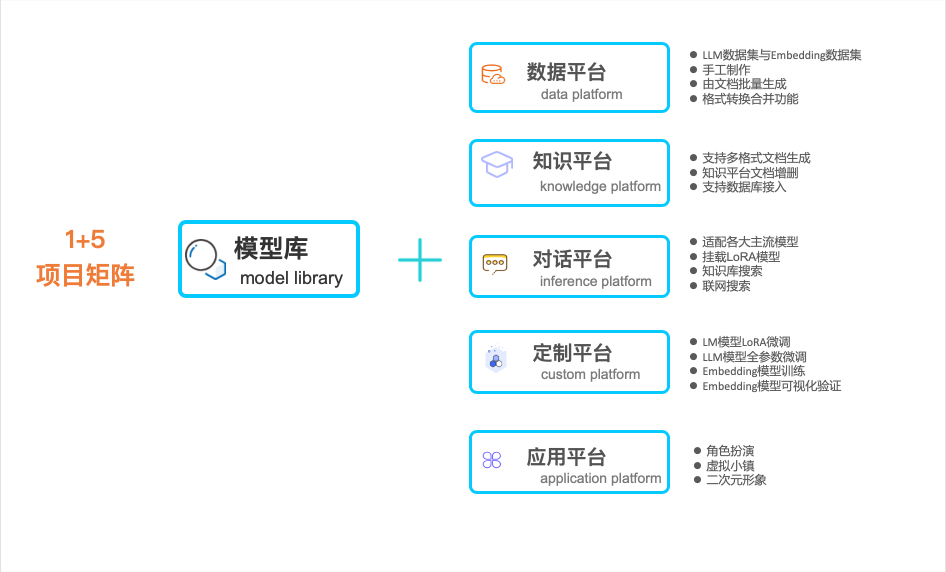
把主流大模型 API 和开源模型统一到一个 WebUI 里,覆盖知识库、数据库、角色扮演、文生图、LoRA 微调、数据集制作等全流程工具。
本地 AI 网关,把各家订阅和 API 服务商统一到一个入口,靠智能路由分发请求,并在设备端做隐私保护。
给 vLLM 推理服务器套上现代化 Web 界面,方便管理和对话,兼容 GPU/CPU,并针对 macOS Apple Silicon 与 OpenShift/Kubernetes 部署做了优化。
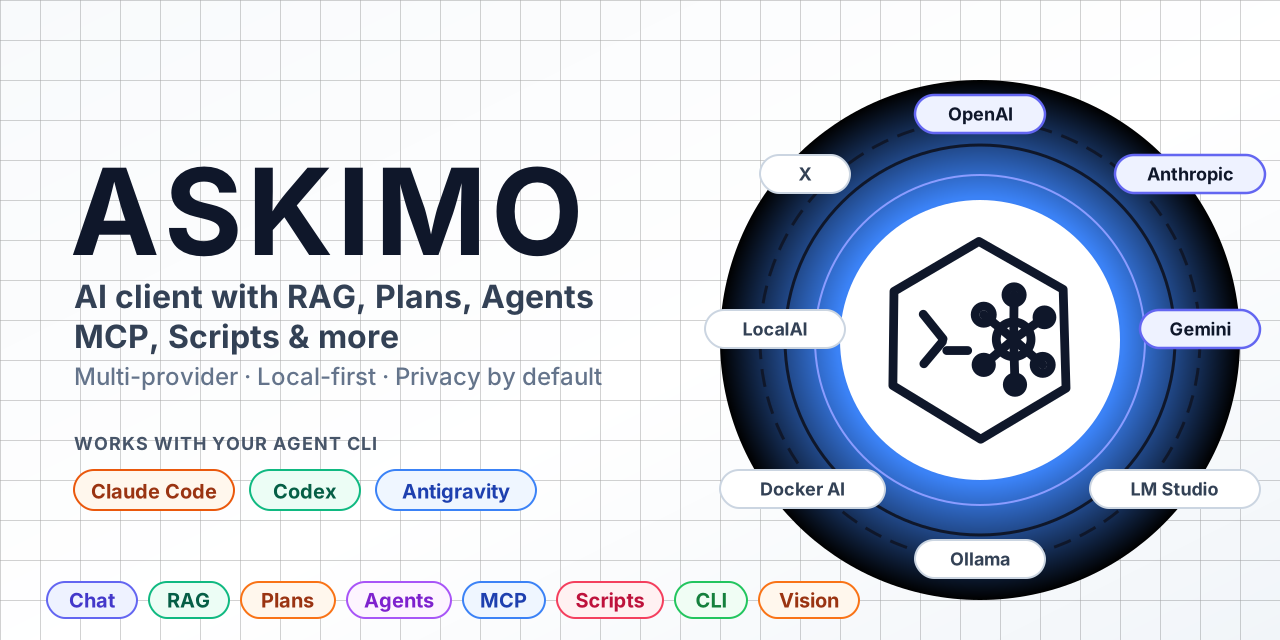
一款桌面端 AI 客户端,把多模型对话、RAG 检索、Skills 技能、MCP 工具调用和 Agent 编排整合到一个应用里,适合想统一管理各家 LLM 的用户。
在浏览器里交互式探索和解读大规模嵌入向量,用可视化方式直观理解高维数据的分布与结构。
用 GPT 嵌入和向量检索引擎处理海量公开情报数据,把零散 OSINT 信息变成可语义搜索的知识库。
用 Rust 实现的高性能 GraphRAG 引擎,从文档中抽取实体构建知识图谱,支持可配置实体抽取和本地 LLM 接入,实现自然语言问答。
面向大语言模型的低延迟、高吞吐推理服务引擎,基于 PyTorch 和 Transformer 架构,适合部署 Llama 等模型对外提供在线推理服务。
已归档的历史仓库,原用于向量检索与向量数据库的教程和工具集;团队现已转向自托管推理引擎 SIE,覆盖嵌入、重排、OCR 与文档处理。
基于 LangGraph 的电商数仓智能问数 Agent,把自然语言转成 SQL 并流式展示查询结果,配套教程适合系统学习大模型应用落地。
Krasis 是一个混合式 LLM 推理运行时,通过 CPU+GPU 协同把大模型跑在显存有限的消费级显卡上,支持 MoE 和 GGUF 模型。
基于 Kubernetes Operator 的大模型推理部署引擎,统一管理 GPU 调度与模型生命周期,兼容 SGLang、vLLM、TensorRT-LLM 和 Triton 等主流推理后端。
汇总自动驾驶领域的视觉-语言-动作(VLA)模型资源,梳理其发展脉络与未来方向,方便快速了解该方向的研究与落地进展。
汇总检索增强生成(RAG)方向的资料清单,帮大模型开发者快速找到相关技术与实现方案。

给 AI Agent 加上屏幕录制与记忆检索能力,让它能回看你的历史操作并真正记住个人上下文,从而做出更贴合你的回应。

用大模型批量模拟受访者来做问卷调查和市场研究,设计实验并分析结果,省去招募真实被试的成本。

开源 AIaaS 平台,统一接入 Ollama、vLLM 等本地与公有 LLM,提供嵌入管理、RAG、图像音频生成和可视化编排。
把视频按场景切成 9-16 格带时间戳和字幕的分镜图,连同音频包络压成一张 384 token 的图片,方便大模型低成本理解长视频。
基于深度学习与 NVIDIA GPU 加速的 3D 物体位姿估计 ROS/ROS2 包,可在 Jetson 上通过 TensorRT 推理,为机器人抓取和操作提供实时六自由度位姿。
给 vLLM 加一个免校准的 KV-cache 量化后端,只需一个开关就能把上下文拉长 3~5 倍,吞吐超过 FP16 且精度基本不掉,适合跑长上下文 Agent。
基于 pgvector 和 Supabase 的文档问答 MVP,上传文件后即可安全地与之对话,快速搭建 RAG 应用。
用命令行一键启动 vLLM 的 LLM 推理服务,省去手写配置和启动脚本的麻烦,适合快速部署和测试模型。

一款 AI 原生的自托管 RSS 阅读器,用大模型帮你筛选和总结订阅内容,解决信息过载、看不过来的问题。
把智能魔镜变成可自托管的私人语音助手,本地跑 LLM 推理,支持树莓派部署,无需依赖云端服务。