推理与服务
共 48 个仓库 · Rust
基于 Tauri 和 Rust 的轻量级跨平台 AI 桌面客户端,集对话、Agent 与 AI 网关于一体,统一接入和管理多个模型服务。
把电脑播放或麦克风采集的声音实时转成翻译字幕,跨平台桌面应用,适合看外语视频、开会时即时理解内容。
自托管的 AI API 与 MCP 网关,给企业统一管控大模型调用:SSO/RBAC、按用户身份鉴权、PII 脱敏、工具调用防护、限流预算与成本审计。
用 Rust 写的 RDNA 原生大模型推理引擎,直接跑在 AMD GPU 上,让 RDNA 显卡也能高效做 LLM 推理和量化。
用 Rust 写的高性能 RAG 与 LLM 应用框架,支持流式索引、检索和智能体编排,适合构建低延迟的检索增强生成服务。
用 Rust 把 SQL 当函数调用的嵌入式数据库,自带类型安全 ORM,存储层可插拔 LMDB 或 RocksDB,适合在应用内直接做 OLTP 查询。
用 Rust 写的代码智能 CLI,为 AI 编程助手构建调用图和混合语义检索索引,支持 7 种语言,并以原生 MCP 工具接入 Claude Code 和 Codex CLI。
纯 Rust + CUDA 实现的大模型推理引擎,不依赖 PyTorch,兼容 OpenAI 接口,可部署 Qwen3 到 Kimi-K2 等模型。

纯 Rust 实现的大模型推理引擎,支持 Transformer、Mamba/SSM、投机解码和 NVFP4 量化,兼容 OpenAI API,适合在 DGX 等硬件上部署高效推理服务。
用 Rust 写的引擎无关 LLM 网关,统一兼容 OpenAI 与 Anthropic 接口,把 vLLM、SGLang、Gemini 等后端接到同一入口,并支持 KV 缓存感知路由和 gRPC 流水线。
跨平台开源语音输入工具,按下热键自然说话,就能在任意应用中直接得到润色后的文字,省去手动打字。
把模型打包成 OCI 镜像来分发和运行,让任意 agent 都能跑在任意模型上,省去环境配置和模型管理的麻烦。
把 reMarkable2 电子纸平板变成视觉大模型的输入画板,手写或画图后直接发给 ChatGPT、Claude、Gemini 识别与对话。
在写轮子前先查查有没有人做过:用向量检索和本地 LLM 在 npm、PyPI 上搜索相似包,判断你的开发点子是否已被实现。
用 Rust 实现的高性能 GraphRAG 引擎,从文档中抽取实体构建知识图谱,支持可配置实体抽取和本地 LLM 接入,实现自然语言问答。

用 Rust 写的开源 AI 网关,单二进制自带控制台,统一路由、鉴权、预算和观测 OpenAI、Anthropic、Gemini、Bedrock 等各家 LLM 调用。
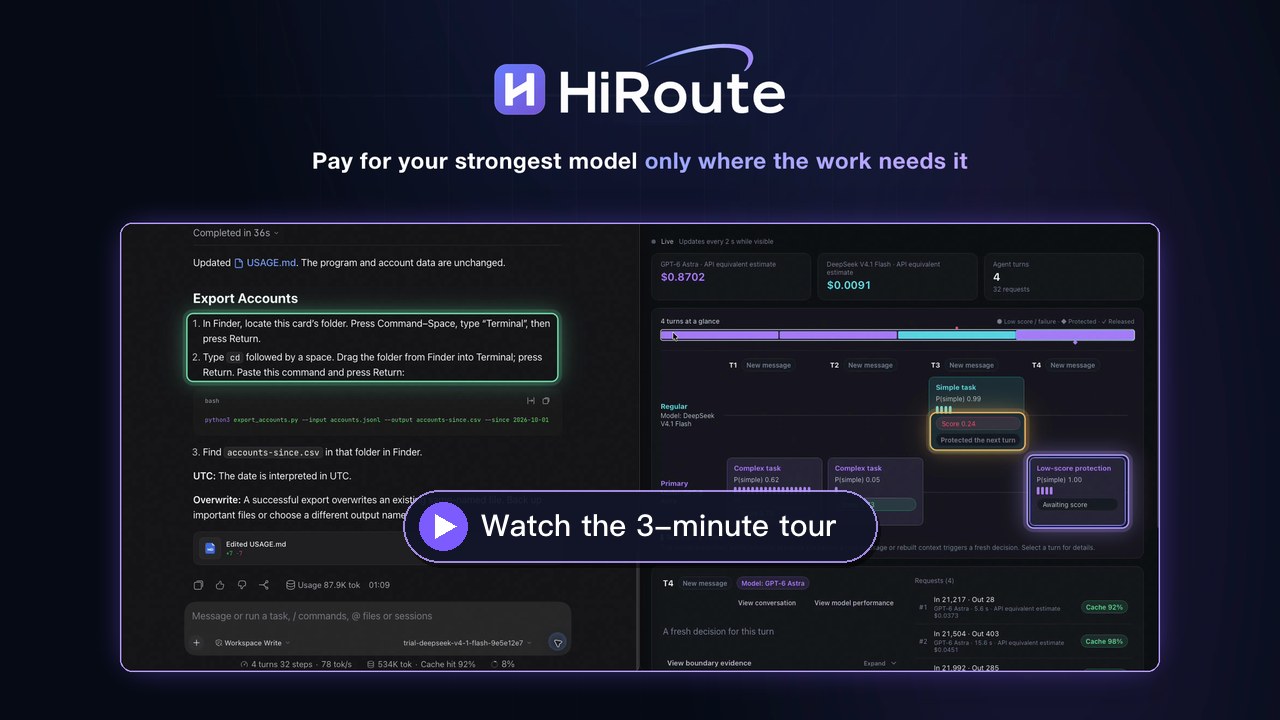
本地模型路由器,把日常 agent 任务分给便宜模型,难题留给最强模型,让 Codex 和 Claude Code 订阅更耐用、更省钱。
纯 Rust 实现的大模型推理引擎,不依赖 PyTorch 和 Python 运行时,主打极快推理速度,适合部署 Qwen 等模型和构建 Agent 服务。

让 PC 开机直接进入大模型运行环境,基于 Rust 的 UEFI 常驻方案,底层不需要操作系统,省去启动系统开销。
面向智能体应用的一站式后端底座,把 AI 网关、数据建模和 CRUD API 串起来,省去自己拼装 LLM 路由与可观测性。
面向 vLLM 和 SGLang 的 KV cache 复用层,用 Rust 实现,把前缀缓存扩展到 DRAM、SSD 和跨主机,降低大模型推理的重复计算和显存压力。
统一调用 170+ 家 LLM 提供商的单一 API 客户端,Rust 内核并提供各主流语言原生绑定,省去为每家模型单独对接的麻烦。

面向 LLM 推理的高性能 KV cache 存储层,通过 GPU 卸载、SSD 缓存和 RDMA 跨节点共享,缓解长上下文推理的显存瓶颈,兼容 vLLM 与 SGLang。
面向 AI Agent 的执行控制平面,统一管控模型请求、MCP 工具调用、A2A 委派和下游动作,同时保持原生 LLM 协议不变,支持多模型接入与故障切换。