模型工具链
共 203 个仓库 · 一年内有推送
面向 Windows 开发者的开源示例库,演示如何用本地模型和 API 给 Windows 应用加上 AI 能力,覆盖 ONNX Runtime、DirectML 和 NPU 加速。
自托管 Chatterbox 语音合成模型的服务端,带 Web 界面和 OpenAI 兼容 API,支持预置音色、声音克隆和长篇有声书文本处理,可在 NVIDIA、AMD 和 CPU 上加速运行。
OuteTTS 模型的推理接口,支持 GGUF 和 Transformers 后端,方便本地跑文本转语音。
把 ONNX 模型转成 TensorFlow 格式,方便在 TensorFlow 生态里直接加载和运行其他框架训练好的模型。
无需 ROOT 的安卓屏幕实时翻译工具,通过端侧或云端 OCR 识别游戏、视觉小说和漫画中的文字,再用离线 LLM 或在线翻译服务把译文直接叠加显示在画面上。
免训练稀疏注意力方案,可直接接入任意模型推理,加速 LLM、视觉 Transformer 和视频生成,无需重新训练即可降低注意力计算开销。
基于 PyTorch 的推荐模型训练框架,封装了 CTR 预估、生成式推荐等常用算法,开箱即用且方便扩展,支持昇腾 NPU 和 ONNX 导出。
面向 OpenVINO 推理的神经网络压缩框架,提供量化、剪枝和混合精度训练,把模型压小提速后再部署。
把 Keras、scikit-learn、LightGBM 等训练好的模型转成 ONNX 格式,方便跨框架部署和推理。
把对话语言模型压到 2-bit 量化,小到能在 8 位 Z80 处理器上跑,用 Python 训练后导出成 CP/M 的 .COM 程序,让老电脑也能聊天。
把量化神经网络编译成 FPGA 上的数据流推理加速器,省去手写 RTL 的麻烦,适合做低延迟边缘部署。
PyTorch 量化后端,接入 Optimum 生态,支持多种量化方案,帮你在推理和训练中压缩模型、降低显存占用。
一份 10 周、每天 30 分钟的 LLM 推理服务与优化学习路线,覆盖 vLLM、SGLang、量化、投机解码和基准测试,帮工程师系统入门推理加速。
基于 YOLO 系列模型和 TensorRT 加速的 FPS 游戏自动瞄准工具,用 GPU 实时检测画面中的目标并驱动准星移动。
跨平台多媒体处理框架,支持 GPU 加速和异构调度,可把转码、AI 推理、算法模块和直播流处理串成一条流水线。
把 ONNX 模型一键转成 TFLite、TensorFlow、PyTorch 原生代码或 TorchScript,省去跨框架部署时手写转换脚本的麻烦。
为 Jetson Nano 准备的 Ubuntu 20.04 系统镜像,预装 CUDA、OpenCV、PyTorch、TensorFlow、TensorRT 等深度学习环境,省去在边缘设备上手动配置的麻烦。
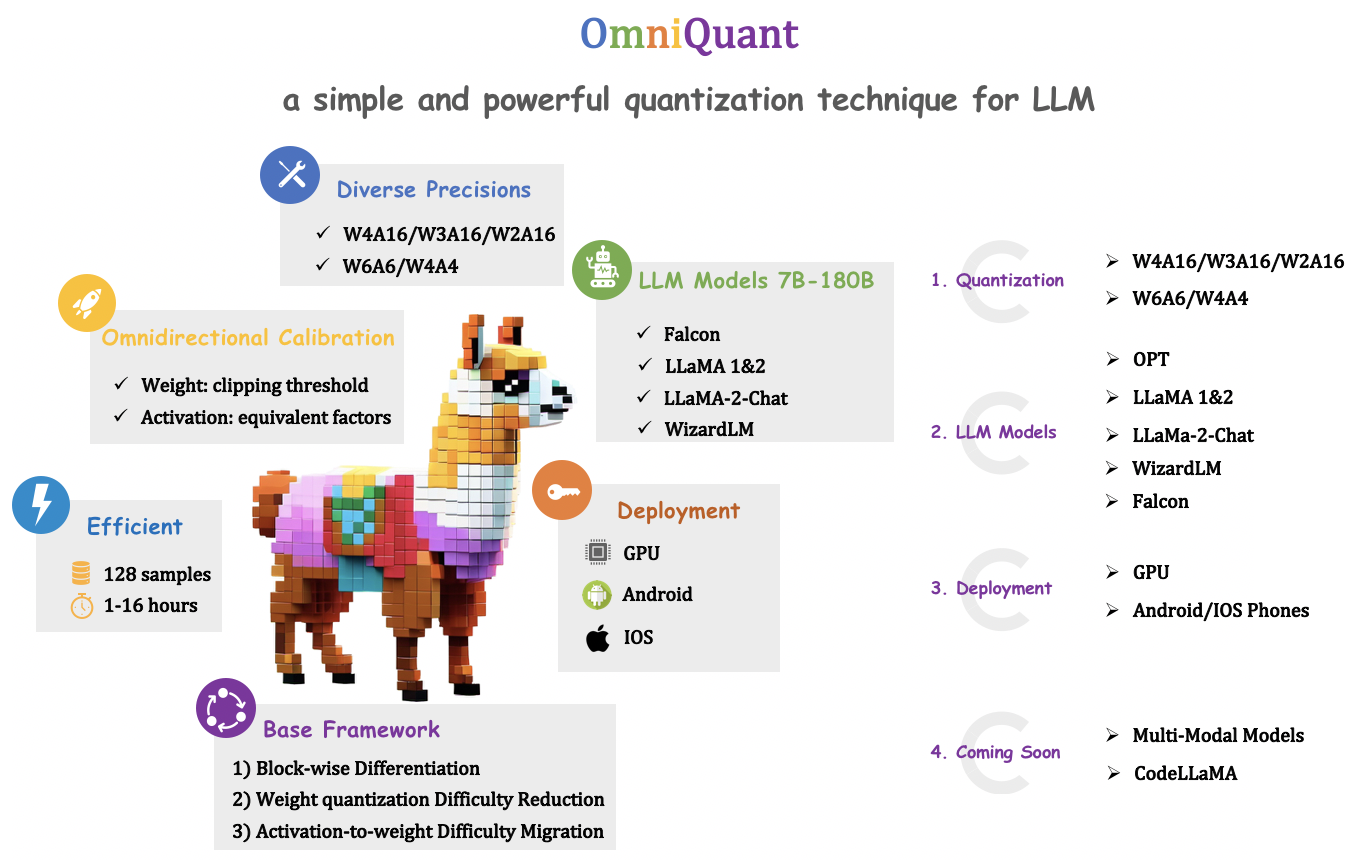
一种简单又强大的大模型量化技术,通过可学习权重裁剪和等价变换,在保持精度的同时把 LLM 压到低比特,方便部署推理。
本地优先的开源视频编辑器,创作者和 AI 智能体共用同一条真实时间线协作剪辑,支持自动字幕、AI 配音与音乐生成。
HQQ 是一种无需校准数据的大模型量化方法,官方实现支持几行代码把 LLM 压到低比特,省显存还能保持精度。
在笔记本 CPU 上本地跑二分类、多选和带概率打分的决策模型,是 Jev 和 Microsoft-Decision-1 的开源替代,支持 GGUF 量化推理。
把 RGBA 像素转换成高质量调色板图像的量化库,是 pngquant 等 PNG 压缩工具的核心,能在保持画质的同时大幅减小图片体积。
用 Swift 写的轻量本地大模型推理库,能在 macOS、iOS、watchOS、tvOS、visionOS 上直接跑 GGUF 模型,代码简单易读,方便苹果生态应用集成。
一个高效易用的深度学习模型压缩框架,支持剪枝、训练后量化和量化感知训练,能把 PyTorch 模型转换部署到端侧。