模型工具链
共 203 个仓库 · 一年内有推送
基于 TensorFlow Keras 的量化深度学习库,支持量化感知训练,方便把模型部署到 FPGA、ASIC 等硬件加速器上。
把 ONNX 模型转成 Keras 或 TFLite 的转换工具,方便将 PyTorch 训练好的模型部署到移动端和嵌入式设备,还支持量化。

一个 MCP 服务器,能统计各 AI 编程代理节省了多少 token、优化上下文,并在 16 种 CLI 客户端间共享本地实时知识图谱。
基于节点编辑器的图像处理应用,用拖拽连线的方式搭建和对比不同处理流程,适合做算法验证和效果比较。
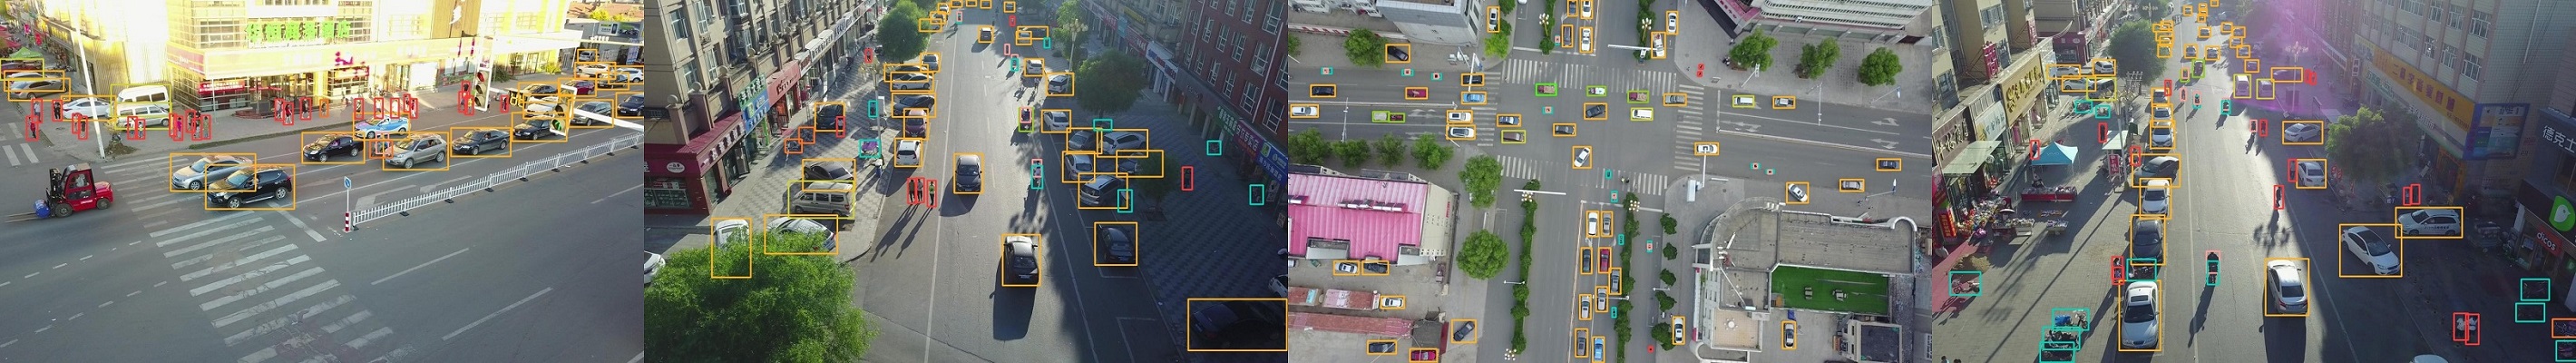
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。
QeRL 通过量化让强化学习训练 32B 大模型只需单张 H100 显卡,大幅降低大模型 RL 微调的显存门槛。
一款 ONNX 模型优化工具,通过精简计算图和冗余节点来减小模型体积、提升推理速度,适合部署前做模型瘦身。
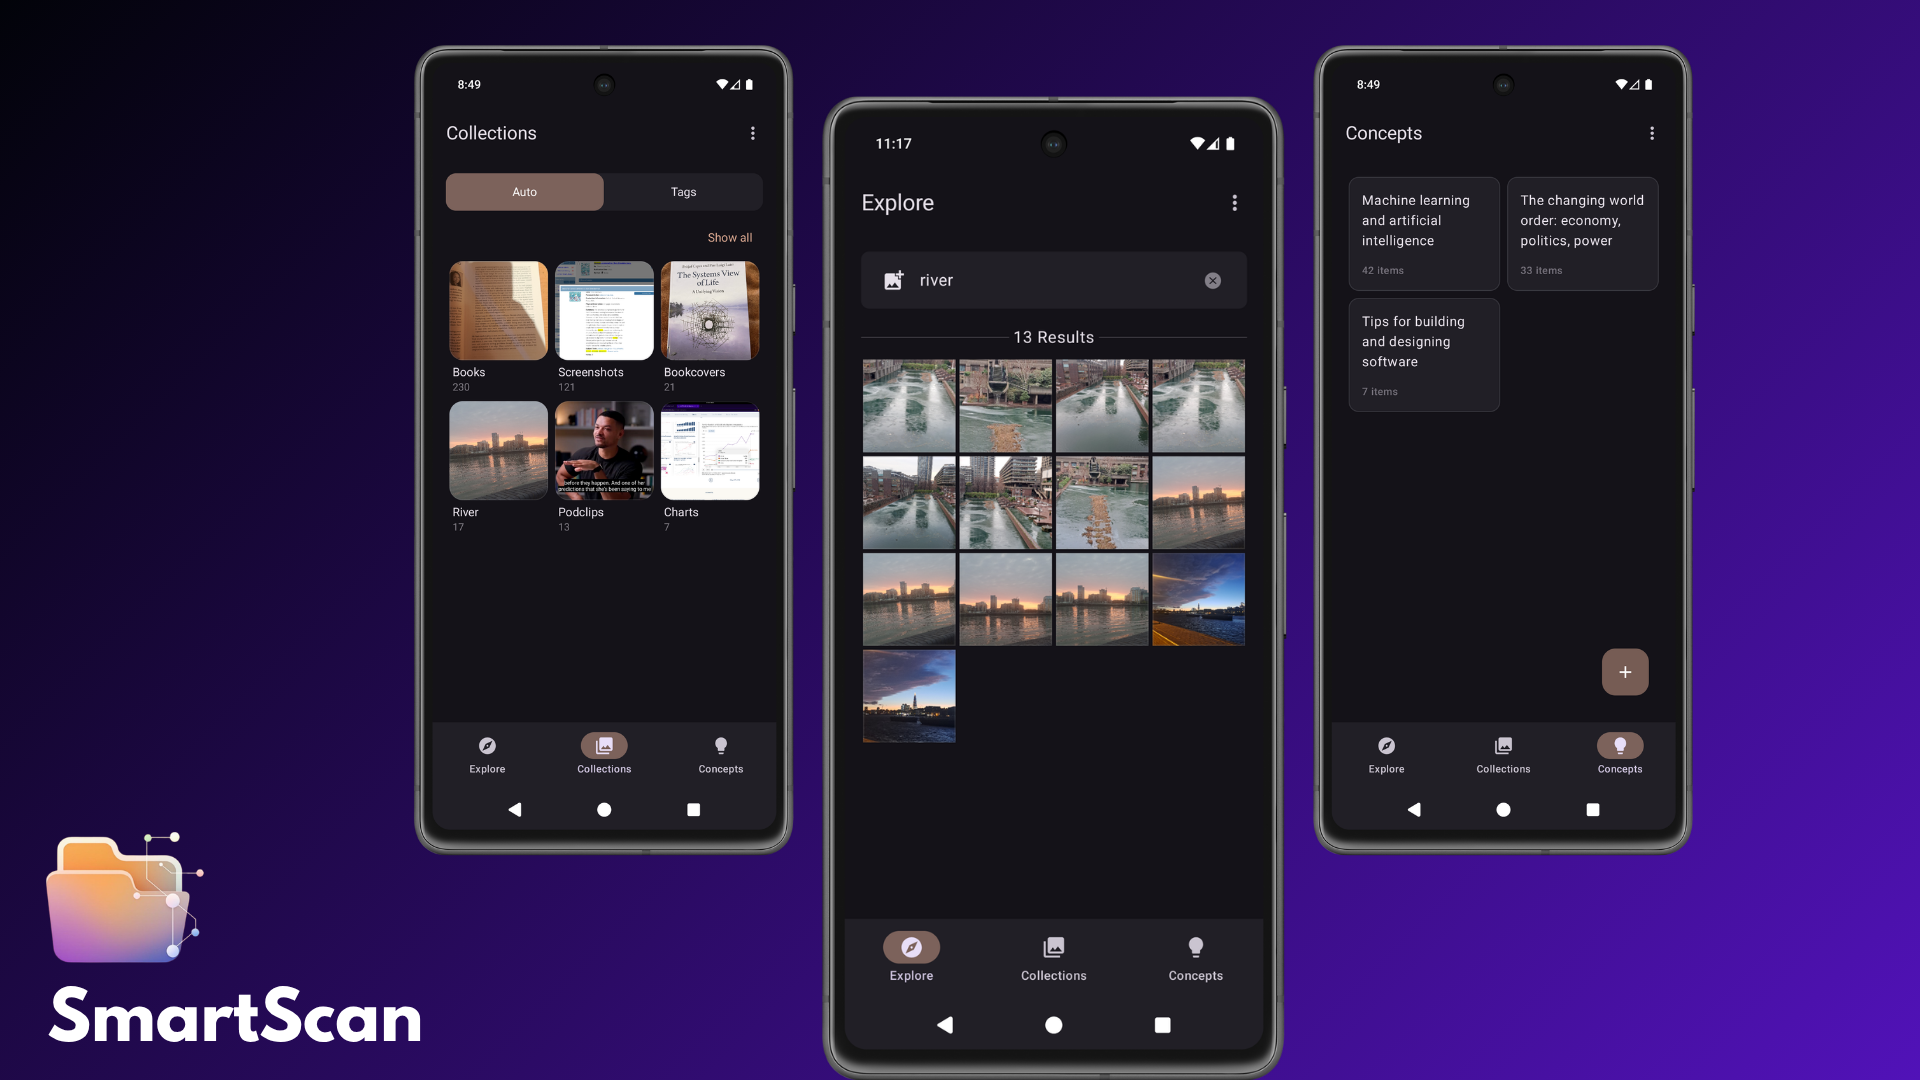
把手机里的图片和视频在本地用 ONNX 模型提取向量,建成可相似度检索的个人知识库,全程离线不传云端。
在单张 RTX 4090 加 110GB 内存的游戏 PC 上本地跑 552B 的 DeepSeek-V4.1-Flash 做编码智能体,MoE 专家分层放在显存、锁页内存和 NVMe 上,兼容 OpenAI 与 Anthropic API。
面向重度用户的纯本地 Android 输入法,内置无限剪贴板历史搜索与标签、待办、自研滑行输入和可配置纠错,数据不出设备。
解析、编辑、优化和性能分析 ONNX 模型的 Python 工具,方便查看模型结构、修改计算图并定位推理瓶颈。
为 VapourSynth 视频处理框架提供 CPU/GPU 高效推理运行时,内置 waifu2x、Real-ESRGAN、RIFE、Real-CUGAN 等超分、降噪、插帧模型,方便在视频后期流程里直接调用。
基于 Qwen3.6-27B 做去审查与能力增强的 abliteration 模型,配合 NVFP4 量化和 DFlash 投机解码,在 DGX Spark 上优化长上下文草稿接受率,附多种 HF 变体与 Docker 部署。
微软开源的神经架构搜索(NAS)研究框架,提供快速、可复现、模块化的实验流程,帮你在 PyTorch 上跑 DARTS、Petridish 等 NAS 算法并做超参优化与模型压缩。
用 LangChain.js、LlamaIndex.TS 和微软 Agent Framework 编排多个 AI 智能体,通过 MCP 协作,演示可部署到 Azure 容器应用的企业级旅行应用。
提供示例应用,演示如何把 TAO 训练的模型部署到 DeepStream 视频分析流水线,覆盖 YOLOv3、RetinaNet、DSSD 等模型。
面向 iPad 和 iPhone 的开源端侧 AI 智能体工作台,在设备本地跑 Linux、终端、Python/Node.js、Git 和 3D/CAD 编辑,支持自带密钥接入大模型。
面向边缘受限硬件的神经网络压缩工具包,提供量化感知训练和训练后量化等高级量化压缩能力,帮研究者把模型高效部署到资源紧张的设备上。
面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。
免调优的 KV Cache 2bit 非对称量化方案,能大幅压缩大模型推理时的显存占用,让长上下文推理在有限显存下跑起来。
跨平台多媒体开发套件,提供 Dolby Vision、HDR、D3D12、Metal 等硬件加速解码与播放能力,方便在各类设备上集成高质量视频处理。
收录 Agent、模型架构、训练、RAG 与端侧 AI 等方向突破性论文的精选档案库,方便快速跟进大模型前沿研究。
把 ONNX 模型编译成纯 C 代码,方便在单片机和边缘设备上直接跑推理,不用带完整运行时。
面向 ASIC、FPGA 和 NPU 的加速器设计与编程框架,用 Python DSL 描述硬件,再经编译器生成高性能硬件实现。