权重需从 GitHub Releases 单独下载,仓库不含模型文件;用 TensorRT 需自行安装 torch2trt 和 TensorRT Development Toolkit(>7.1.3.0);昇腾 om 转换依赖华为官方库,部分仅购买硬件者可下载。
edgeyolo
LSH9832Apache-2.0更新放缓面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。
an edge-real-time anchor-free object detector with decent performance
deploy发布于 2025-08-10 15:40 UTC531star71fork同步于 2026-11-07 07:30 UTC
git clone https://github.com/LSH9832/edgeyolo.git
cd edgeyolo
pip install -r requirements.txt 硬件要求按 README 说明
README 未给出显存要求;性能数据基于 Nvidia Jetson AGX Xavier(TensorRT fp16),并支持 RK3588、华为昇腾 310、地平线 J5 等平台部署。
需要 CUDA有 Docker 镜像
面向边缘设备的实时无锚框目标检测器,在 Jetson 上也能跑到高帧率
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。
核心能力
- 无锚框检测头,在 Jetson AGX Xavier 上 640 输入达 34FPS
- 提供 Tiny 到 M 多档模型,COCO 最高 50.6% AP
- 支持导出 ONNX、TensorRT(含 int8 校准)及 RKNN、MNN、昇腾 om
- 支持 COCO、YOLO、VOC、VisDrone、DOTA 五种数据集格式
- 训练末尾引入 RH 损失并增强数据增强,提升中小模型效果
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
- deployDeployment Tool is coming:EdgeYOLO多平台统一部署方案最新正式版2025-08-10 · 2025-08-10 15:40 UTC
目前支持TensorRT,MNN,OpenVINO,RKNN,hbDNN,Ascend多平台部署,详见deployment分支
附件给出了
- 各平台的示例模型,TensorRT(.engine)、MNN(.mnn)、OpenVINO(直接用onnx)、RKNN(.rknn)、Ascend(.om)、hbDNN(.bin)
- windows下openvino框架下的推理demo,测试方式如下
.\bin\demo.exe -c .\config\openvino.yaml -s .\vtest.avi - v1.1.02024-12-07 · 2024-12-07 15:13 UTC
查看更新说明
A unified deployment project is uploaded for multiple platforms without the need to modify code for different platforms, see deployment
- v1.0.22023-12-06 · 2023-12-06 06:19 UTC
查看更新说明
rknn model and code for rk3588
- v1.0.12023-11-23 · 2023-11-23 13:22 UTC
查看更新说明
just see mnn code for more information.
- v1.0.02023-02-11 · 2023-02-11 10:00 UTC
查看更新说明
EdgeYOLO vesion1.0.0 is coming!
Here we provide:
- VisDrone dataset with COCO format (which was used in our training).
- torch2trt source code
- yolo console demo(exe)
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。

EdgeYOLO: 边缘设备友好的无锚框检测器

工具推荐: 使用SAM(Segment Anything Model) 辅助的图像标注工具: SAMLabeler Pro,支持多人同时远程标注
简介
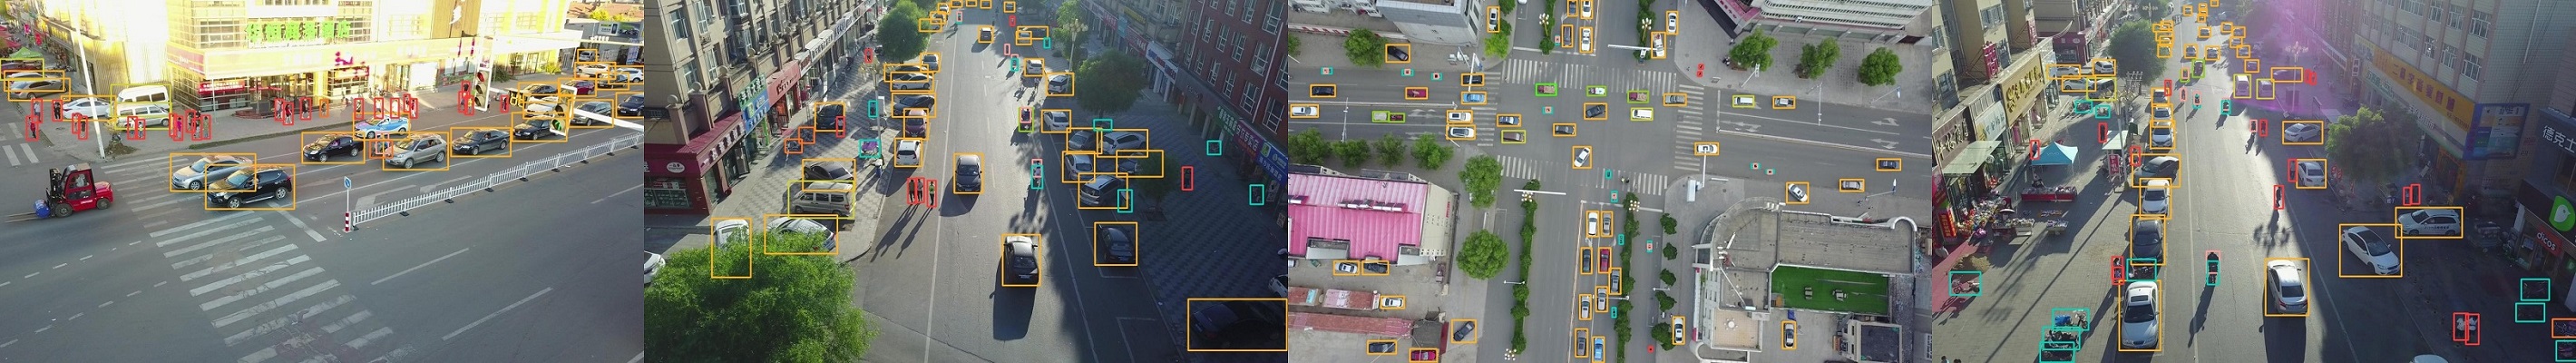
- EdgeYOLO 在嵌入式设备 Nvidia Jetson AGX Xavier 上达到了34FPS,在COCO2017数据集上有50.6% AP的准确度,在VisDrone2019-DET数据集上有25.9% AP的准确度 (图像输入大小为640x640, 批大小为16, 包含后处理时间)。更小的模型EdgeYOLO-S在COCO2017数据集上以44.1% AP、63.3% AP0.5(目前单阶段P5小模型中最好的)准度达到了53FPS的速度。
- 我们提供了更加强大的数据增强方法,可以在数据集标签稀疏时起到更好的效果。
- 在训练末尾阶段使用RH损失函数,中小模型的检测效果有所提升。
- 我们的论文(预印版)已在arxiv公布
更新
[2025/8/13]
- 将多平台统一化部署项目移至deloyment分支并进行了一定的重构,同时增加对OpenVINO的支持。
[2024/12/7] 重大更新
1. 上传了多平台统一化部署项目,无需针对不同平台修改代码,详见目录deployment
[2024/3/16]
- 上传了demo/amct_onnx2om.py 该脚本用于将onnx模型转换为华为昇腾系列设备上支持的om模型(比如昇腾310),并且发布c++部署代码示例. (注意,你必须拥有华为官网提供的相应依赖库和工具,部分依赖仅购买相应硬件的用户才有下载权限)
[2024/3/6]
- 我们上传了用于方便训练和模型导出的docker镜像,可以方便地将模型一键导出为RKNN,MNN,地平线J5,Jetson等平台支持的部署模型
[2023/12/6]
[2023/11/23]
- MNN模型推理部署代码已发布。
[2023/2/28]
- 现在支持对TensorRT模型进行evaluation了。
[2023/2/24]
- 现在edgeyolo支持YOLO格式的数据集了
- 修复了一些已知错误(在Linux下的cpp代码使用--loop选项时的错误以及分布式训练对标签进行缓存时发生的错误)
[2023/2/20]
- TensorRT C++ 命令行演示代码 (需要用到opencv 和 qt5的库)
- 修复了使用7.X版本的TensorRT导出模型时产生的bugs
[2023/2/19]
- 发布带有校准训练过程的TensorRT int8模型导出代码
即将到来
- 更多不同的模型
- 用于实例分割任务EdgeYOLO-mask模型
- 简单有效的预训练方法
模型
- 在COCO2017-train上训练的模型
| 模型 | 输入大小 | mAPval0.5:0.95 | mAPval0.5 | FPSAGX Xaviertrt fp16 批大小=16 包含NMS | 参数量train / infer(M) | 下载 |
|---|---|---|---|---|---|---|
| EdgeYOLO-Tiny-LRELU | 416640 | 33.137.8 | 50.556.7 | 206109 | 7.6 / 7.0 | github |
| EdgeYOLO-Tiny | 416640 | 37.241.4 | 55.460.4 | 13667 | 5.8 / 5.5 | github |
| EdgeYOLO-S | 640 | 44.1 | 63.3 | 53 | 9.9 / 9.3 | github |
| EdgeYOLO-M | 640 | 47.5 | 66.6 | 46 | 19.0 / 17.8 | github |
| EdgeYOLO | 640 | 50.6 | 69.8 | 34 | 41.2 / 40.5 | github |
- 在VisDrone2019上训练的模型 (这些模型骨干网络初始参数来自于上面的模型)
- 训练时使用的是 已转化为COCO格式的 VisDrone2019 数据集 。
- 以下是没有去掉在ignored region中检测框的情况下测得的结果
| 模型 | 输入大小 | mAPval0.5:0.95 | mAPval0.5 | 下载 |
|---|---|---|---|---|
| EdgeYOLO-Tiny-LRELU | 416640 | 12.118.5 | 22.833.6 | github |
| EdgeYOLO-Tiny | 416640 | 14.921.8 | 27.338.5 | github |
| EdgeYOLO-S | 640 | 23.6 | 40.8 | github |
| EdgeYOLO-M | 640 | 25.0 | 42.9 | github |
| EdgeYOLO | 640 | 25.926.9 | 43.945.4 | github(原)github(新) |

快速使用
安装
git clone https://github.com/LSH9832/edgeyolo.git
cd edgeyolo
pip install -r requirements.txt
如果使用TensorRT,请确保设备上已经安装好torch2trt和TensorRT Development Toolkit(version>7.1.3.0)。
git clone https://github.com/NVIDIA-AI-IOT/torch2trt.git
cd torch2trt
python setup.py install
或者为了保证和我们用的是同一个版本的torch2trt, 请在这里下载
如果你想使用docker那么
- 从百度网盘, 14.3G下载docker镜像, 分享码: ujar
- 然后导入镜像
docker import edgeyolo_deploy.tar.gz edgeyolo:latest
- 运行镜像
docker run -it \
           --runtime=nvidia \
           -e NVIDIA_DRIVER_CAPABILITIES=compute,utility \
           -e NVIDIA_VISIBLE_DEVICES=all \
           --shm-size 15g \
           -w /code \
           -v "/path/to/your/edgeyolo/parent_dir":/code \
           -v "/path/to/your/dataset/parent_dir":/dataset \
           edgeyolo:latest
之后你就可以在docker镜像里使用 "docker_export.py" 导出模型而不是使用 "export.py" 了,这将会更加方便。
推理
首先 在此下载模型的权重文件
python detect.py --weights edgeyolo_coco.pth --source XXX.mp4 --fp16

# 完整命令参数
python detect.py --weights edgeyolo_coco.pth      # 权重文件
                 --source /XX/XXX.mp4             # 或网络视频流地址,或目录下全部为图片的文件夹, 或rosbag(xxx.bag)
                 --topic  /camera/xxx             # 仅当使用rosbag或从ros中某个话题提取图片时使用该选项
                 --conf-thres 0.25                # 置信度阈值
                 --nms-thres 0.5                  # 重合度阈值
                 --input-size 640 640             # 输入大小
                 --batch 1                        # 批大小
                 --save-dir ./output/detect/imgs  # 如果按下键盘"s"键,当前图像将保存在该文件夹中
                 --fp16                           # 半精度推理
                 --no-fuse                        # 不进行重参数化
                 --no-label                       # 不显示带有类别和置信度的标签,仅画框
                 --mp                             # 使用多进程,当 batch>1 时可以使图像显示更流畅
                 --fps 30                         # 最大FPS限制, 仅在使用 --mp 选项时有效
训练
- 首先准备好你的数据集并创建好相应的数据集配置文件(./params/dataset/XXX.yaml),配置文件中应包含如下信息:
(目前支持COCO、YOLO、VOC、VisDrone、DOTA五种格式的数据集)
type: "coco"                        # 数据集格式(小写),目前支持COCO格式、YOLO格式、VOC格式、VisDrone格式、DOTA格式
dataset_path: "/dataset/coco2017"   # 数据集根目录

kwargs:
  suffix: "jpg"       # 数据集图片后缀名
  use_cache: true     # 使用缓存文件,在i5-12490f上测试完整加载时间:有分割标签979MB:52s -> 10s, 无分割标签228MB:39s -> 4s

train:
  image_dir: "images/train2017"                   # 训练集图片文件夹
  label: "annotations/instances_train2017.json"   # 训练集标签文件(单文件格式)或文件夹(多文件格式)

val:
  image_dir: "images/val2017"                     # 验证集图片文件夹
  label: "annotations/instances_val2017.json"     # 验证集标签文件(单文件格式)或文件夹(多文件格式)

test:
  test_dir: "test2017"                            # 测试集图片文件夹(代码中暂未使用,后续将会完善)

segmentaion_enabled: true                         # 是否有并且使用实例分割标签代替目标框标签进行训练

names: ['person', 'bicycle', 'car', 'motorcycle', 'airplane', 'bus', 'train', 'truck', 'boat', 'traffic light',
        'fire hydrant', 'stop sign', 'parking meter', 'bench', 'bird', 'cat', 'dog', 'horse', 'sheep', 'cow',
        'elephant', 'bear', 'zebra', 'giraffe', 'backpack', 'umbrella', 'handbag', 'tie', 'suitcase', 'frisbee',
        'skis', 'snowboard', 'sports ball', 'kite', 'baseball bat', 'baseball glove', 'skateboard', 'surfboard',
        'tennis racket', 'bottle', 'wine glass', 'cup', 'fork', 'knife', 'spoon', 'bowl', 'banana', 'apple',
        'sandwich', 'orange', 'broccoli', 'carrot', 'hot dog', 'pizza', 'donut', 'cake', 'chair', 'couch',
        'potted plant', 'bed', 'dining table', 'toilet', 'tv', 'laptop', 'mouse', 'remote', 'keyboard', 'cell phone',
        'microwave', 'oven', 'toaster', 'sink', 'refrigerator', 'book', 'clock', 'vase', 'scissors', 'teddy bear',
        'hair drier', 'toothbrush']    # 类别名称
- 修改训练配置文件 ./params/train/train_XXX.yaml中的相应参数
- 最后使用如下命令启动训练
python train.py --cfg ./params/train/train_XXX.yaml
你可以通过"plot.py"绘制损失曲线、学习率曲线和准确度曲线(AP50 和 AP50:95)
python plot.py --all \                                   # 绘制所有曲线或 (--lr:学习率, --ap:准确度, --loss:损失)
               -f ./output/train/edgeyolo_tiny_lrelu \   # 训练的输出文件夹路径或 (文件路径:--ap则使用output_path/eval.yaml, --lr和--loss则使用output_path/log.txt)
               --no-show \                               # 不使用plt.show()显示曲线, 适用于无图形界面的设备(如云服务器),或你仅仅想保存图片
               --save    \                               # 保存图片
               --format pdf png svg jpg eps              # 保存图片的格式,支持多种格式同时保存
准确度曲线
损失曲线
学习率曲线
验证
python evaluate.py --weights edgeyolo_coco.pth --dataset params/dataset/XXX.yaml --batch 16 --device 0

# 完整命令参数
python evaluate.py --weights edgeyolo_coco.pth        # 权重文件, 也可是tensorrt模型,output/export/edgeyolo_coco/model.pt
                   --dataset params/dataset/XXX.yaml  # 数据集配置文件
                   --batch 16                         # 每一个GPU上的批大小
                   --device 0                         # 只用一个就写0就行
                   --input-size 640 640               # 高、宽(注意别反了)
                   --trt                              # 如果使用的是TensorRT模型需要加上此选项
                   --save                             # 保存没有优化器参数的权重文件,并将训练次数重置为-1
导出 onnx & tensorrt
- ONNX
python export.py --onnx --weights edgeyolo_coco.pth --batch 1

# all options
python export.py --onnx                 # 如果没有安装tensorrt和torch2trt,用--onnx-only代替
                 --weights edgeyolo_coco.pth
                 --input-size 640 640   # 宽、高(注意别反了)
                 --batch 1
                 --opset 11
                 --no-simplify          # 不简化模型结构
将生成
output/export/edgeyolo_coco/640x640_batch1.onnx
- TensorRT
# fp16
python export.py --trt --weights edgeyolo_coco.pth --batch 1 --workspace 8

# int8
python export.py --trt --weights edgeyolo_coco.pth --batch 1 --workspace 8 --int8 --dataset params/dataset/coco.yaml --num-imgs 1024

# 完整选项
python export.py --trt                       # 你可以添加上述--onnx和其相关选项,同时导出两种模型
                 --weights edgeyolo_coco.pth
                 --input-size 640 640        # 宽、高(注意别反了)
                 --batch 1
                 --workspace 10              # (GB)
                 --no-fp16        # 默认输出fp16精度模型,使用此选项关闭,转为fp32精度
                 --int8           # 输出int8精度,需要用到以下选项用于校准训练
                 --datset params/dataset/coco.yaml   # 校准训练图片来源于该数据集的验证集图片(上限5120张)
                 --train          # 使用训练集图片而不是验证集图片(上限5120张)
                 --all            # 使用训练集和验证集所有图片(上限5120张)
                 --num-imgs 512   # (上限5120张)
将产生
(可选)  output/export/edgeyolo_coco/640x640_batch1.onnx
output/export/edgeyolo_coco/640x640_batch1_fp16(int8).pt       # 用于 python 推理
output/export/edgeyolo_coco/640x640_batch1_fp16(int8).engine   # 用于 c++ 推理
output/export/edgeyolo_coco/640x640_batch1_fp16(int8).json     # 用于 c++ 推理
TensorRT Int8 量化模型基准测试
- 测试环境: TensorRT版本8.2.5.1, Windows, i5-12490F, RTX 3060 12GB
- 对于TensorRT来说,使用不同的校准数据集,产生的int8模型之间的精度和速度都可能有很明显的差异,这是由于tensorrt不是强制转换为int8的,有些层它觉得转了后效果不好就不转了,所以我认为这是为什么大部分官方项目都不给出int8量化效果的代码。我自认为下表结果并不具有多少参考意义。
COCO2017-TensorRT-int8
| Int8 模型 | 尺寸 | 校准图片数量 | 工作内存空间(GB) | mAPval0.5:0.95 | mAPval0.5 | FPSRTX 3060trt int8 batch=16 include NMS |
|---|---|---|---|---|---|---|
| Tiny-LRELU | 416640 | 512 | 8 | 31.536.4 | 48.755.5 | 730360 |
| Tiny | 416640 | 512 | 8 | 34.939.8 | 53.159.5 | 549288 |
| S | 640 | 512 | 8 | 42.4 | 61.8 | 233 |
| M | 640 | 512 | 8 | 45.2 | 64.2 | 211 |
| L | 640 | 512 | 8 | 49.1 | 68.0 | 176 |
python推理
python detect.py --trt --weights output/export/edgeyolo_coco/640x640_batch1_int8.pt --source XXX.mp4

# full commands
python detect.py --trt
                 --weights output/export/edgeyolo_coco/640x640_batch1_int8.pt
                 --source XXX.mp4
                 --legacy         # 如果训练时"img = img / 255"(图像输入归一化)
                 --use-decoder    # 如果使用早期的YOLOX(v0.2.0及以前)的tensorrt模型
                 --mp             # 使用多进程,当 batch>1 时可以使图像显示更流畅
                 --fps 30         # 最大FPS限制, 仅在使用 --mp 选项时有效
c++ 推理
# 编译
cd cpp/console/linux
mkdir build && cd build
cmake ..
make -j4

# 帮助
./yolo -?
./yolo --help

# 运行
# ./yolo [json文件(需要与engine文件同名)] [图像源] [--conf 置信度阈值] [--nms IOU阈值] [--loop 循环播放] [--no-label 不画标签]
./yolo ../../../../output/export/edgeyolo_coco/640x640_batch1_int8.json ~/Videos/test.avi --conf 0.25 --nms 0.5 --loop --no-label
引用EdgeYOLO
@article{edgeyolo2023,
  title={EdgeYOLO: An Edge-Real-Time Object Detector},
  author={Shihan Liu, Junlin Zha, Jian Sun, Zhuo Li, and Gang Wang},
  journal={arXiv preprint arXiv:2302.07483},
  year={2023}
}
目前发现的bugs
- 在训练时有时可能会触发以下错误,降低pytorch版本至1.8.0应该可以解决这个问题。
File "XXX/edgeyolo/edgeyolo/train/loss.py", line 667, in dynamic_k_matching
_, pos_idx = torch.topk(cost[gt_idx], k=dynamic_ks[gt_idx].item(), largest=False)
RuntimeError: CUDA error: device-side assert triggered
CUDA kernel errors might be asynchronously reported at some other API call,so the stacktrace below might be incorrect.
For debugging consider passing CUDA_LAUNCH_BLOCKING=1.
- 对于DOTA数据集,目前我们仅支持单GPU进行训练,请不要使用分布式训练方式对DOTA数据集进行训练,否则无法进行正确的训练,也无法得到正确的结果
- 如果使用TensorRT 8.4.X.X及以上的版本进行半精度模型的转换可能存在丢失大量精度甚至完全没有检出目标的情况,为保证使用请使用TensorRT 7.X.X.X 或 8.2.X.X 的版本

Paddle
PaddlePaddle·C++
飞桨核心框架,提供深度学习与机器学习的高性能单机及分布式训练能力,并支持跨平台部署,适合工业级模型开发。
深度学习框架+4国产 NPU
24140+26.0kv3.4.02026-11-10 09:44 UTC
gpustack
gpustack·Python
统一管理 GPU 集群,调度 vLLM、SGLang 等推理引擎做高性能模型服务,还能按需开出可 SSH 登录的 GPU 实例。
GPU 集群管理+4国产 NPU
6009+20730v2.3.02026-11-10 14:54 UTC
mindspore
mindspore-ai·C++
华为开源的深度学习训练与推理框架,覆盖移动端、边缘和云场景,主打国产 NPU 生态适配。
深度学习框架+4国产 NPU
4723+47472026-10-28 08:28 UTC
vllm-ascend
vllm-project·Python
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
昇腾+4国产 NPU
3071+142.7kv0.30.02026-11-10 16:45 UTC