模型工具链
共 110 个仓库 · Python
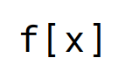
轻量级上下文感知语音合成模型,仅2.19亿活跃参数,支持声音克隆和流式输出,纯C实现可在CPU上离线运行,附带完整的实时语音助手方案。
把 TensorFlow、PyTorch、Caffe、ONNX 等模型一键转成飞桨格式,省去跨框架迁移时重写网络和权重的麻烦。
把 ONNX 模型直接转成 PyTorch 网络,方便在 PyTorch 里继续微调或调试,省去手工重搭结构的麻烦。
Hailo 官方预训练模型库,提供面向 Hailo-8 边缘 AI 加速器的模型、量化工具和完整评估环境,方便直接部署到端侧设备。
把 XGBoost、LightGBM、scikit-learn、CatBoost 和 ONNX 模型一键编译成原生 C99 推理代码,省去 Python 运行时开销,推理速度最高提升 336 倍。
面向 LLM 和扩散 Transformer 的无损压缩方案,在 GPU 推理时压缩模型权重、降低显存占用,同时保持输出完全一致。
SINQ 是一种即插即用的 LLM 量化方法,能把任意大模型压小并尽量保住精度,适合显存吃紧时部署 DeepSeek、Qwen 等模型。
把 scikit-learn 训练好的模型和 Pipeline 转成 ONNX 格式,方便跨框架部署和推理加速。
把 Qwen3-VL、Florence-2、InternVL 等视觉语言模型接进 ComfyUI 的节点包,顺带支持开放词表检测、SAM 分割、视频时序推理和 GGUF 量化加载。
基于 TensorFlow Keras 的量化深度学习库,支持量化感知训练,方便把模型部署到 FPGA、ASIC 等硬件加速器上。
把 ONNX 模型转成 Keras 或 TFLite 的转换工具,方便将 PyTorch 训练好的模型部署到移动端和嵌入式设备,还支持量化。
基于节点编辑器的图像处理应用,用拖拽连线的方式搭建和对比不同处理流程,适合做算法验证和效果比较。
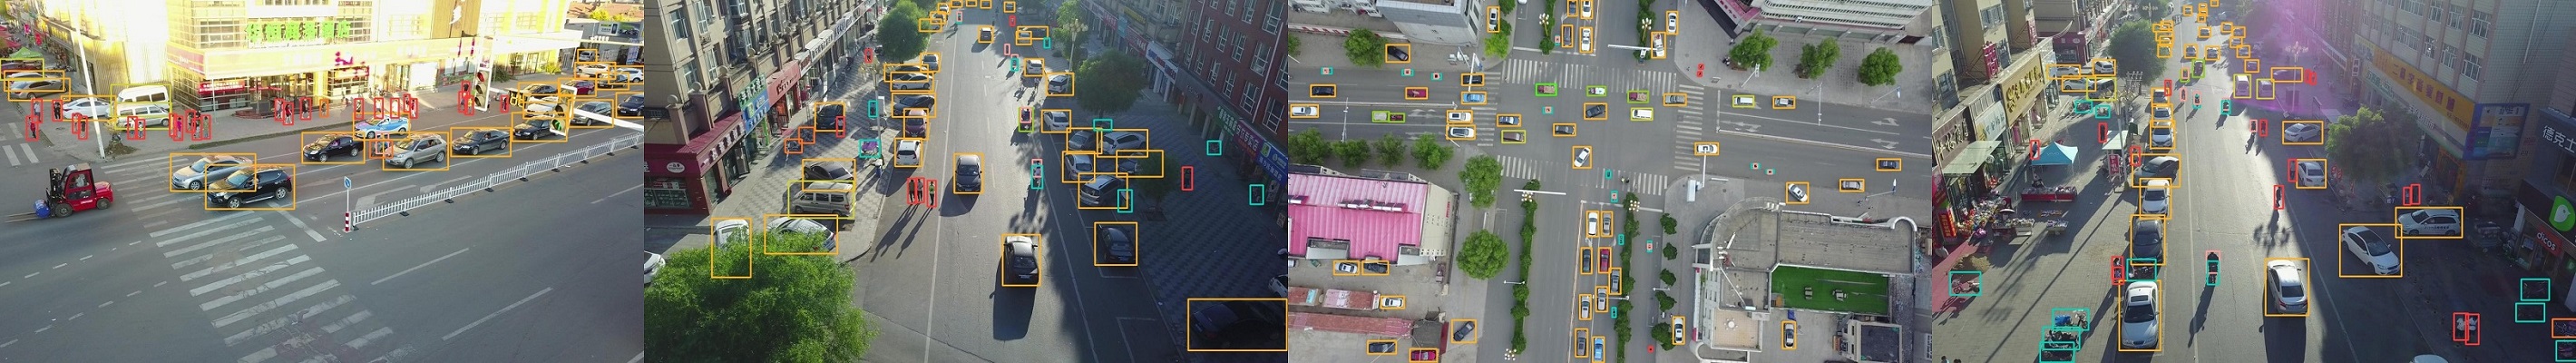
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。
QeRL 通过量化让强化学习训练 32B 大模型只需单张 H100 显卡,大幅降低大模型 RL 微调的显存门槛。
一款 ONNX 模型优化工具,通过精简计算图和冗余节点来减小模型体积、提升推理速度,适合部署前做模型瘦身。
解析、编辑、优化和性能分析 ONNX 模型的 Python 工具,方便查看模型结构、修改计算图并定位推理瓶颈。
基于 Qwen3.6-27B 做去审查与能力增强的 abliteration 模型,配合 NVFP4 量化和 DFlash 投机解码,在 DGX Spark 上优化长上下文草稿接受率,附多种 HF 变体与 Docker 部署。
微软开源的神经架构搜索(NAS)研究框架,提供快速、可复现、模块化的实验流程,帮你在 PyTorch 上跑 DARTS、Petridish 等 NAS 算法并做超参优化与模型压缩。
面向边缘受限硬件的神经网络压缩工具包,提供量化感知训练和训练后量化等高级量化压缩能力,帮研究者把模型高效部署到资源紧张的设备上。
面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。
免调优的 KV Cache 2bit 非对称量化方案,能大幅压缩大模型推理时的显存占用,让长上下文推理在有限显存下跑起来。
面向 ASIC、FPGA 和 NPU 的加速器设计与编程框架,用 Python DSL 描述硬件,再经编译器生成高性能硬件实现。
在 NVIDIA GPU 上为 StartLux-Decision 模型提供快速精确推理,支持 int8 和 4-bit 量化的 GGUF 权重,延迟比 vLLM FP8 低至 5.3 倍且答案逐位一致。
Neural network model repository for highly sparse and sparse-quantized models with matching sparsification recipes