模型工具链
共 110 个仓库 · Python
在 Apple Silicon 上做 W8A8/W4A8 量化推理,调用 M5 闲置的 INT8 TensorOps 让 LLM prefill 快 1.2–1.9 倍,并用类 FlashInfer 的 GQA 解码注意力加速 SDPA。

用 0.1% 的数据通过剪枝和知识蒸馏把 Segment Anything 模型压缩成轻量版,大幅降低显存和计算开销,同时保持分割精度。
safetensors 的扩展,能把稀疏量化后的张量高效存到磁盘,省空间又不牺牲加载速度,适合大模型量化权重的持久化。
在本地设备上跑大语言模型的推理引擎,靠 X-Bit 量化把模型压小,让 Llama、Gemma 这类模型在资源有限的机器上也能流畅生成。
基于截断 SVD 的大模型压缩方法,通过奇异值分解降低 LLM 参数量与显存占用,同时尽量保住生成质量,已中稿 ICLR 2025。
用 FP8/INT8 低精度做强化学习训练的 rollout 推理,在 vLLM 上跑出更快采样速度且不掉点,适合想压低 RL 训练推理成本的大模型团队。
在单张消费级显卡上跑 PPO、GRPO 和同策略蒸馏的轻量 RL 训练框架,让普通玩家也能做 LLM 对齐后训练。
一份边缘机器学习资源清单,汇总了研究论文、推理引擎、竞赛、书籍和线下活动,方便快速找到在嵌入式与移动端部署模型的相关资料。
把多智能体协作中积累的能力蒸馏进单个 LLM Agent,让一个模型就能跑出多智能体系统的效果,省去多路调用的开销。
面向 Apple Silicon 的自适应混合精度量化与推理运行时,把 GGUF 模型转成 MLX 可用格式,让 Mac 上跑大模型更省显存。
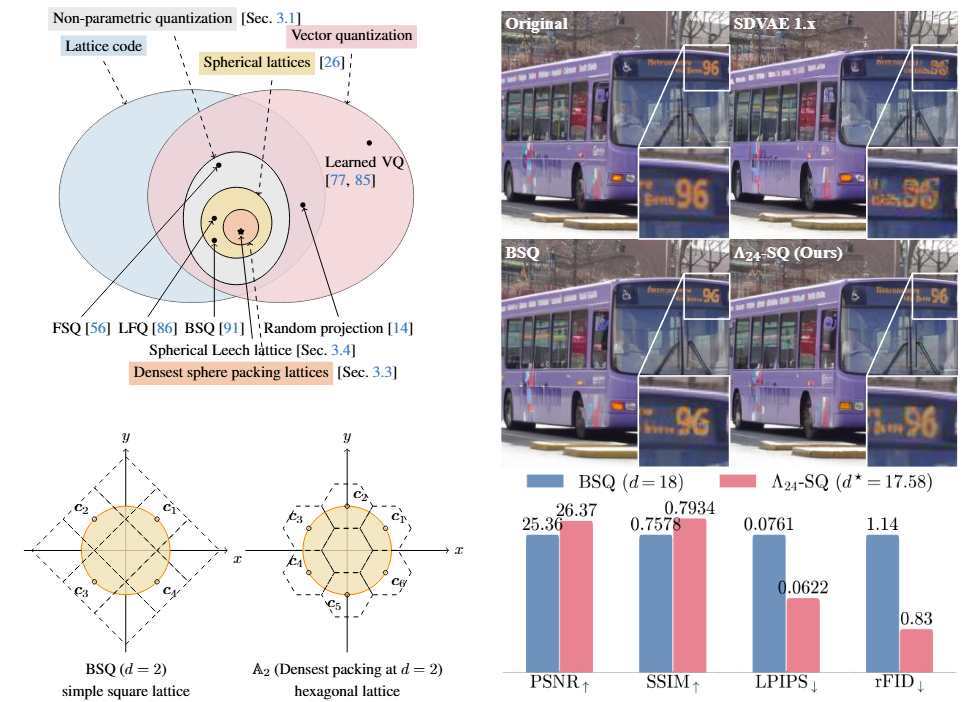
面向视觉 tokenizer 的球面量化方案,包含二值球面量化和 Leech 球面量化两种方法,用于压缩视觉 token 并提升表示效率。

给 Linux 和 macOS 用的开源 AI 摄像头与麦克风增强工具,能实现背景虚化、自动取景、降噪、录制和本地会议转写,相当于把 NVIDIA Broadcast 那套效果搬到了非 Windows 平台。
用能量参与比方法自动分析和设计量子微波芯片与器件,把超导量子电路的设计流程从手工仿真变成脚本化计算。
基于特征基旋转和水填充比特分配的 KV-Cache 量化压缩方案,用于降低大模型推理时的显存占用。