多模态生成
共 6 个仓库 · 只看有专家点评 · Jupyter Notebook
bark
suno-ai·Jupyter Notebook
输入一段文本就能生成带笑声、叹息等非语言声音和背景音乐的语音,效果自然,适合做创意配音和音频内容原型。
语音合成+3语音进阶
39348+304.7k2024-08-19 07:45 UTC
CLIP
openai·Jupyter Notebook
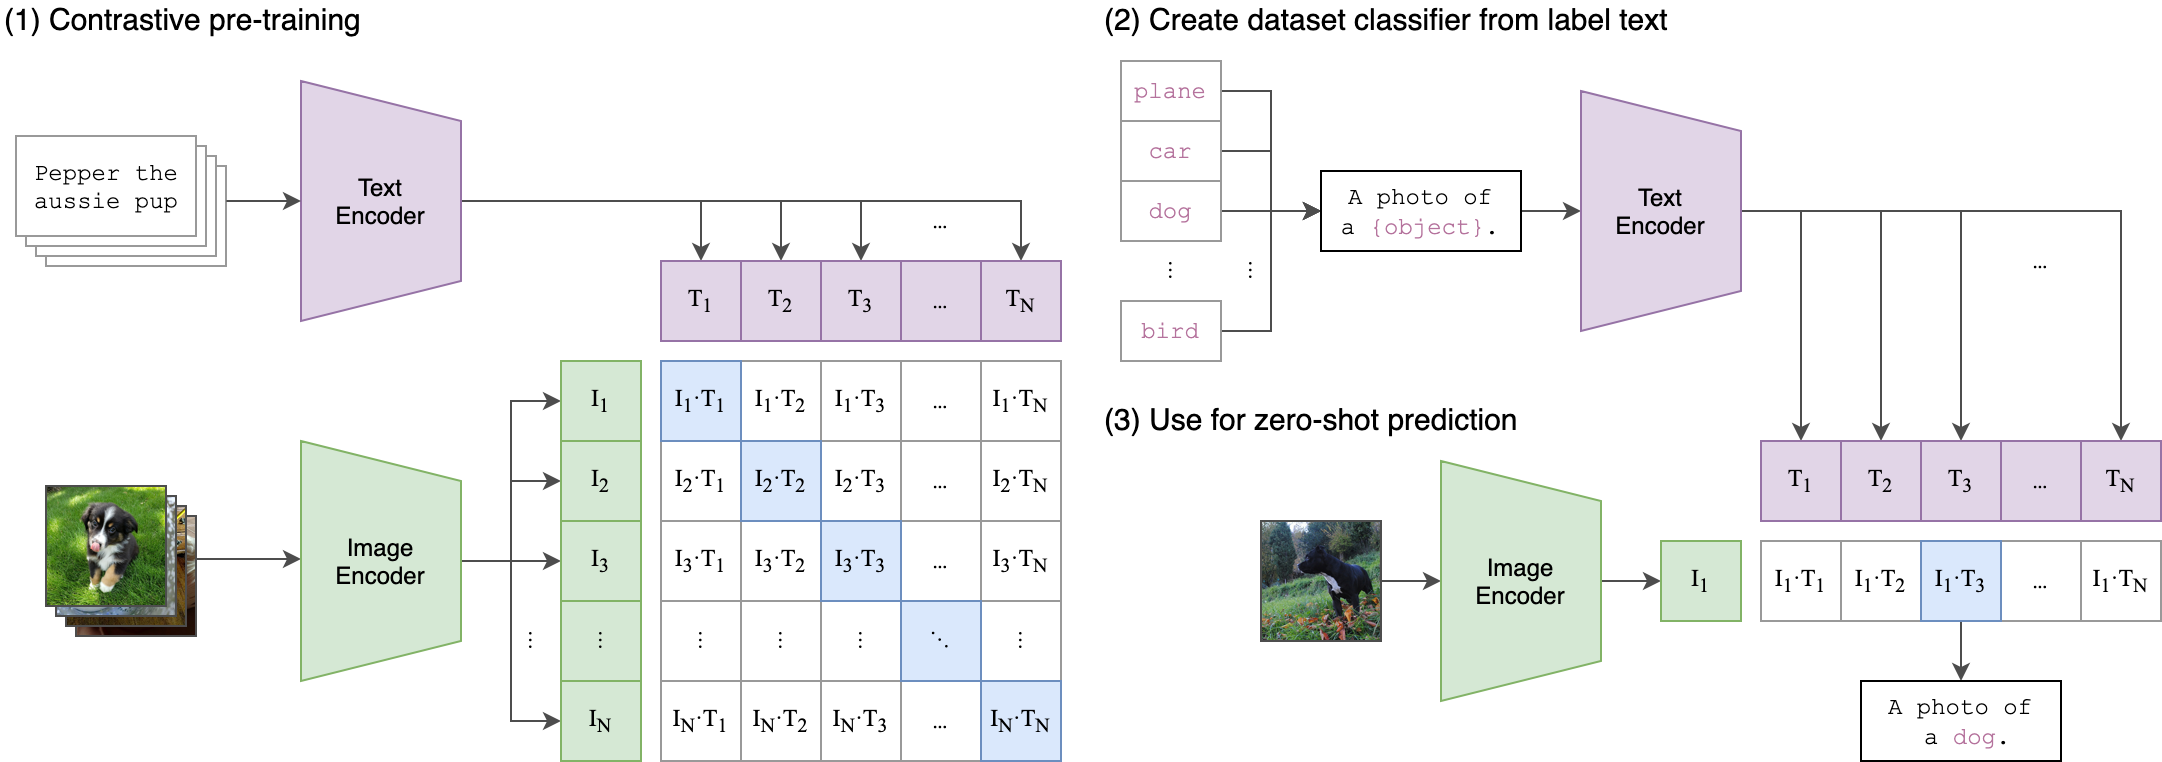
用对比学习把图像和文本映射到同一嵌入空间,实现零样本图像分类和图文匹配,是跨模态检索与多模态模型的经典底座。
多模态嵌入+4多模态嵌入进阶
34594+164.1k2026-03-25 18:46 UTC

Qwen3-VL
QwenLM·Jupyter Notebook
阿里云通义团队开源的多模态大模型系列,能同时理解图像和文本,用于视觉问答、图文推理等视觉语言任务。
多模态大模型+4视觉语言模型进阶
20191+161.9k2026-01-30 04:47 UTC
stable-diffusion-webui-colab
camenduru·Jupyter Notebook
在 Google Colab 上一键跑起 Stable Diffusion WebUI 的笔记本合集,省去本地显卡和环境配置,直接在线出图、图生图、训练 LoRA 和 DreamBooth。
Stable Diffusion+4图像生成入门
158892.6k0.0.172025-12-16 05:49 UTC

pyannote-audio
pyannote·Jupyter Notebook
基于 PyTorch 的说话人日志神经网络组件库,提供语音活动检测、说话人变化检测、重叠语音检测和说话人嵌入等预训练模块,方便搭建说话人分离与识别流程。
说话人日志+4语音进阶
10779+171.1k4.0.72026-11-09 05:43 UTC
VAR
FoundationVision·Jupyter Notebook
基于下一尺度预测的自回归视觉生成模型,用GPT式架构做图像生成并击败扩散模型,代码简洁易用,附带缩放定律研究。
自回归图像生成+4图像生成硬核
8768+35742025-11-10 21:42 UTC