多模态生成

共 372 个仓库 · 一年内有推送
打开分类页
VEGA-3D
H-EmbodVis·Python

把生成模型里隐含的 3D 先验知识迁移到场景理解任务上,让视觉语言模型在空间推理时更懂三维结构。
空间推理+4视觉语言模型
428232026-06-18 14:20 UTC
Olympus
yuanze-lin·Python

把多模态大模型变成能调度各类计算机视觉任务的通用路由器,用指令调优统一处理检测、分割等任务,免去为每个任务单独建模。
多模态大模型+4视觉语言模型
427732026-08-05 01:11 UTC
reconstruction-alignment
HorizonWind2004·Python

RecA 用自监督学习让多模态模型在生成图像时借助自身的视觉理解能力,提升文生图和图像编辑的效果,可接入 ComfyUI 使用。

多模态生成+4图像生成
419192026-09-11 03:10 UTC
Open-AI-UGC
Anil-matcha·JavaScript

开源的 AI UGC 视频广告生成器,用 Veo、Seedance 等模型生成真人感 AI 演员口播视频,可自托管替代 Arcads 和 MakeUGC。

AI 视频广告+4视频生成
4181202026-10-01 10:58 UTC
attention-map-diffusers
wooyeolbaek·Python

为 Hugging Face diffusers 提供注意力图提取与可视化工具,方便查看 Stable Diffusion 文生图时文本如何影响图像区域。

注意力图+4图像生成
41527v1.0.02026-08-07 10:56 UTC
CoVT
Wakals·Python

让视觉语言模型在推理时生成连续视觉 token 作为中间思考步骤,提升看图与推理表现,附带 ECCV 2026 论文官方实现。

视觉语言模型+4视觉语言模型
415232026-07-30 14:24 UTC
awesome-seedance-2.5-guides
Evolink-AI·Shell

收录 Seedance 2.5 官方指南与 36 个官方媒体素材,并保留旧版 Seedance 2 文档,方便查视频生成提示词和 API 用法。

视频生成+4视频生成
413482026-09-05 07:28 UTC
MagicBrush
OSU-NLP-Group·Python

MagicBrush 是 NeurIPS'23 发布的人工标注指令引导图像编辑数据集,为训练和评测文本指令驱动的图像编辑模型提供高质量数据。

图像编辑+4图像生成
412162026-10-17 22:07 UTC
videoprism
google-deepmind·Python

VideoPrism 是 DeepMind 开源的视频理解基础视觉编码器,用自监督学习预训练,可直接抽取视频特征,支撑分类、检索、问答等下游任务。

视频理解+4视觉语言模型
401422026-11-04 18:05 UTC
diffusers-torchao
sayakpaul·Python

用 torchao 和 diffusers 优化扩散模型的端到端教程,覆盖推理加速和 FP8 训练,帮你在 Flux 等文生图模型上省显存、提速度。

扩散模型+4图像生成
396172026-01-08 04:48 UTC
MACE
Shilin-LU·Jupyter Notebook

MACE 是 CVPR 2024 提出的扩散模型大规模概念擦除方法,能从 Stable Diffusion 等文生图模型中批量移除指定概念,适合做内容安全与版权合规。

概念擦除+4图像生成
391322026-07-20 11:58 UTC
BentoDiffusion
bentoml·Python

把 Stable Diffusion 等扩散模型用 BentoML 打包成可部署的推理服务,支持 LoRA 微调权重和 Kubernetes 部署,省去自己搭服务框架的麻烦。

扩散模型+4图像生成
390292026-11-09 11:07 UTC
RISE
OpenDriveLab·Python

RISE 用组合式世界模型让机器人策略自我进化,通过生成模型与价值学习提升操作任务表现,适合研究机器人学习与 VLA 的团队。
机器人策略+4图像生成
386242026-07-06 12:07 UTC
LightRFT
opendilab·Python

轻量高效的全模态强化微调框架,支持 GRPO、DAPO 等算法,用奖励模型驱动 LLM 和多模态 VLM 训练。

强化微调+4视觉语言模型
37912v0.1.12026-09-07 09:24 UTC
awesome-ai-media-cn
JuneYaooo

精选 150+ 开源 AI 视频制作与自媒体运营工具,覆盖一键生成、文生视频、多平台分发、字幕翻译等场景,每周更新。
AI视频+4视频生成
378+11502026-11-10 03:18 UTC
NAUTILUS
H-EmbodVis·Python

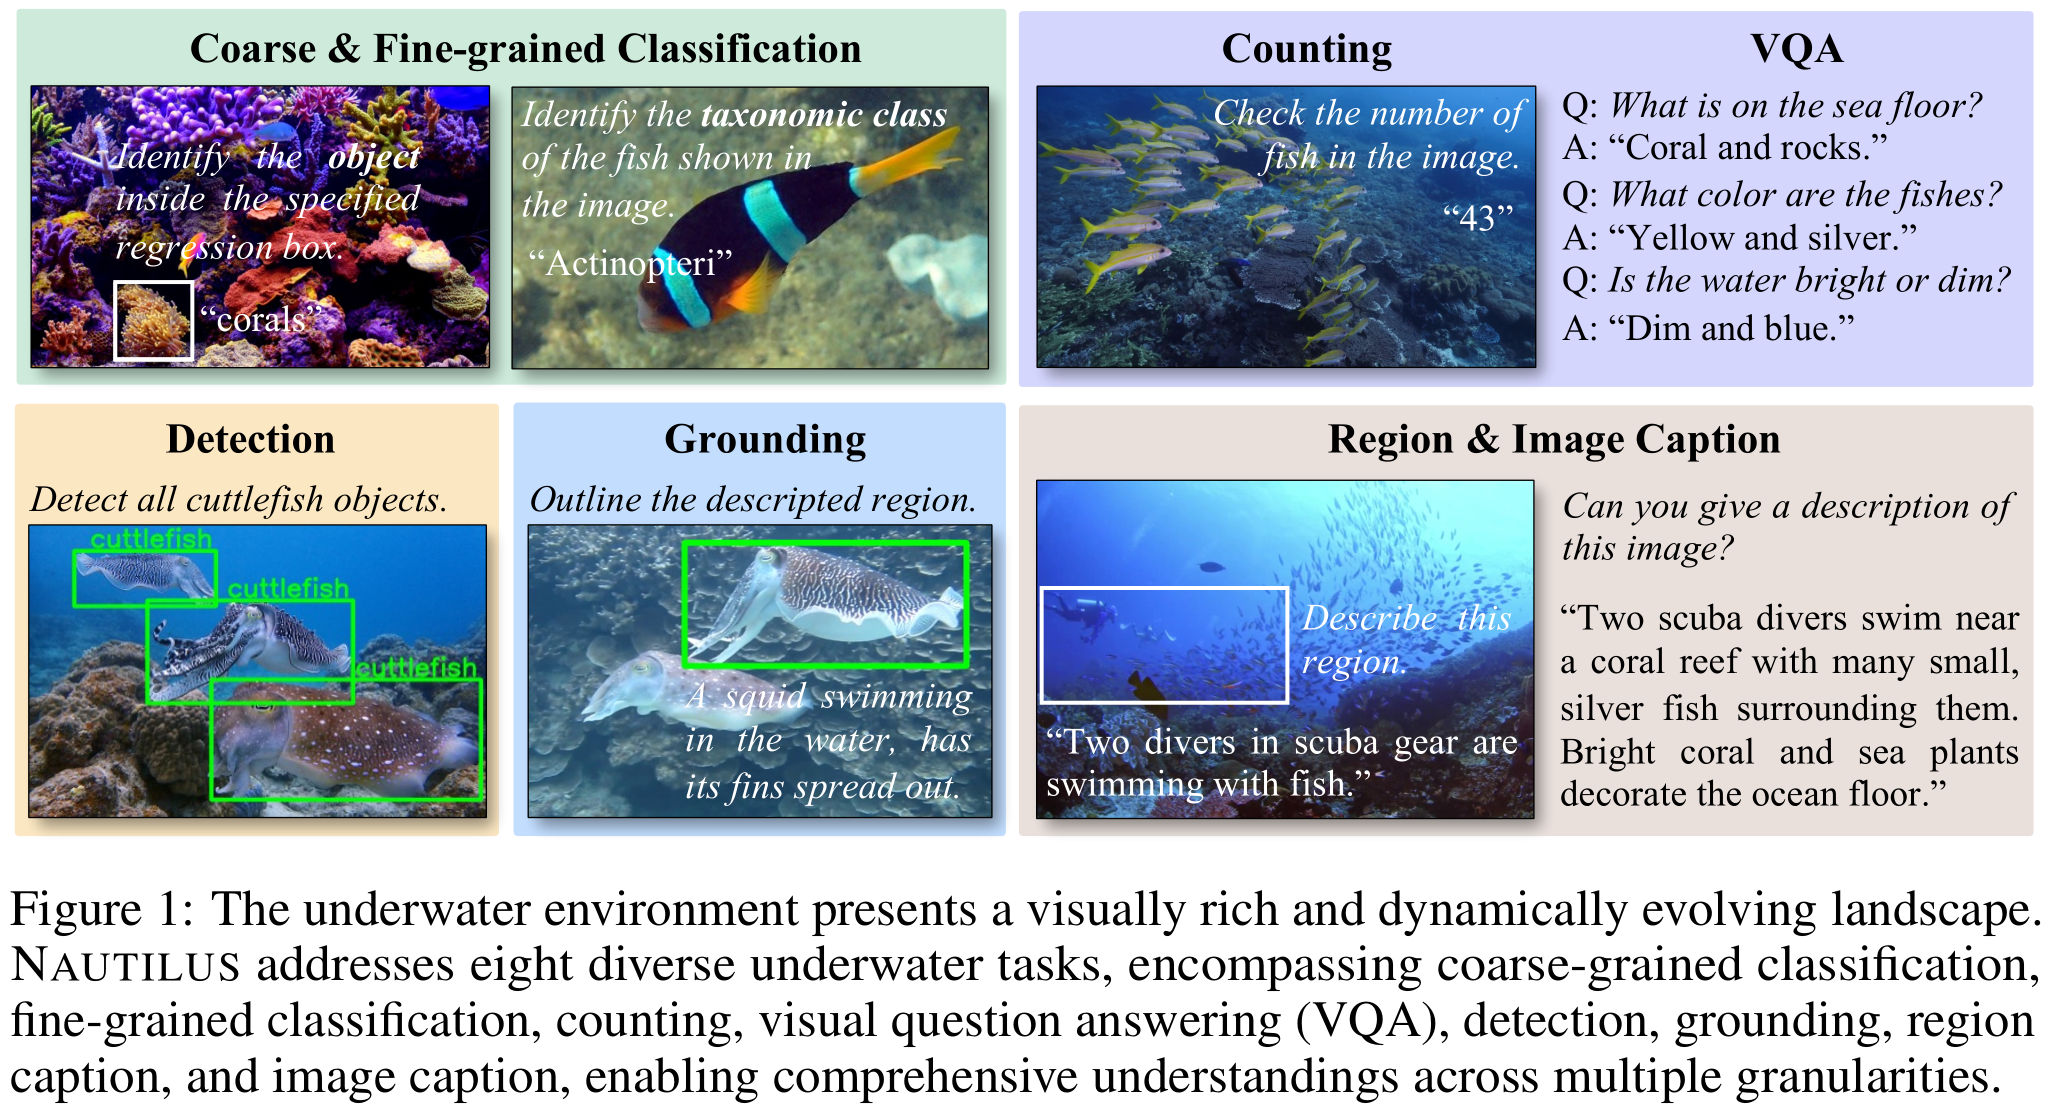
面向水下场景理解的大型多模态模型,能同时处理水下图像与文本,完成描述、问答等视觉语言任务,填补水下环境多模态研究的空白。
水下场景理解+4视觉语言模型
37729NautData2025-12-18 08:58 UTC
DepthLM_Official
facebookresearch·Python

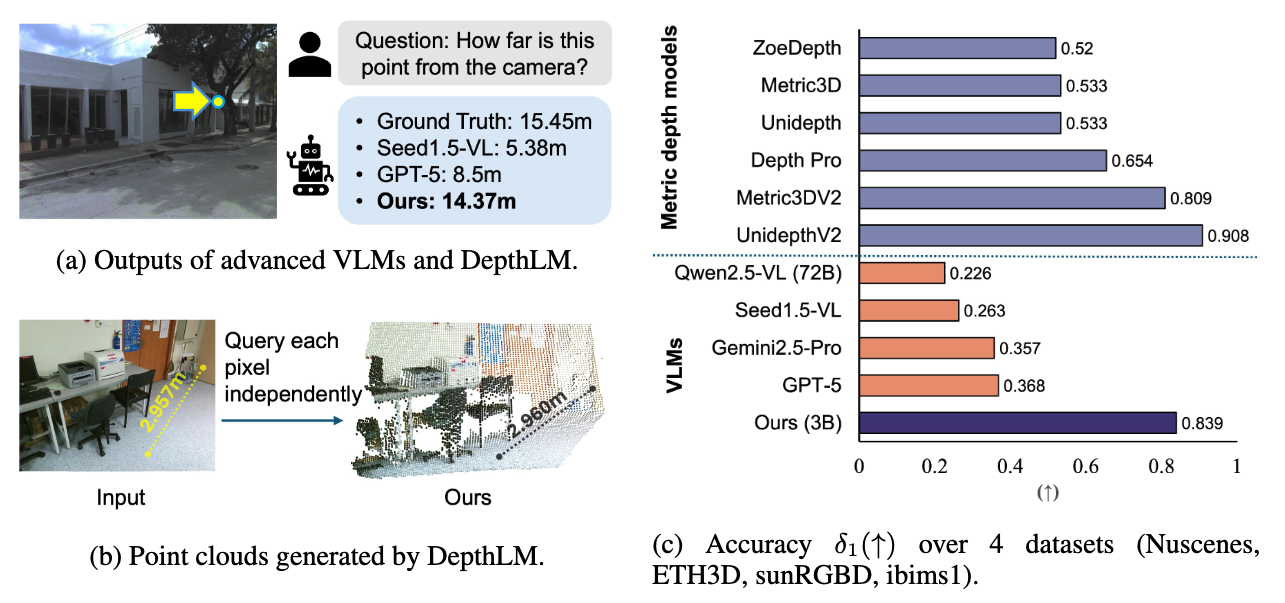
DepthLM 的官方实现,用视觉语言模型做单目深度估计,把深度预测转成语言建模任务,在 ICLR 2026 入选 Oral。
深度估计+4视觉语言模型
373162026-06-01 23:40 UTC
Phosphene
mrbizarro·Python

在 Apple Silicon Mac 上离线跑 LTX-2.5 和 MiniMax H3,做带声音的文本/图片转视频、对口型和角色 LoRA 训练,不用云端和 API key。

本地视频生成+4视频生成
368+5757v5.0.162026-11-11 11:03 UTC
FIBO
Bria-AI·Python

首个开源的 JSON 原生文生图模型,用结构化 JSON 输入实现可控、可预测且版权合规的图像生成。
文生图+4图像生成
359222026-11-03 14:06 UTC
EvoCUA
meituan·Python

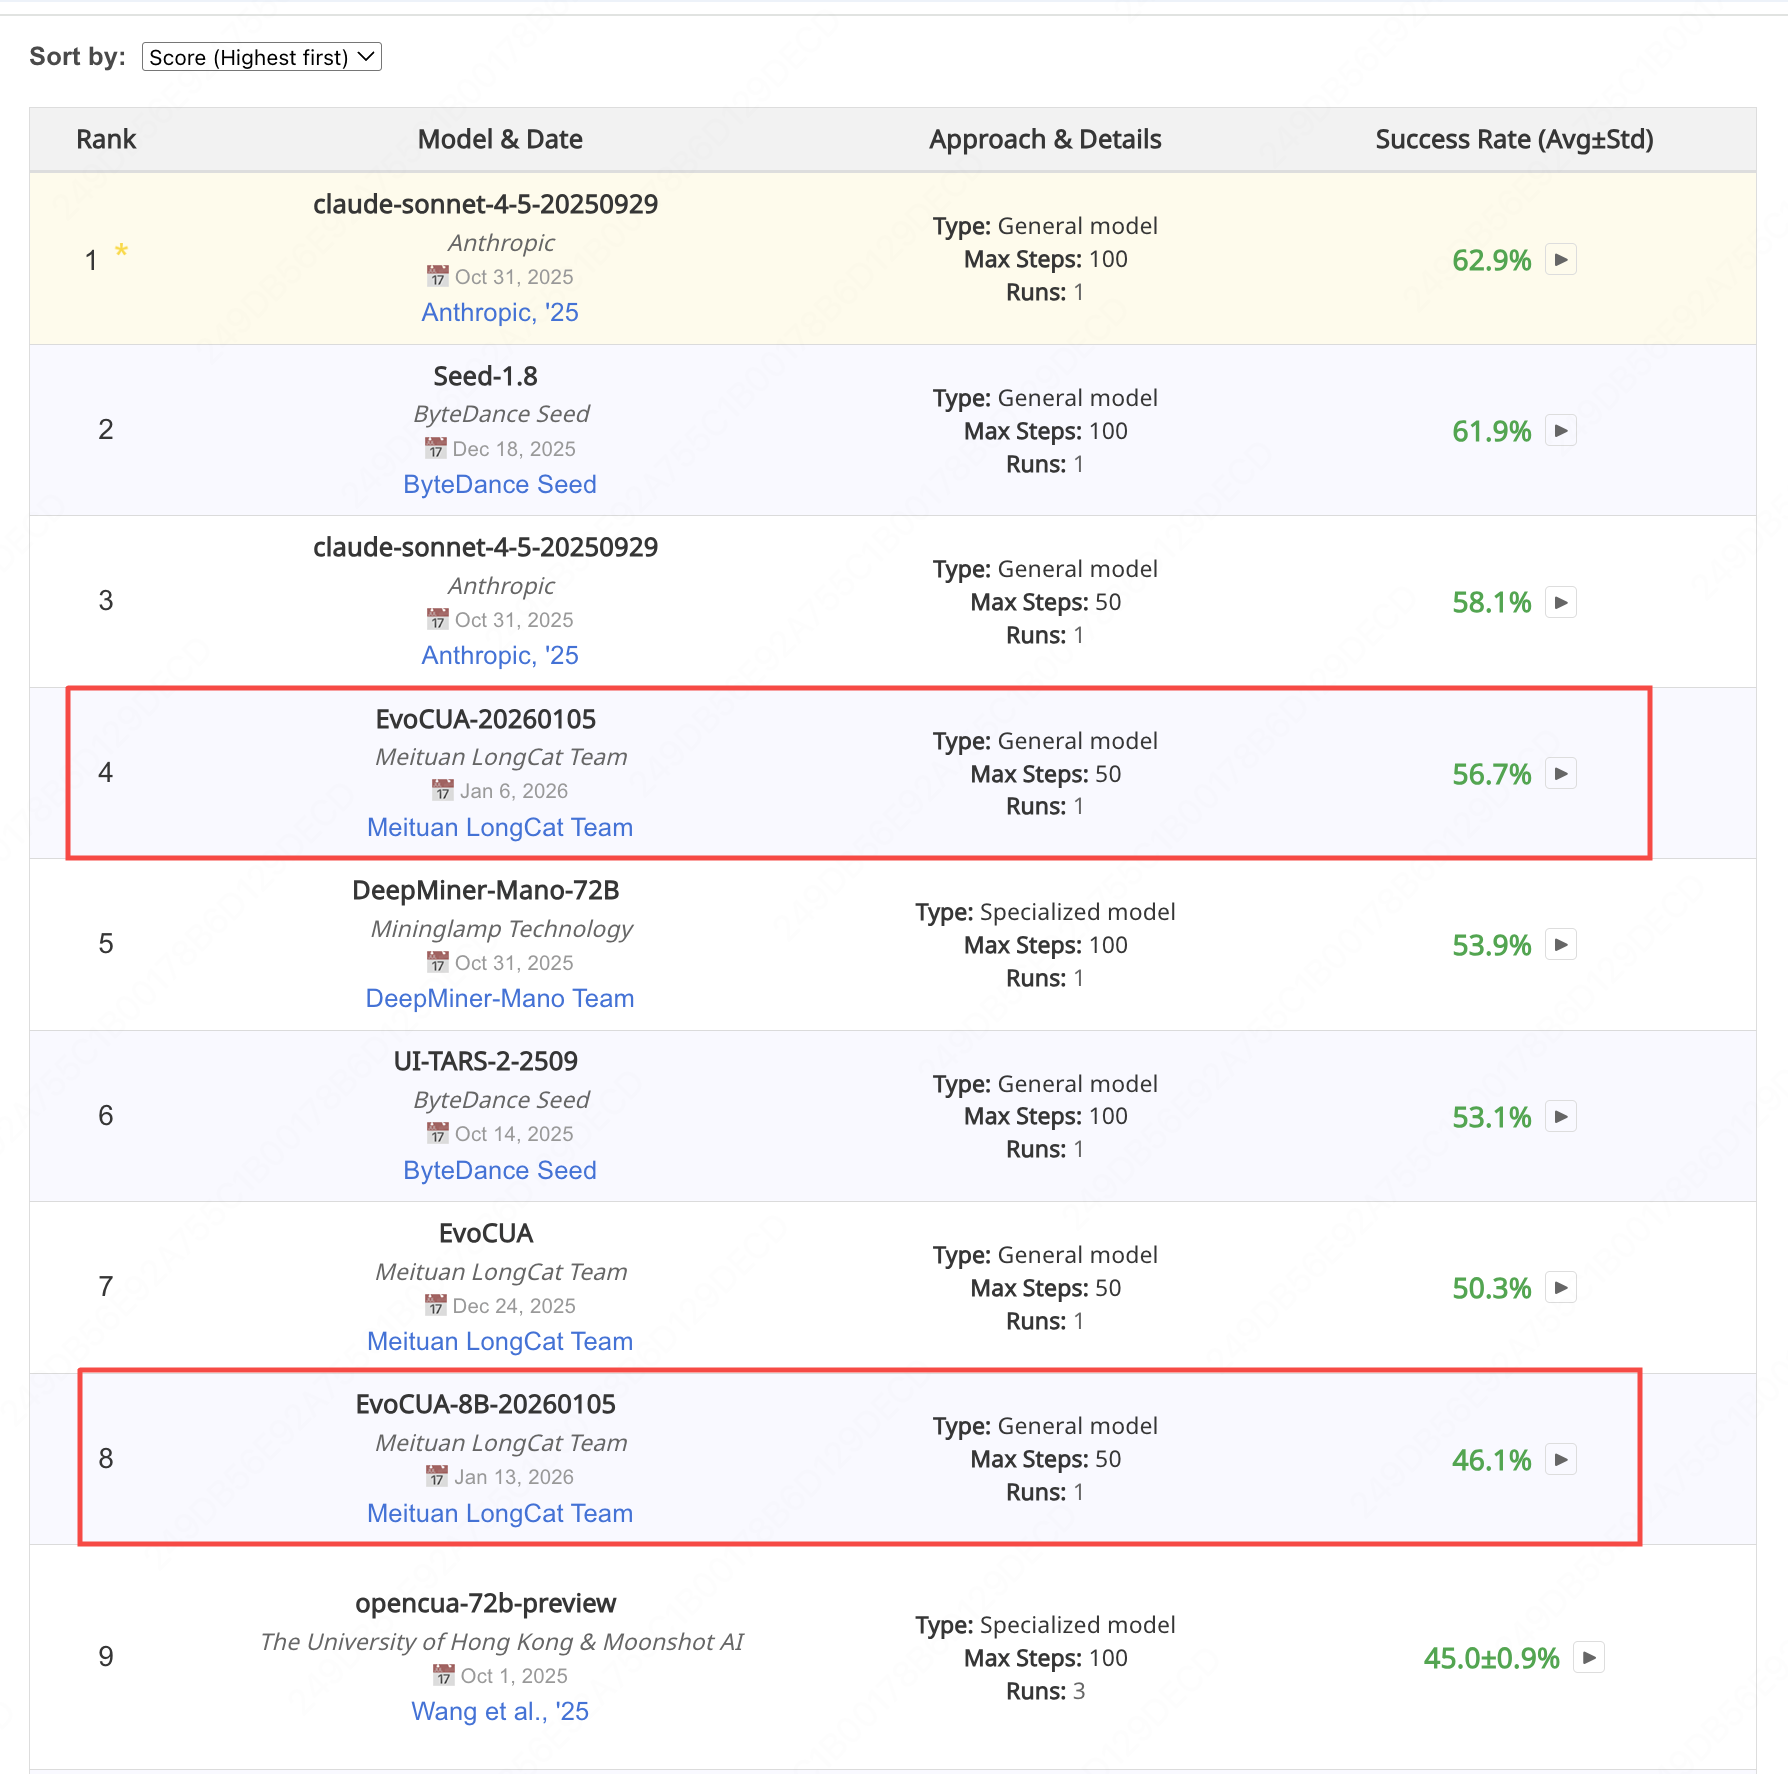
EvoCUA 是一个可自我进化的计算机使用智能体,基于视觉语言模型理解图形界面并自动完成操作任务。

计算机使用智能体+3视觉语言模型
355272026-03-31 05:16 UTC
VisionReasoner
JIA-Lab-research·Python

用强化学习把目标检测、分割、计数等视觉感知任务统一进多模态大模型的推理流程,让模型边推理边定位。

视觉感知+4视觉语言模型
353152026-02-09 05:33 UTC
R1-VL
jingyi0000·Python

用逐步分组相对策略优化(Step-wise GRPO)训练多模态大模型做推理,提升视觉语言任务上的推理能力。

多模态推理+4视觉语言模型
35322026-06-02 01:57 UTC
lora-dataset-studio
perfectgf·Python

本地一站式 LoRA 训练工作台,从单张照片或大批图片构建角色、风格、概念数据集,自动打标并用 ai-toolkit 训练,支持多模型 checkpoint 对比。

LoRA 训练+4图像生成
350+1042v2026.11.122026-11-09 18:22 UTC
PromptKD
zhengli97·Python

PromptKD 是 CVPR 2024 的官方 PyTorch 实现,用无监督提示蒸馏把大视觉语言模型的能力迁移到小模型上,免去人工标注。

提示蒸馏+4视觉语言模型
3487datasets2025-12-14 12:52 UTC