多模态生成
共 372 个仓库 · 一年内有推送
面向各类 Stable Diffusion 模型的高质量免训练图像修复方案,可作为 ComfyUI 自定义节点直接接入工作流,无需额外训练即可完成局部重绘。
在 Apple Silicon Mac 上原生微调大模型的工具,基于 MLX 支持 SFT、DPO、GRPO 以及视觉、语音、OCR 等多模态训练,API 兼容 Unsloth。
汇总日语大语言模型资源的清单,涵盖基础模型与生成式模型,方便快速查找和对比日语 LLM 生态。
围绕 TTS 生成模型搭建的语音合成服务,提供 API Server 和 Gradio WebUI,方便快速部署和调用多种语音生成模型。
用计算图变换(如自动微分)加速飞行器设计优化,提供气动、推进、结构、轨迹设计等可组合分析工具,适合多学科设计优化场景。
开源图像编辑基础模型,能精准理解指令完成高保真修图,并保持人物身份一致、自然融合多元素,适合做图像编辑训练与微调。
面向开发者的模型优化框架,能对扩散模型、LLM、语音识别等模型做压缩加速,以极低改造成本换来更快、更省资源的推理。
基于条件流匹配的快速非自回归语音合成架构,用更少采样步数生成高质量语音,适合搭建低延迟 TTS 系统。
面向扩散模型的可扩展、显存优化训练框架,基于 PyTorch 和 Diffusers,让大模型微调在有限显存下也能跑起来。

基于扩散模型的时间流逝视频生成模型,能把文本提示变成物体随时间逐渐变形的延时视频,还配套了专门的延时数据集。
汇总统一多模态模型的开源资源清单,涵盖图文生成、视觉语言模型等方向,方便快速查找和对比各类多模态大模型。
跨 macOS 和 Windows 的实时语音翻译桌面应用,本地运行无需服务器,用自己的 API key 完成语音识别与翻译,并免费合成语音。
本地离线跑图像生成、实时语音对话和 LLM 聊天机器人的桌面推理引擎,数据不出本机,适合注重隐私的创作与自动化工作流。
从零构建的免费开源、无审查图像描述视觉语言模型,专为扩散模型训练生成高质量图片说明。

把 RVC、F5-TTS、Chatterbox、IndexTTS-2 等十多种本地语音合成与变声引擎集成进 ComfyUI,支持多语言、超长文本、SRT 时间轴和角色音色,一站式完成配音与音频编辑。

轻量级多模态模型库,能同时理解多语言文本和图像,速度比 OpenAI CLIP 和 LLaVA 快 5 倍,适合做图文检索和内容生成。
拆解抖音爆款知识短片,自动生成导演分镜表、配音效并一键出片,适合批量做知识类短视频。

开源多模态训练框架,基于 Qwen3 等底座训练视觉语言模型,降低多模态模型训练门槛。
支持普通话、粤语、藏语的中文语音合成引擎,可离线把文本转成语音,适合做多语言 TTS 应用。
MeanFlow 与 iMF 的 PyTorch 实现,用一步生成建模替代多步扩散采样,让图像生成推理更快。
本地免费运行的一站式 AI 视频与图像编辑工具,集换脸、口型同步、抠图去物、风格重绘、人声分离与克隆、视频生成于一体。
面向机器人导航的开源平台,用多模态大模型和视觉语言动作模型构建通用导航基础模型,解决跨场景视觉导航与空间智能问题。
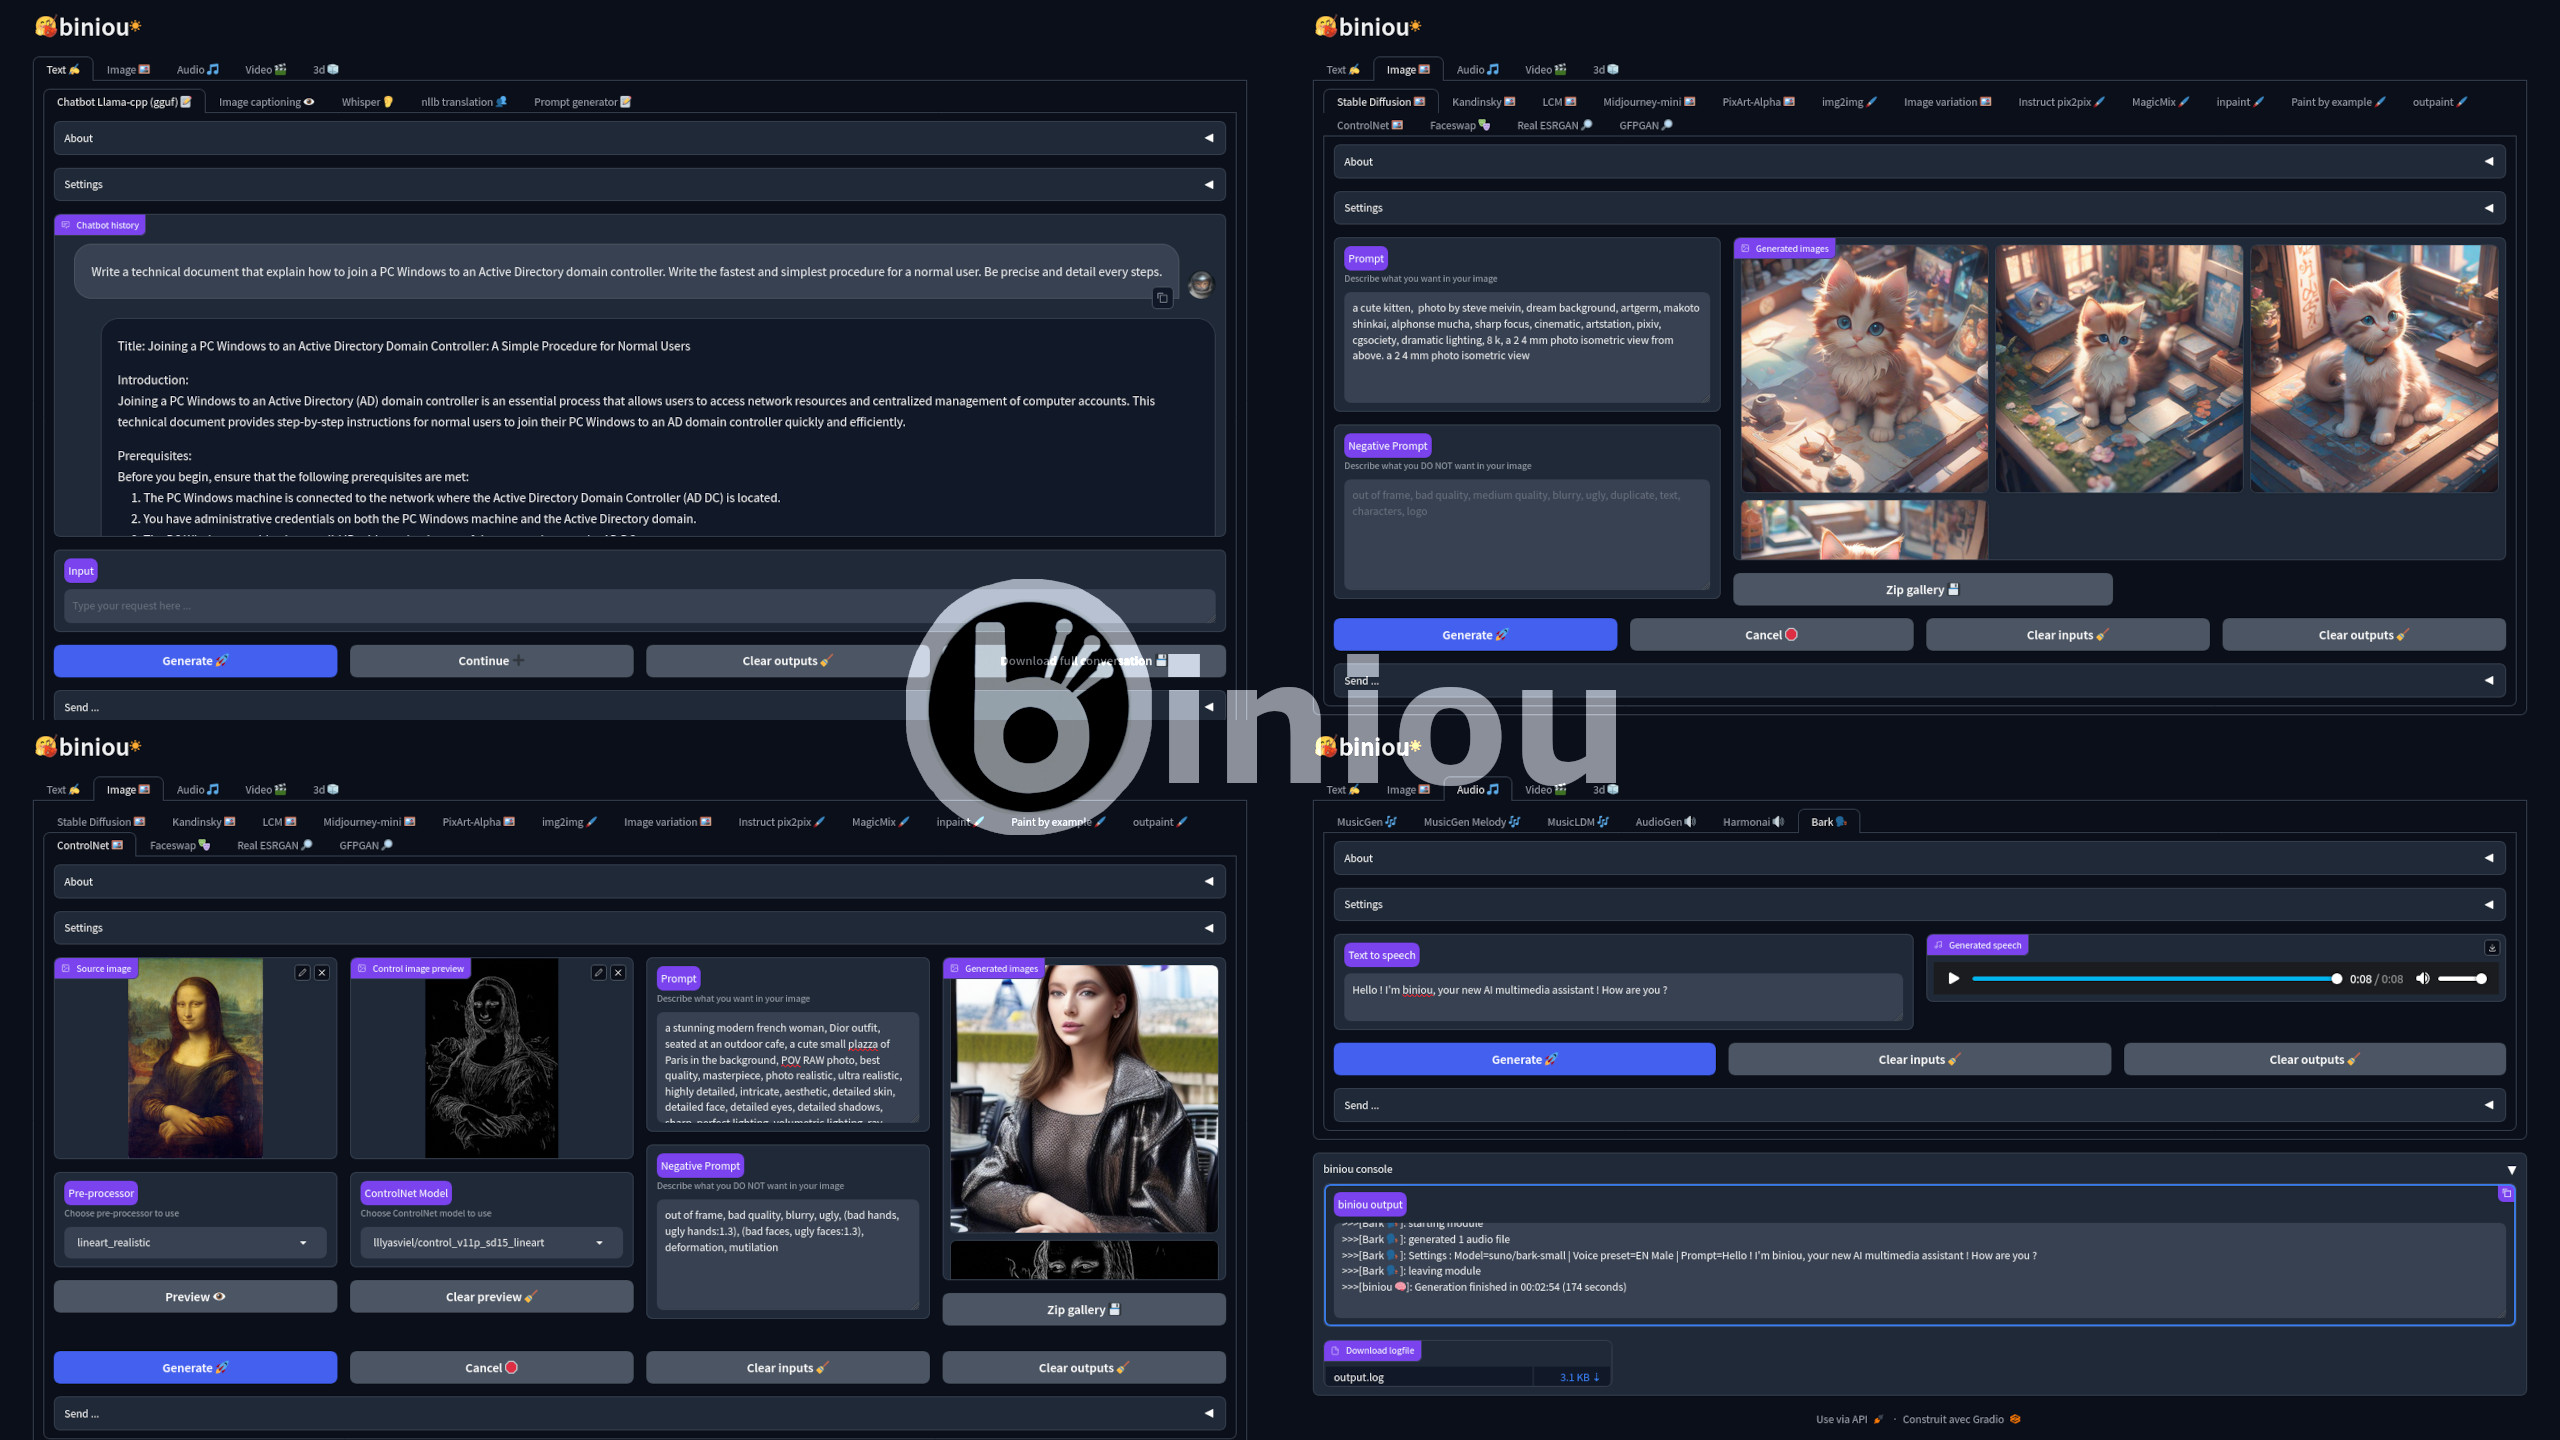
自托管的生成式 AI 网页界面,集成 30 多种模型,覆盖图像、视频、音频生成,用浏览器就能统一调用,省去逐个搭建环境的麻烦。
单模型同时生成画面与声音的基座模型,解决视频和音频分开生成后不同步的问题,适合做带声视频创作。