多模态生成
共 290 个仓库 · Python

面向通用机器人策略的空间引导视觉-语言-动作框架,把视觉语言模型和动作输出打通,让机器人能按空间指令执行操作任务。
把生成模型里隐含的 3D 先验知识迁移到场景理解任务上,让视觉语言模型在空间推理时更懂三维结构。
把多模态大模型变成能调度各类计算机视觉任务的通用路由器,用指令调优统一处理检测、分割等任务,免去为每个任务单独建模。
RecA 用自监督学习让多模态模型在生成图像时借助自身的视觉理解能力,提升文生图和图像编辑的效果,可接入 ComfyUI 使用。
为 Hugging Face diffusers 提供注意力图提取与可视化工具,方便查看 Stable Diffusion 文生图时文本如何影响图像区域。
让视觉语言模型在推理时生成连续视觉 token 作为中间思考步骤,提升看图与推理表现,附带 ECCV 2026 论文官方实现。
Stable Flow 是 CVPR 2025 论文的官方实现,利用扩散模型中的关键层实现免训练的图像编辑,无需微调即可对生成图做可控修改。
MagicBrush 是 NeurIPS'23 发布的人工标注指令引导图像编辑数据集,为训练和评测文本指令驱动的图像编辑模型提供高质量数据。
VideoPrism 是 DeepMind 开源的视频理解基础视觉编码器,用自监督学习预训练,可直接抽取视频特征,支撑分类、检索、问答等下游任务。
用 torchao 和 diffusers 优化扩散模型的端到端教程,覆盖推理加速和 FP8 训练,帮你在 Flux 等文生图模型上省显存、提速度。
把 Stable Diffusion 等扩散模型用 BentoML 打包成可部署的推理服务,支持 LoRA 微调权重和 Kubernetes 部署,省去自己搭服务框架的麻烦。
RISE 用组合式世界模型让机器人策略自我进化,通过生成模型与价值学习提升操作任务表现,适合研究机器人学习与 VLA 的团队。
轻量高效的全模态强化微调框架,支持 GRPO、DAPO 等算法,用奖励模型驱动 LLM 和多模态 VLM 训练。
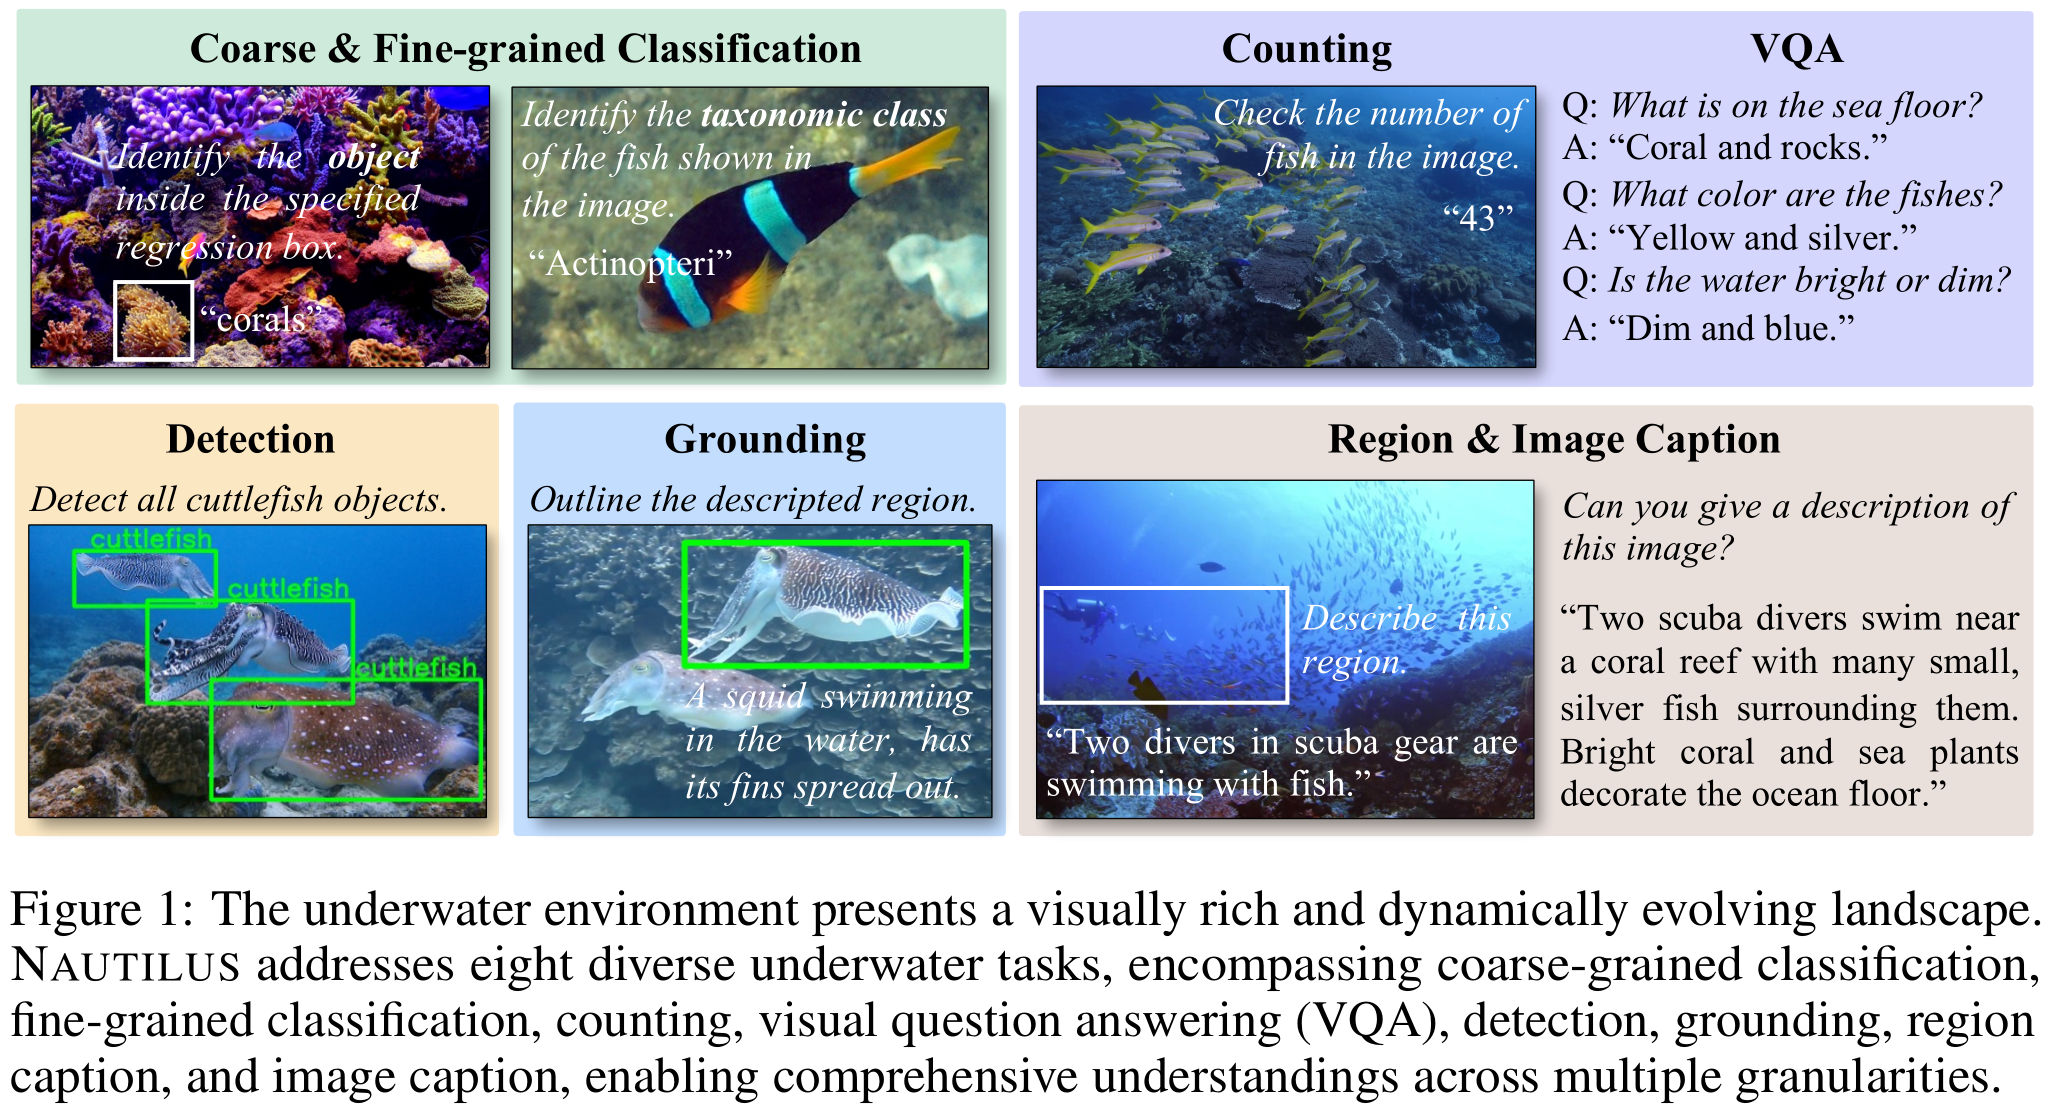
面向水下场景理解的大型多模态模型,能同时处理水下图像与文本,完成描述、问答等视觉语言任务,填补水下环境多模态研究的空白。
BAAI 推出的无编码器视觉语言模型系列,跳过独立视觉编码器,直接用语言模型处理图像与文本,简化多模态架构并支持指令跟随。
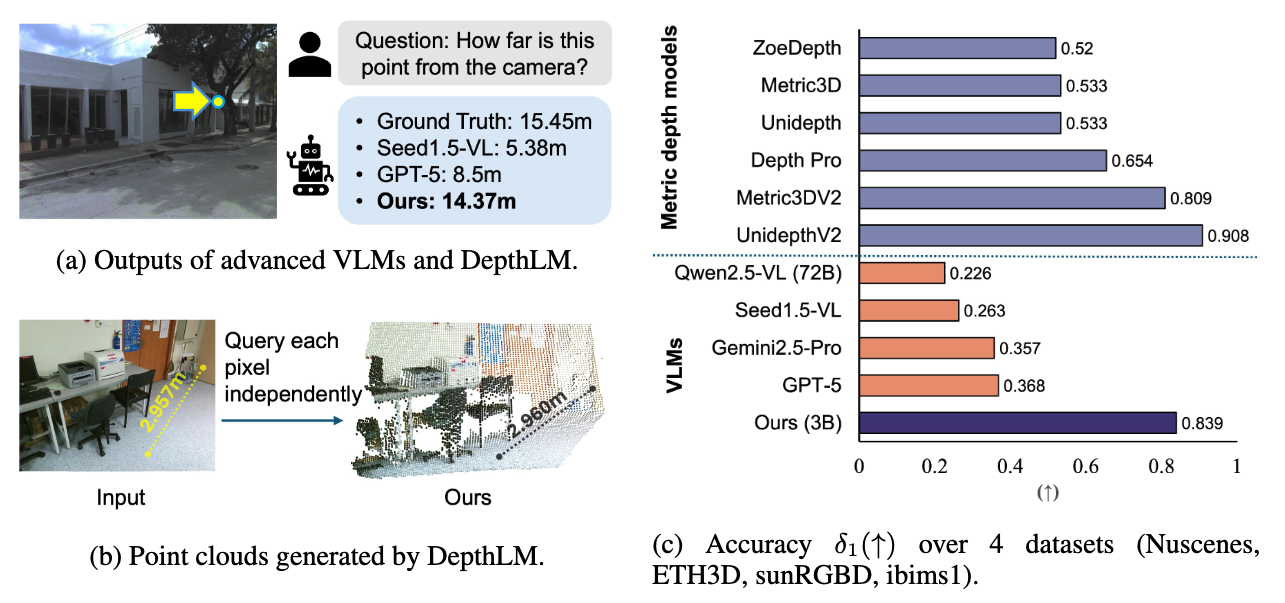
DepthLM 的官方实现,用视觉语言模型做单目深度估计,把深度预测转成语言建模任务,在 ICLR 2026 入选 Oral。
FLUX.1 Krea 官方开源仓库,提供基于扩散模型的文生图能力,可生成高质量图像。
在 Apple Silicon Mac 上离线跑 LTX-2.5 和 MiniMax H3,做带声音的文本/图片转视频、对口型和角色 LoRA 训练,不用云端和 API key。

首个开源的 JSON 原生文生图模型,用结构化 JSON 输入实现可控、可预测且版权合规的图像生成。
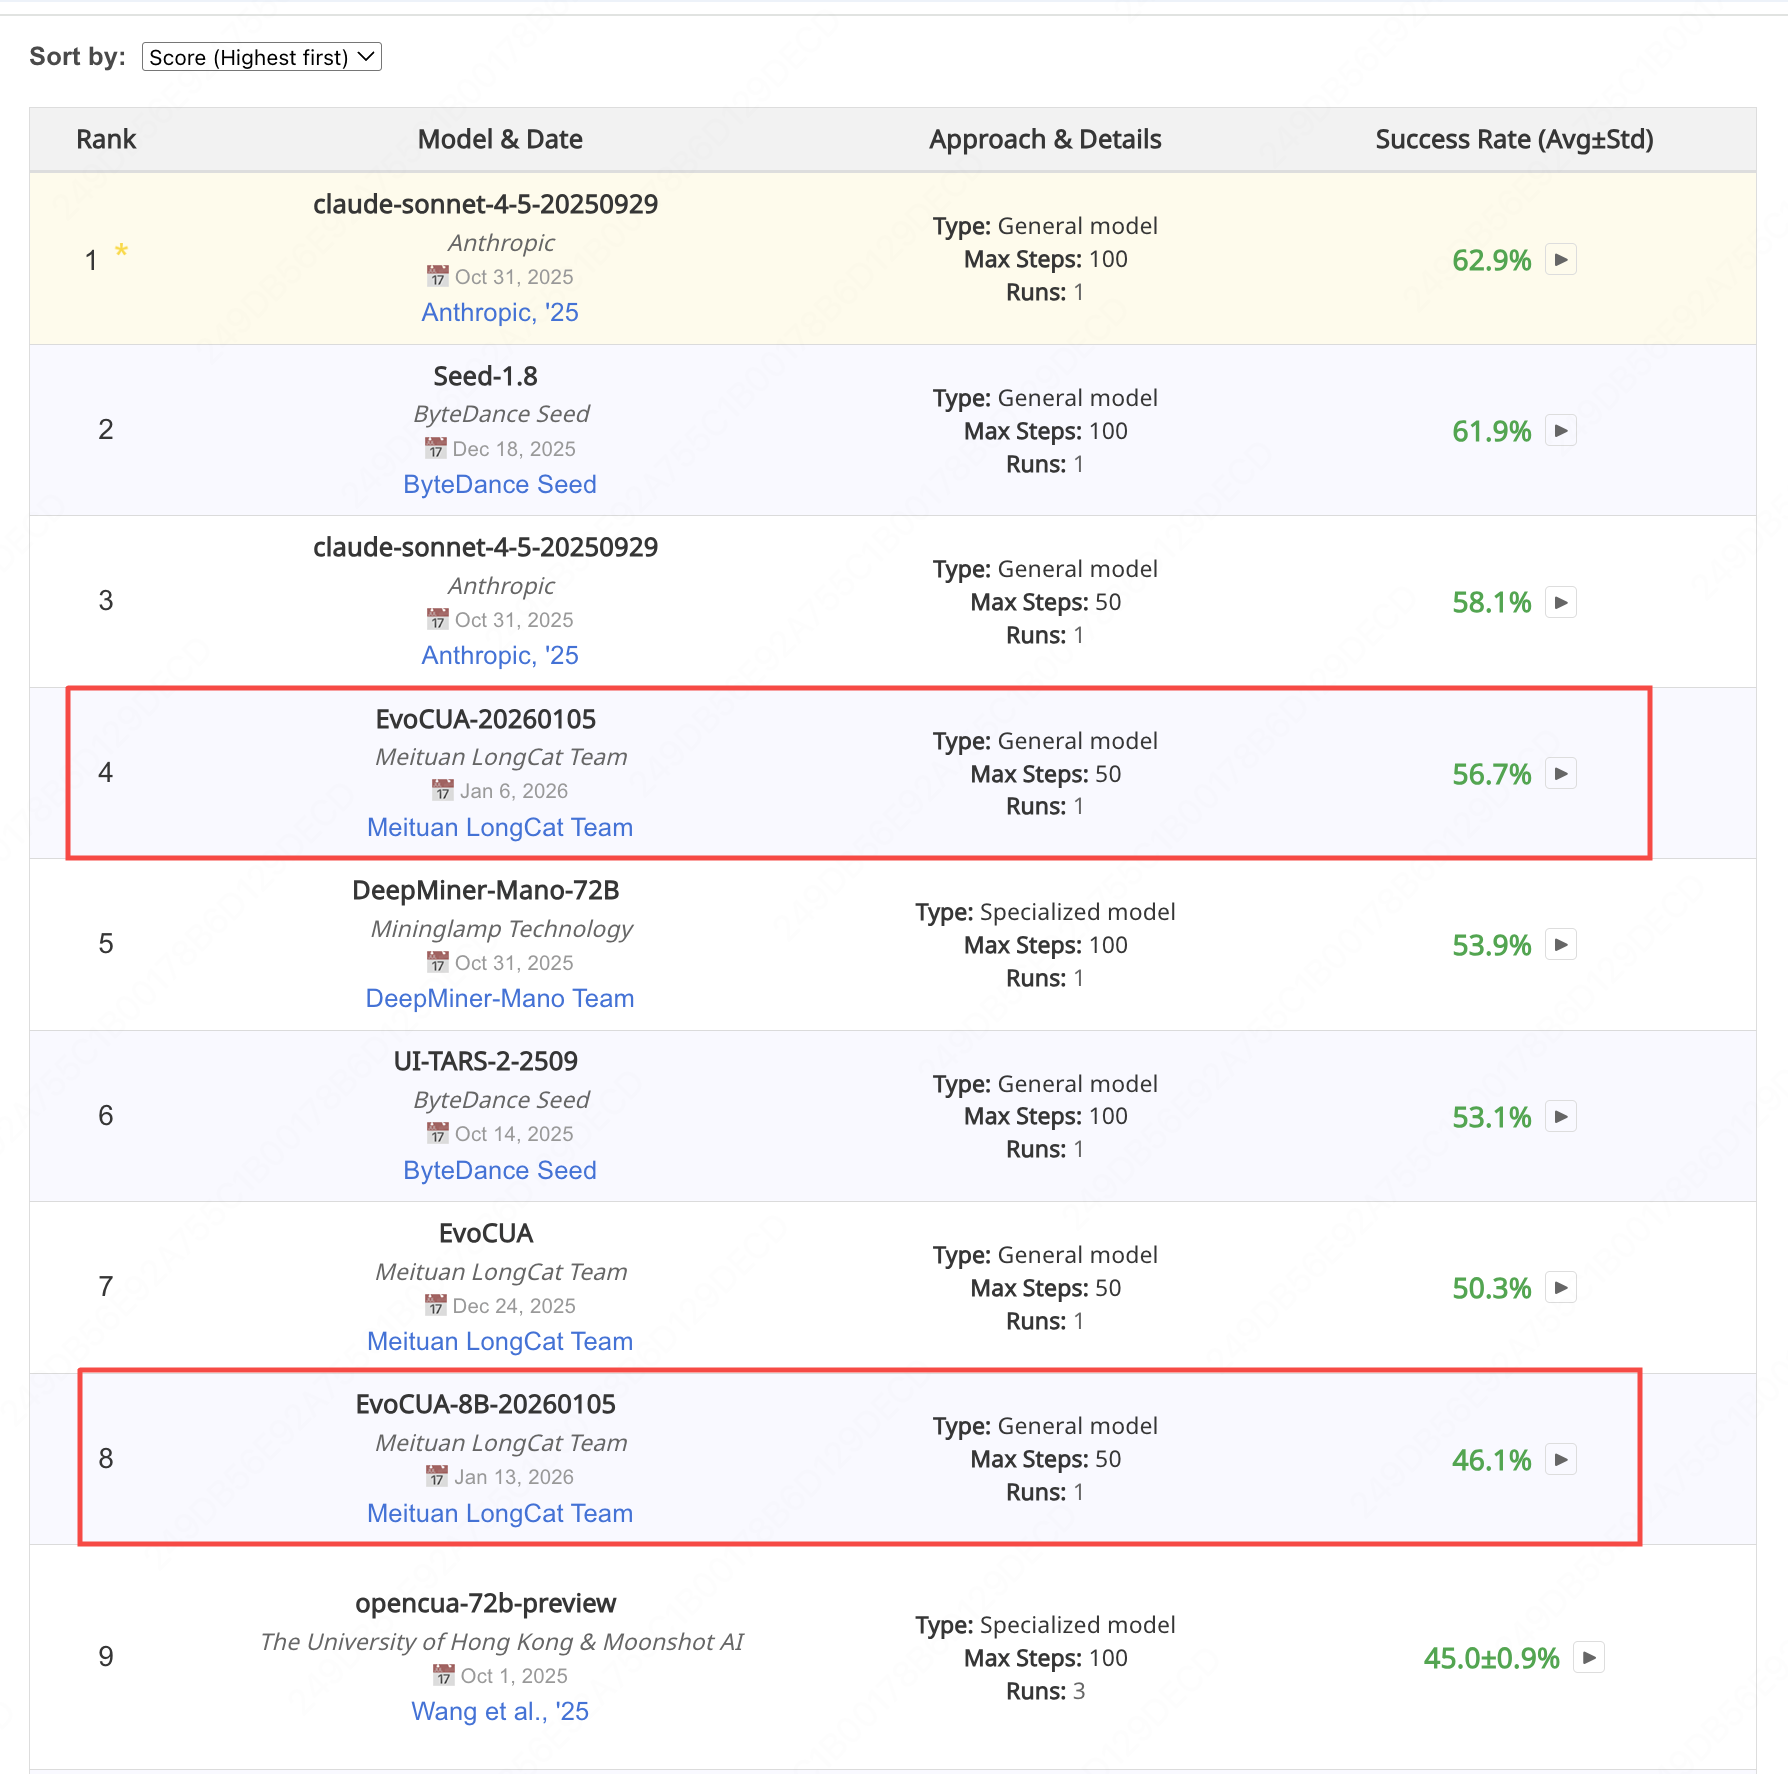
EvoCUA 是一个可自我进化的计算机使用智能体,基于视觉语言模型理解图形界面并自动完成操作任务。
用强化学习把目标检测、分割、计数等视觉感知任务统一进多模态大模型的推理流程,让模型边推理边定位。
用逐步分组相对策略优化(Step-wise GRPO)训练多模态大模型做推理,提升视觉语言任务上的推理能力。
在保持前景细节不变的前提下,用参考图驱动扩散模型生成新场景,适合需要主体一致性的图像编辑与合成。
PromptKD 是 CVPR 2024 的官方 PyTorch 实现,用无监督提示蒸馏把大视觉语言模型的能力迁移到小模型上,免去人工标注。